カバーレター
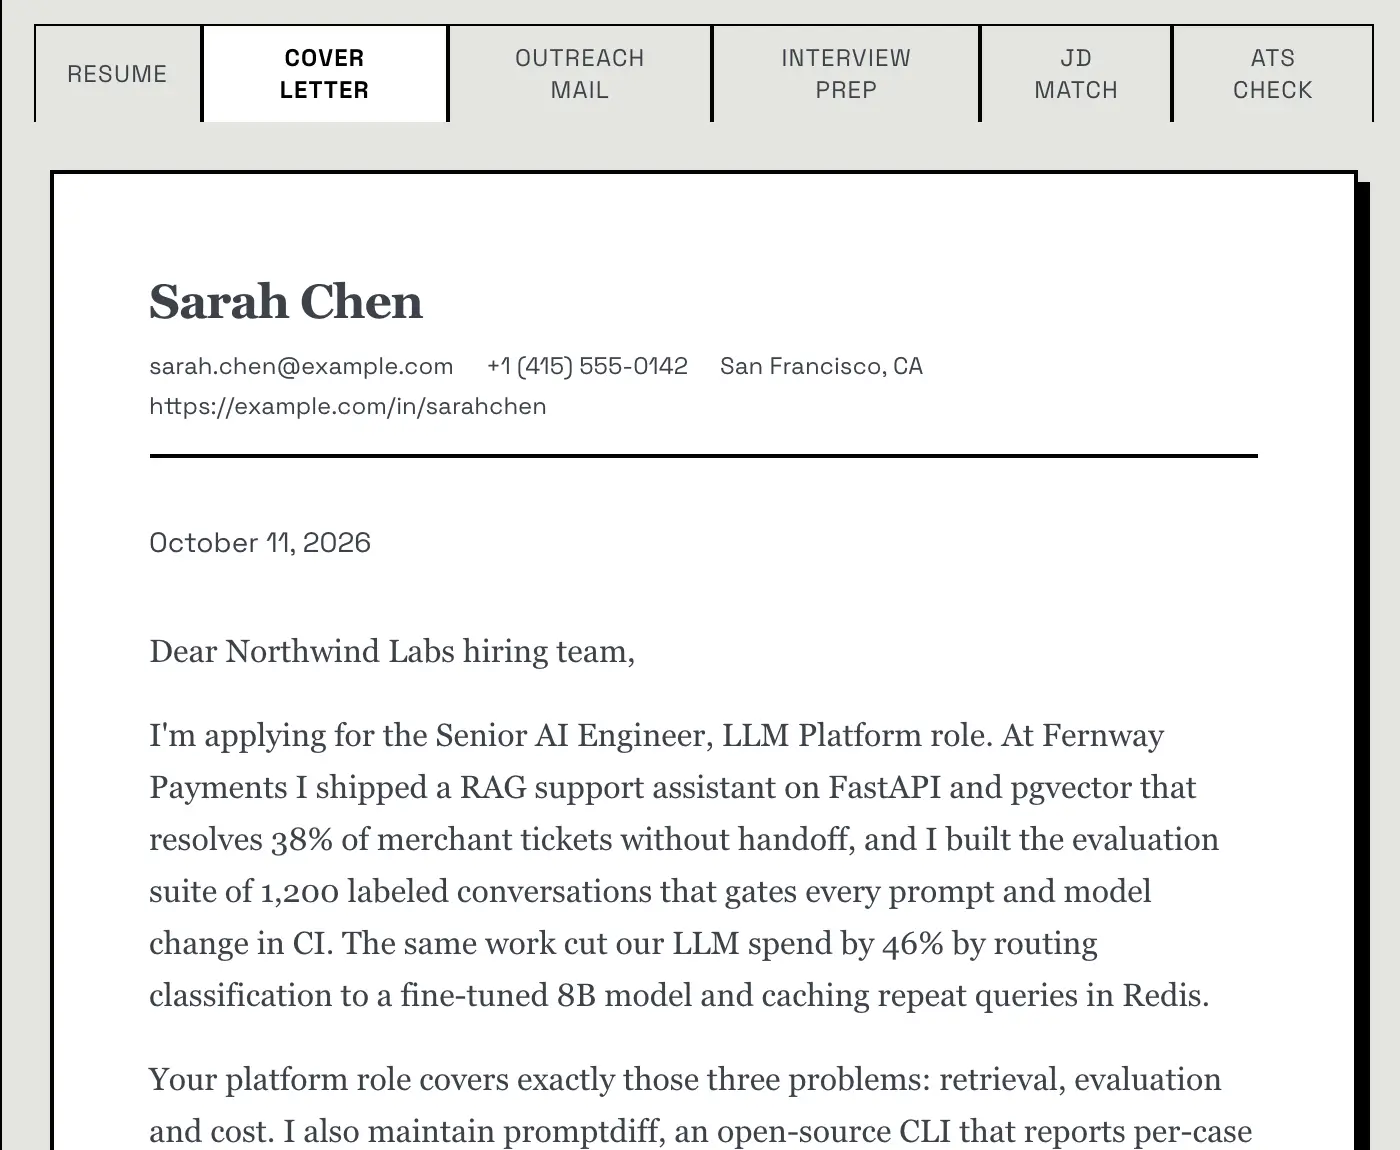
履歴書をもとに特定の求人に向けて書く、100〜150 語の短いレターです。プロンプトは、履歴書にないことを作り出さないようモデルに指示しています。印刷レイアウトの横で編集し、保存、再生成、または PDF でダウンロードします。日本企業への応募では一般的ではなく、外資系や海外への応募で役立ちます。
Resume Matcher のすべての機能を、使う順に。求人内容を貼り付け、AI が提案する変更をすべて確認し、ビルダーで履歴書を仕上げ、カバーレターを書いて、応募を管理します。自分のマシンで、自分で選んだ AI モデルを使って。
AI モデルを接続。設定で、自分の API キーを使うクラウドプロバイダーか、ローカルモデルを。
マスター履歴書を追加。PDF か Word のファイルをアップロードするか、履歴書ウィザードで作成。
求人内容を貼り付け。AI がマスター履歴書への的を絞った編集を提案します。
変更を確認。変更前と変更後のプレビューで確認し、確定するか再生成します。
ビルダーで仕上げ。テンプレートを選び、レイアウトを調整し、何でも編集。
関連書類を生成。同じ求人に向けたカバーレター、連絡メール、面接準備。
ダウンロード。履歴書とカバーレターを PDF で。
応募を管理。カンバンボードで。カスタマイズ履歴書を確定すると、カードが自動で追加されます。
カスタマイズは、履歴書にすでにあることを言い換えるものです。経験を作り出すことはなく、カスタマイズ画面では、変更を読んで確定するまで何も保存されません。
2 ページ
デフォルトのページ数の上限。関連性の低い箇条書きから削って収めます
0
新しい数値:数値を加えた書き直しは元に戻されます
4 分
カスタマイズの実行の時間制限(デフォルト)
マスター履歴書は、カスタマイズしていない完全な履歴書です。すべての職歴、プロジェクト、スキルを 1 か所にまとめます。4 MB までの PDF、DOC、DOCX をアップロードすると、AI が編集できる構造化されたセクションに変換し、元のテキストのコピーも残します。スキャンした画像だけの PDF はテキスト層がないため受け付けられません。先に OCR にかけてください。
履歴書のファイルがない場合は、履歴書ウィザードが 1 問ずつ、最大 15 問を質問し、回答に合わせてライブ下書きで履歴書を組み立てます。勤務先、役職、日付、学位、資格、数値、ツール、スキルを決して作り出さないよう指示されています。
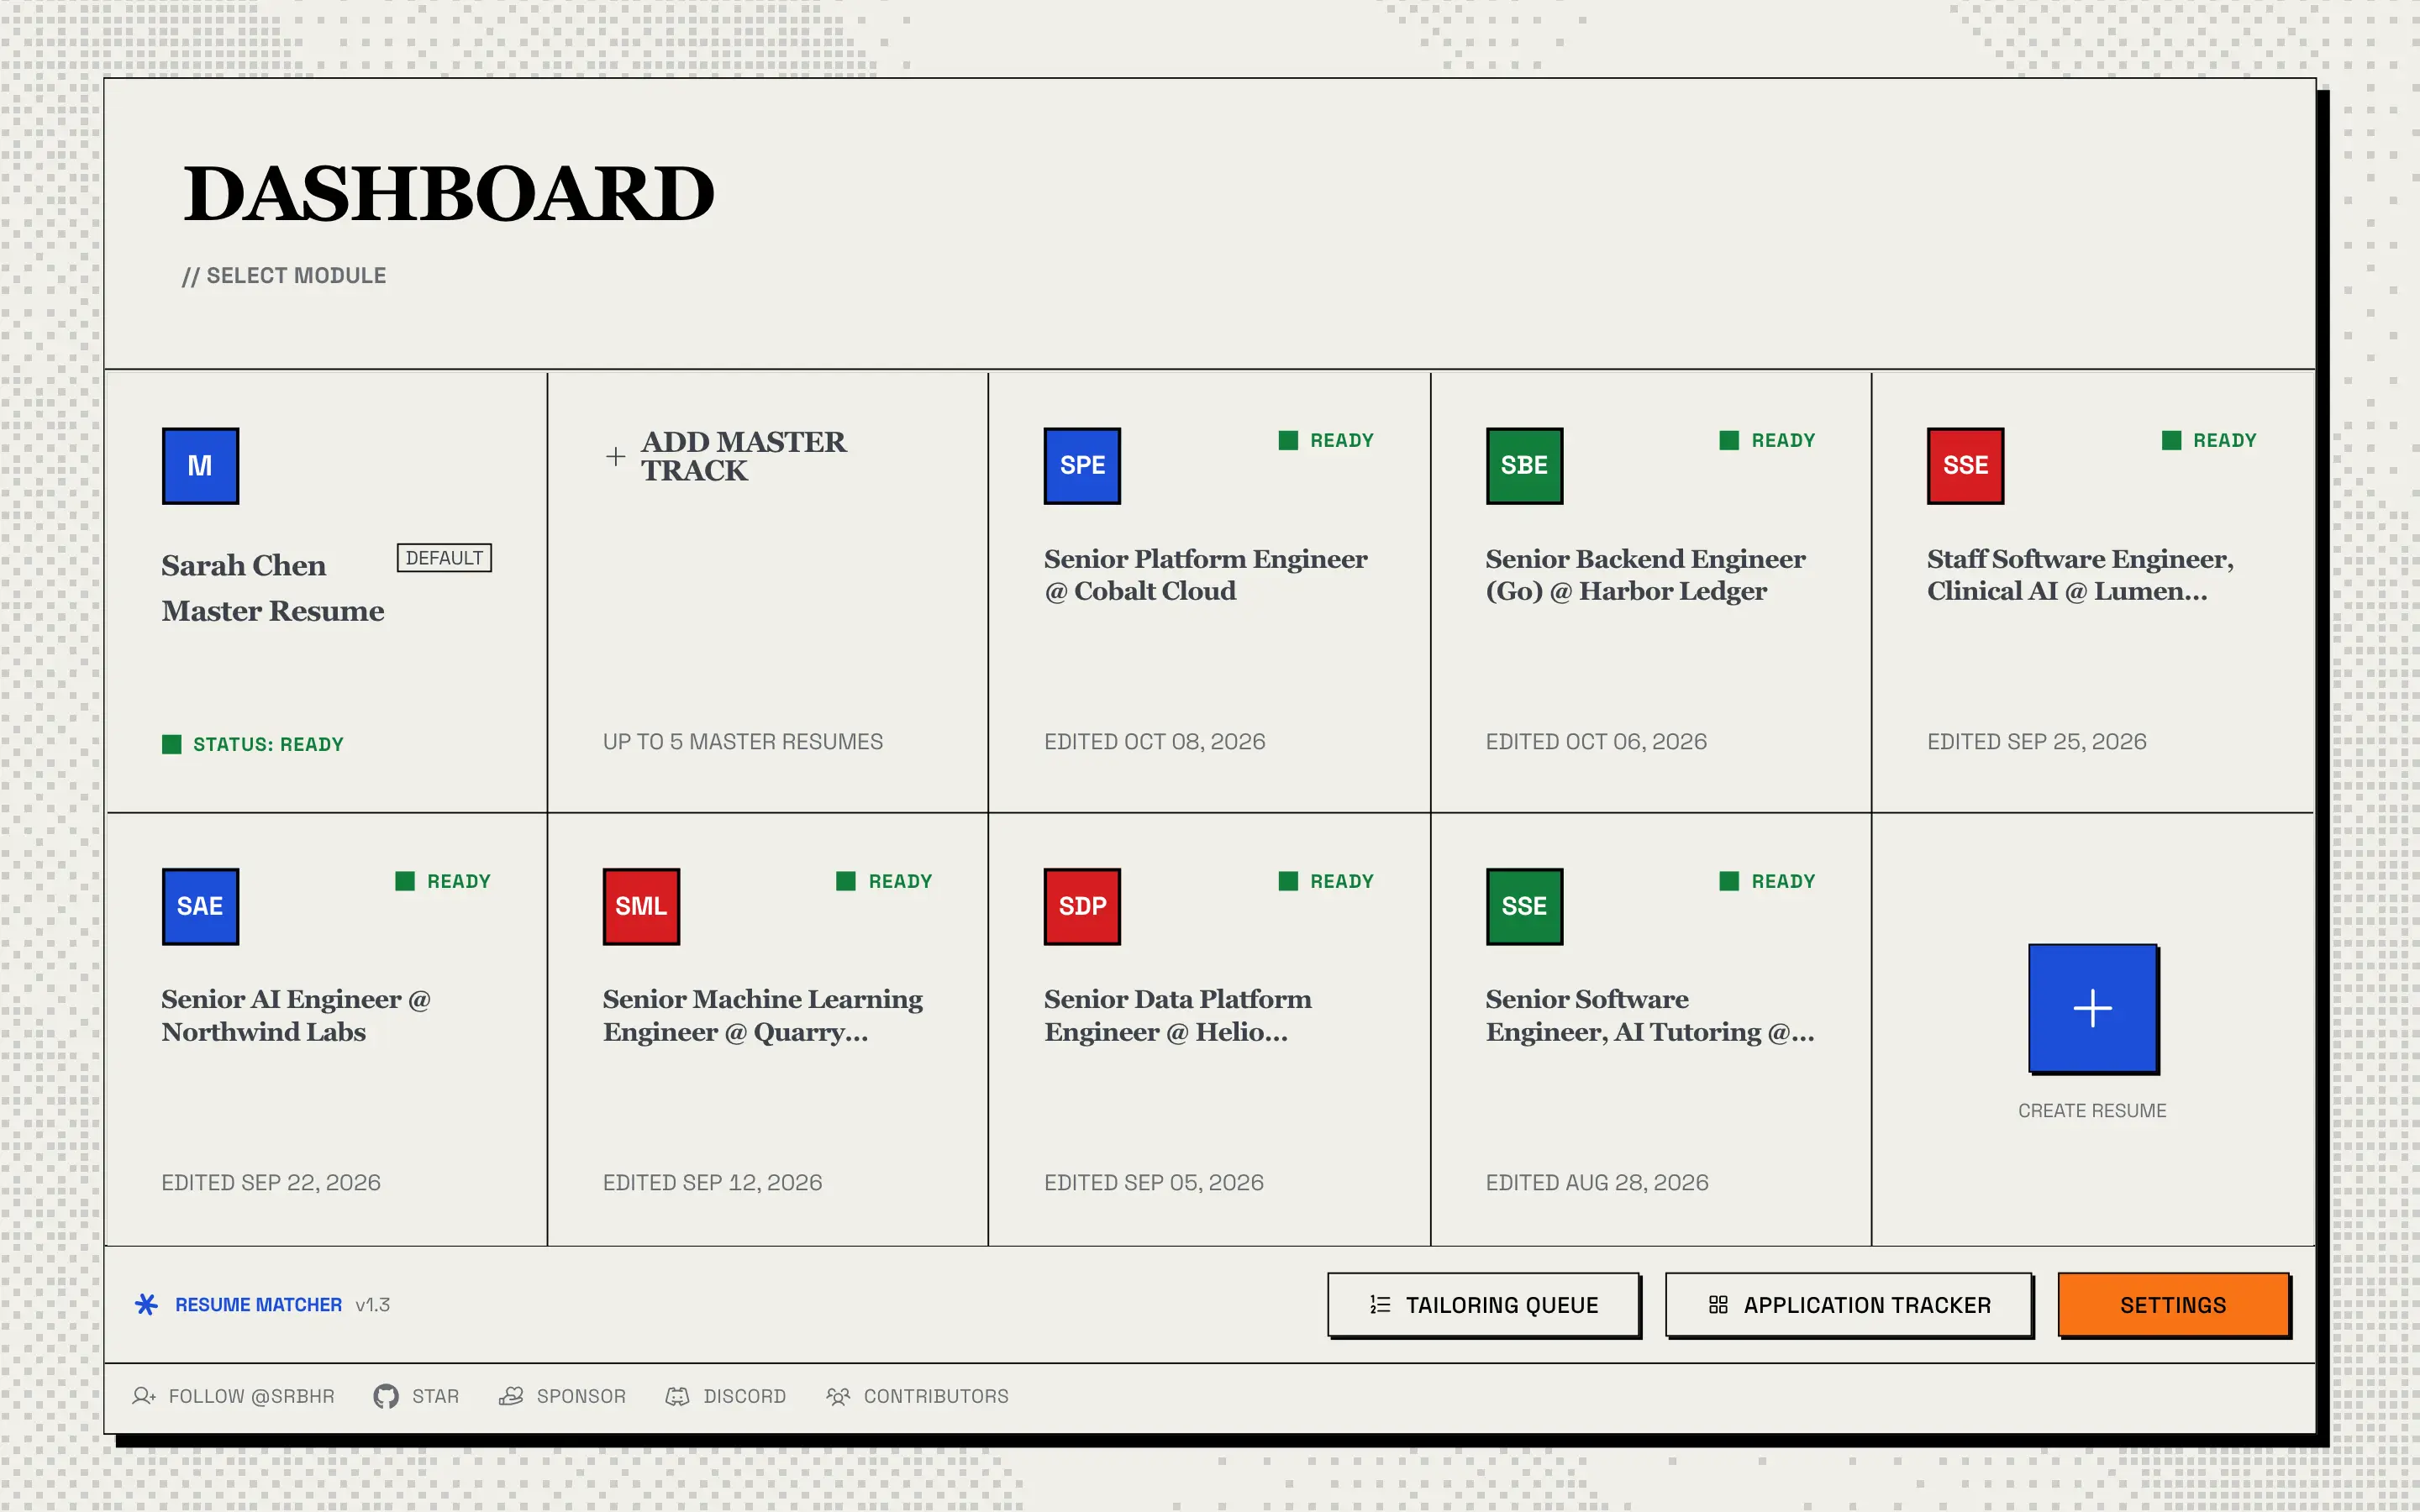
マスター履歴書はキャリアトラックとして最大 5 件まで持てます。たとえばバックエンド職向けと ML 職向けです。デフォルトは常に 1 件で、カスタマイズ画面はそこから始まります。
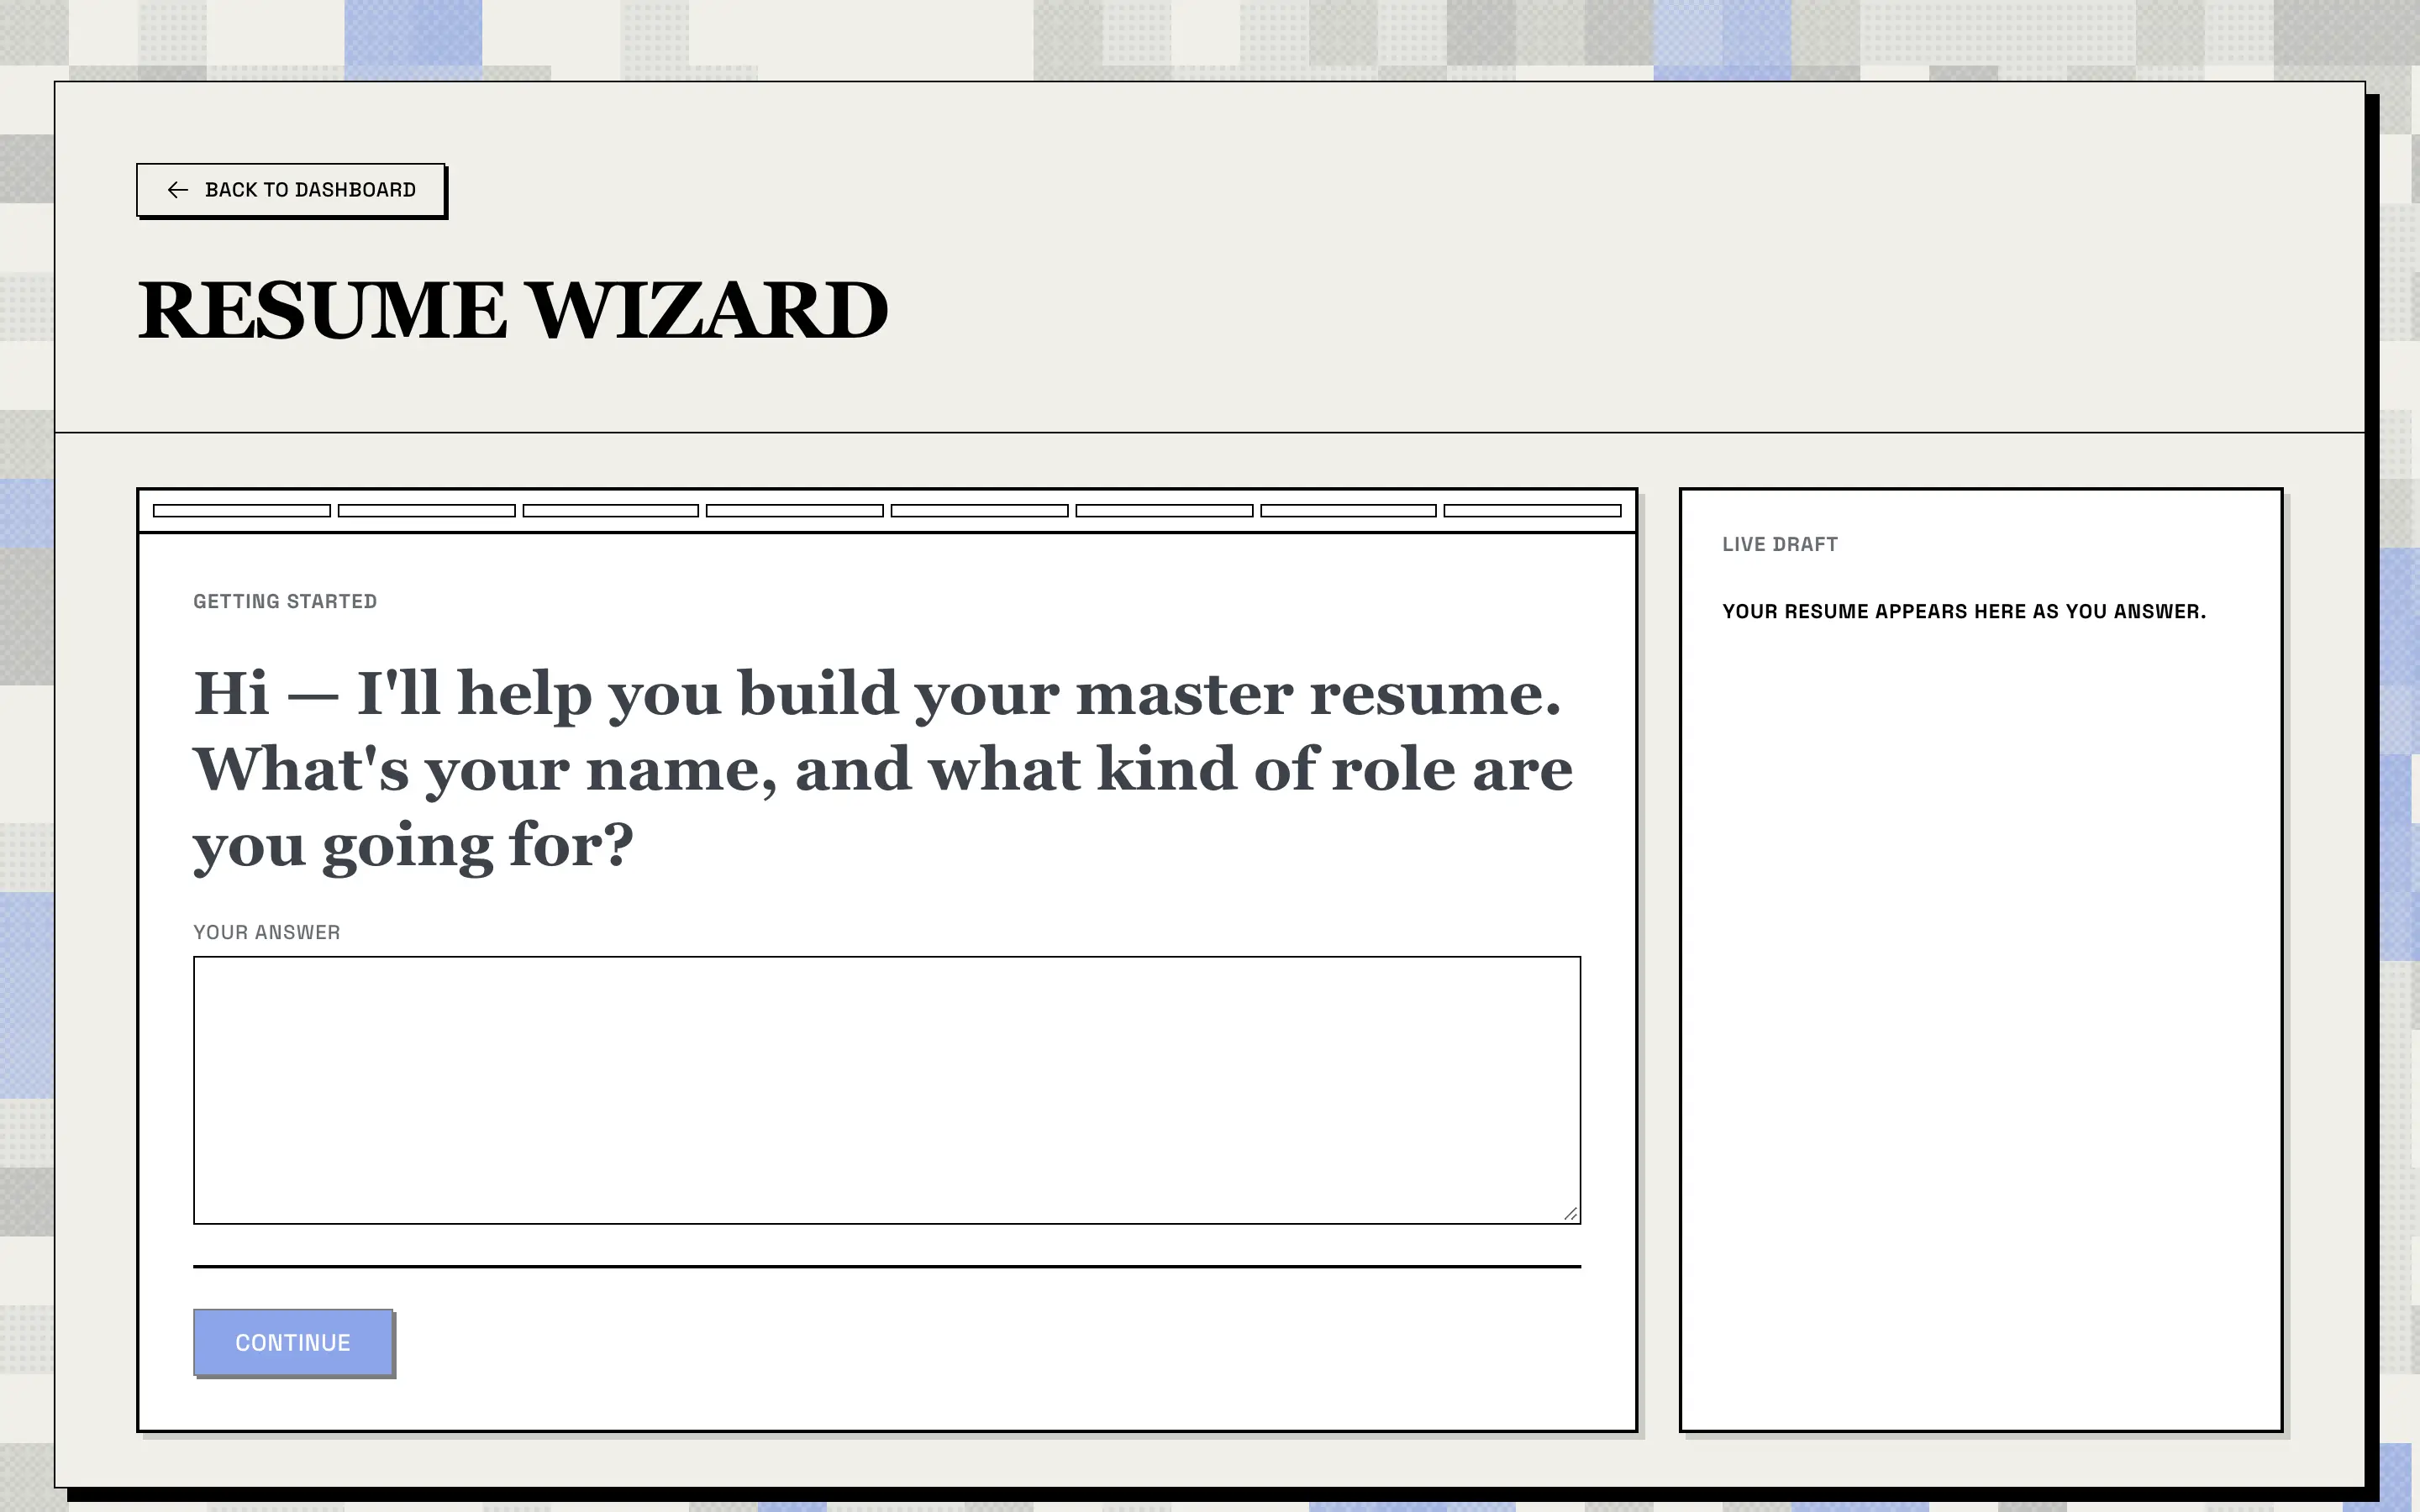
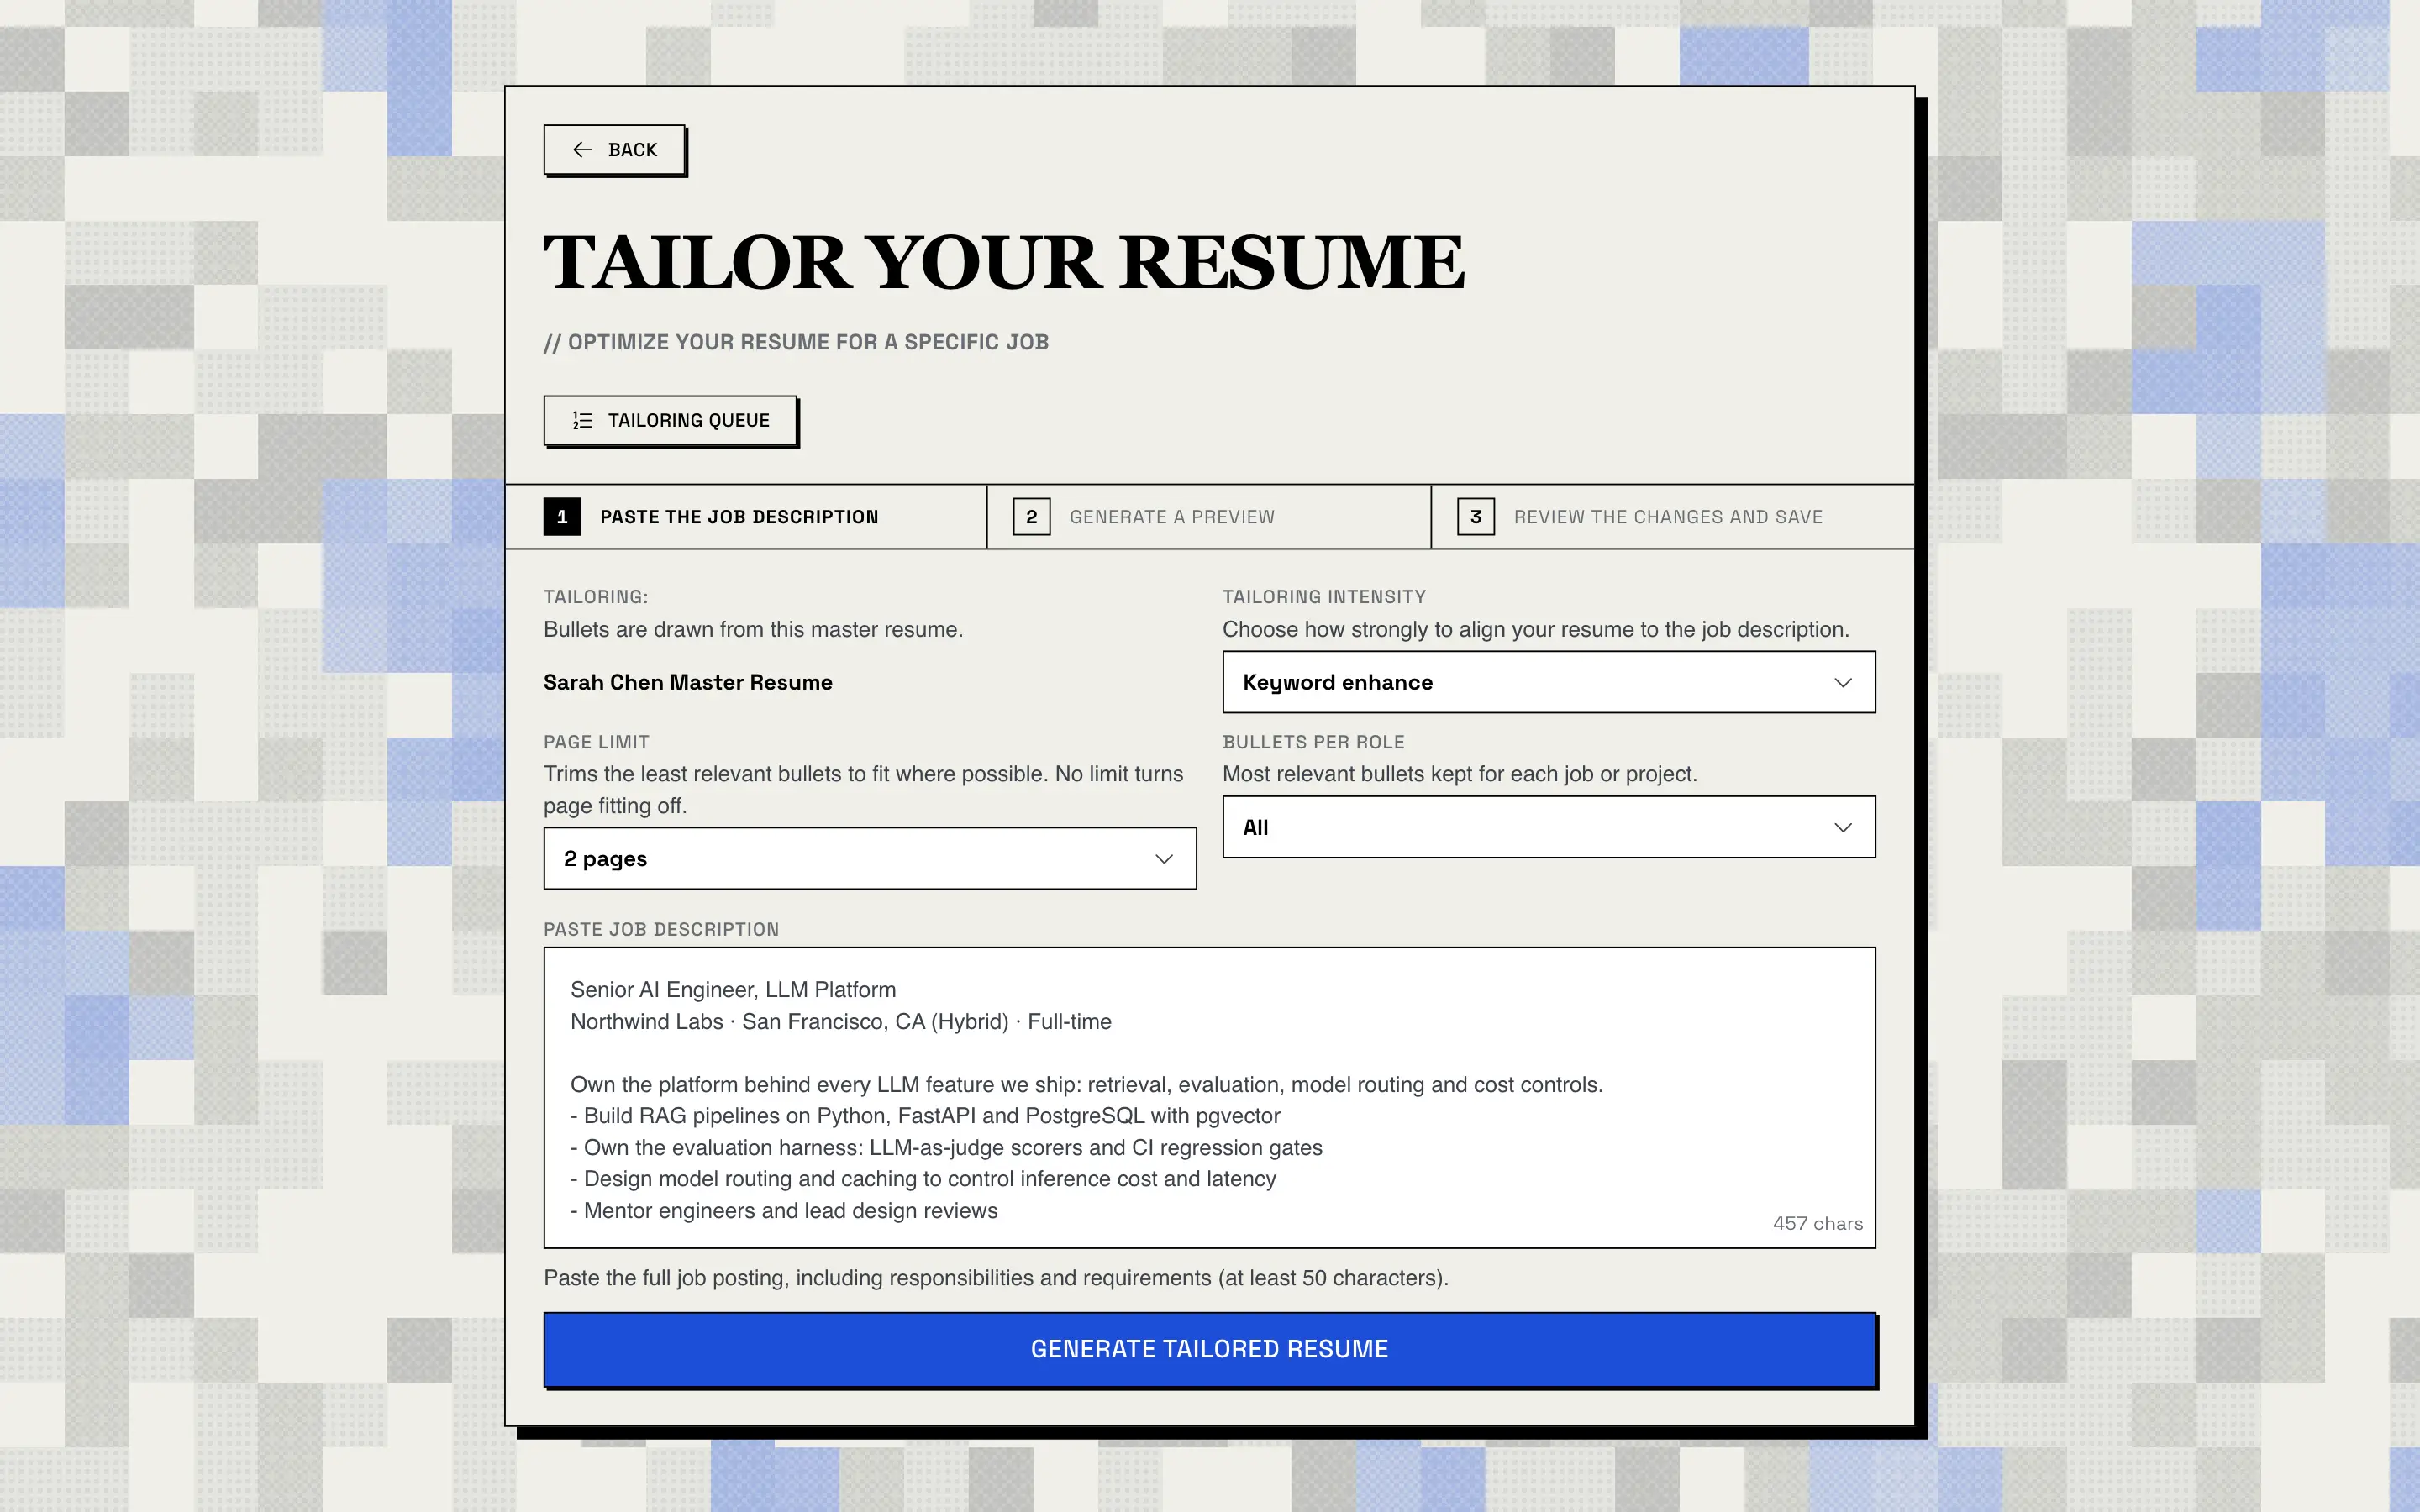
調整の強さを選び、ページ数の上限(1〜3 ページ、または上限なし)と職歴ごとに残す箇条書きの数を設定し、求人(最大 100,000 文字)を貼り付けて、「カスタマイズ履歴書を生成」をクリックします。
AI
AI が会社名、職種、必須スキルと歓迎スキル、主な業務、キーワードを抽出します。これらは求人と一緒に保存され、あとでトラッカーのカードに会社名と職種が表示されるのも、AI を再度呼び出さずにこの保存結果を使っているためです。
AI コード
AI が各箇条書きを求人との関連性で採点します。採点するだけで、箇条書きを書き換えたり作り出したりはできません。そのあとコードが、職歴やプロジェクトごとに上限まで関連性の高い箇条書きを残し、実際にページを描画しながら、ページ数の上限に収まるまで関連性の低いものを削ります。
AI コード
AI が強調するスキルを提案します。コードがスキルを受け入れるのは、すでに履歴書にあるか、履歴書の本文に出てくるか、求人内容に一字一句そのまま書かれた必須・歓迎スキルである場合だけです。
AI コード
AI は履歴書全体を書き直すのではなく、置き換える元の文を引用した具体的な編集の一覧を返します。コードはすべての引用を履歴書と照合し、保護された項目を狙った編集は却下します。
コード
コードは個人情報と日付を元に戻し、元のスキルをすべて残し、使い古された「AI っぽい」表現の一覧を取り除き(求人内容が使っている場合を除く)、元にない数値を持ち込んだ書き直しを元に戻します。
実行全体には時間制限(デフォルトは 4 分)があるので、遅いモデルでアプリが固まることはありません。
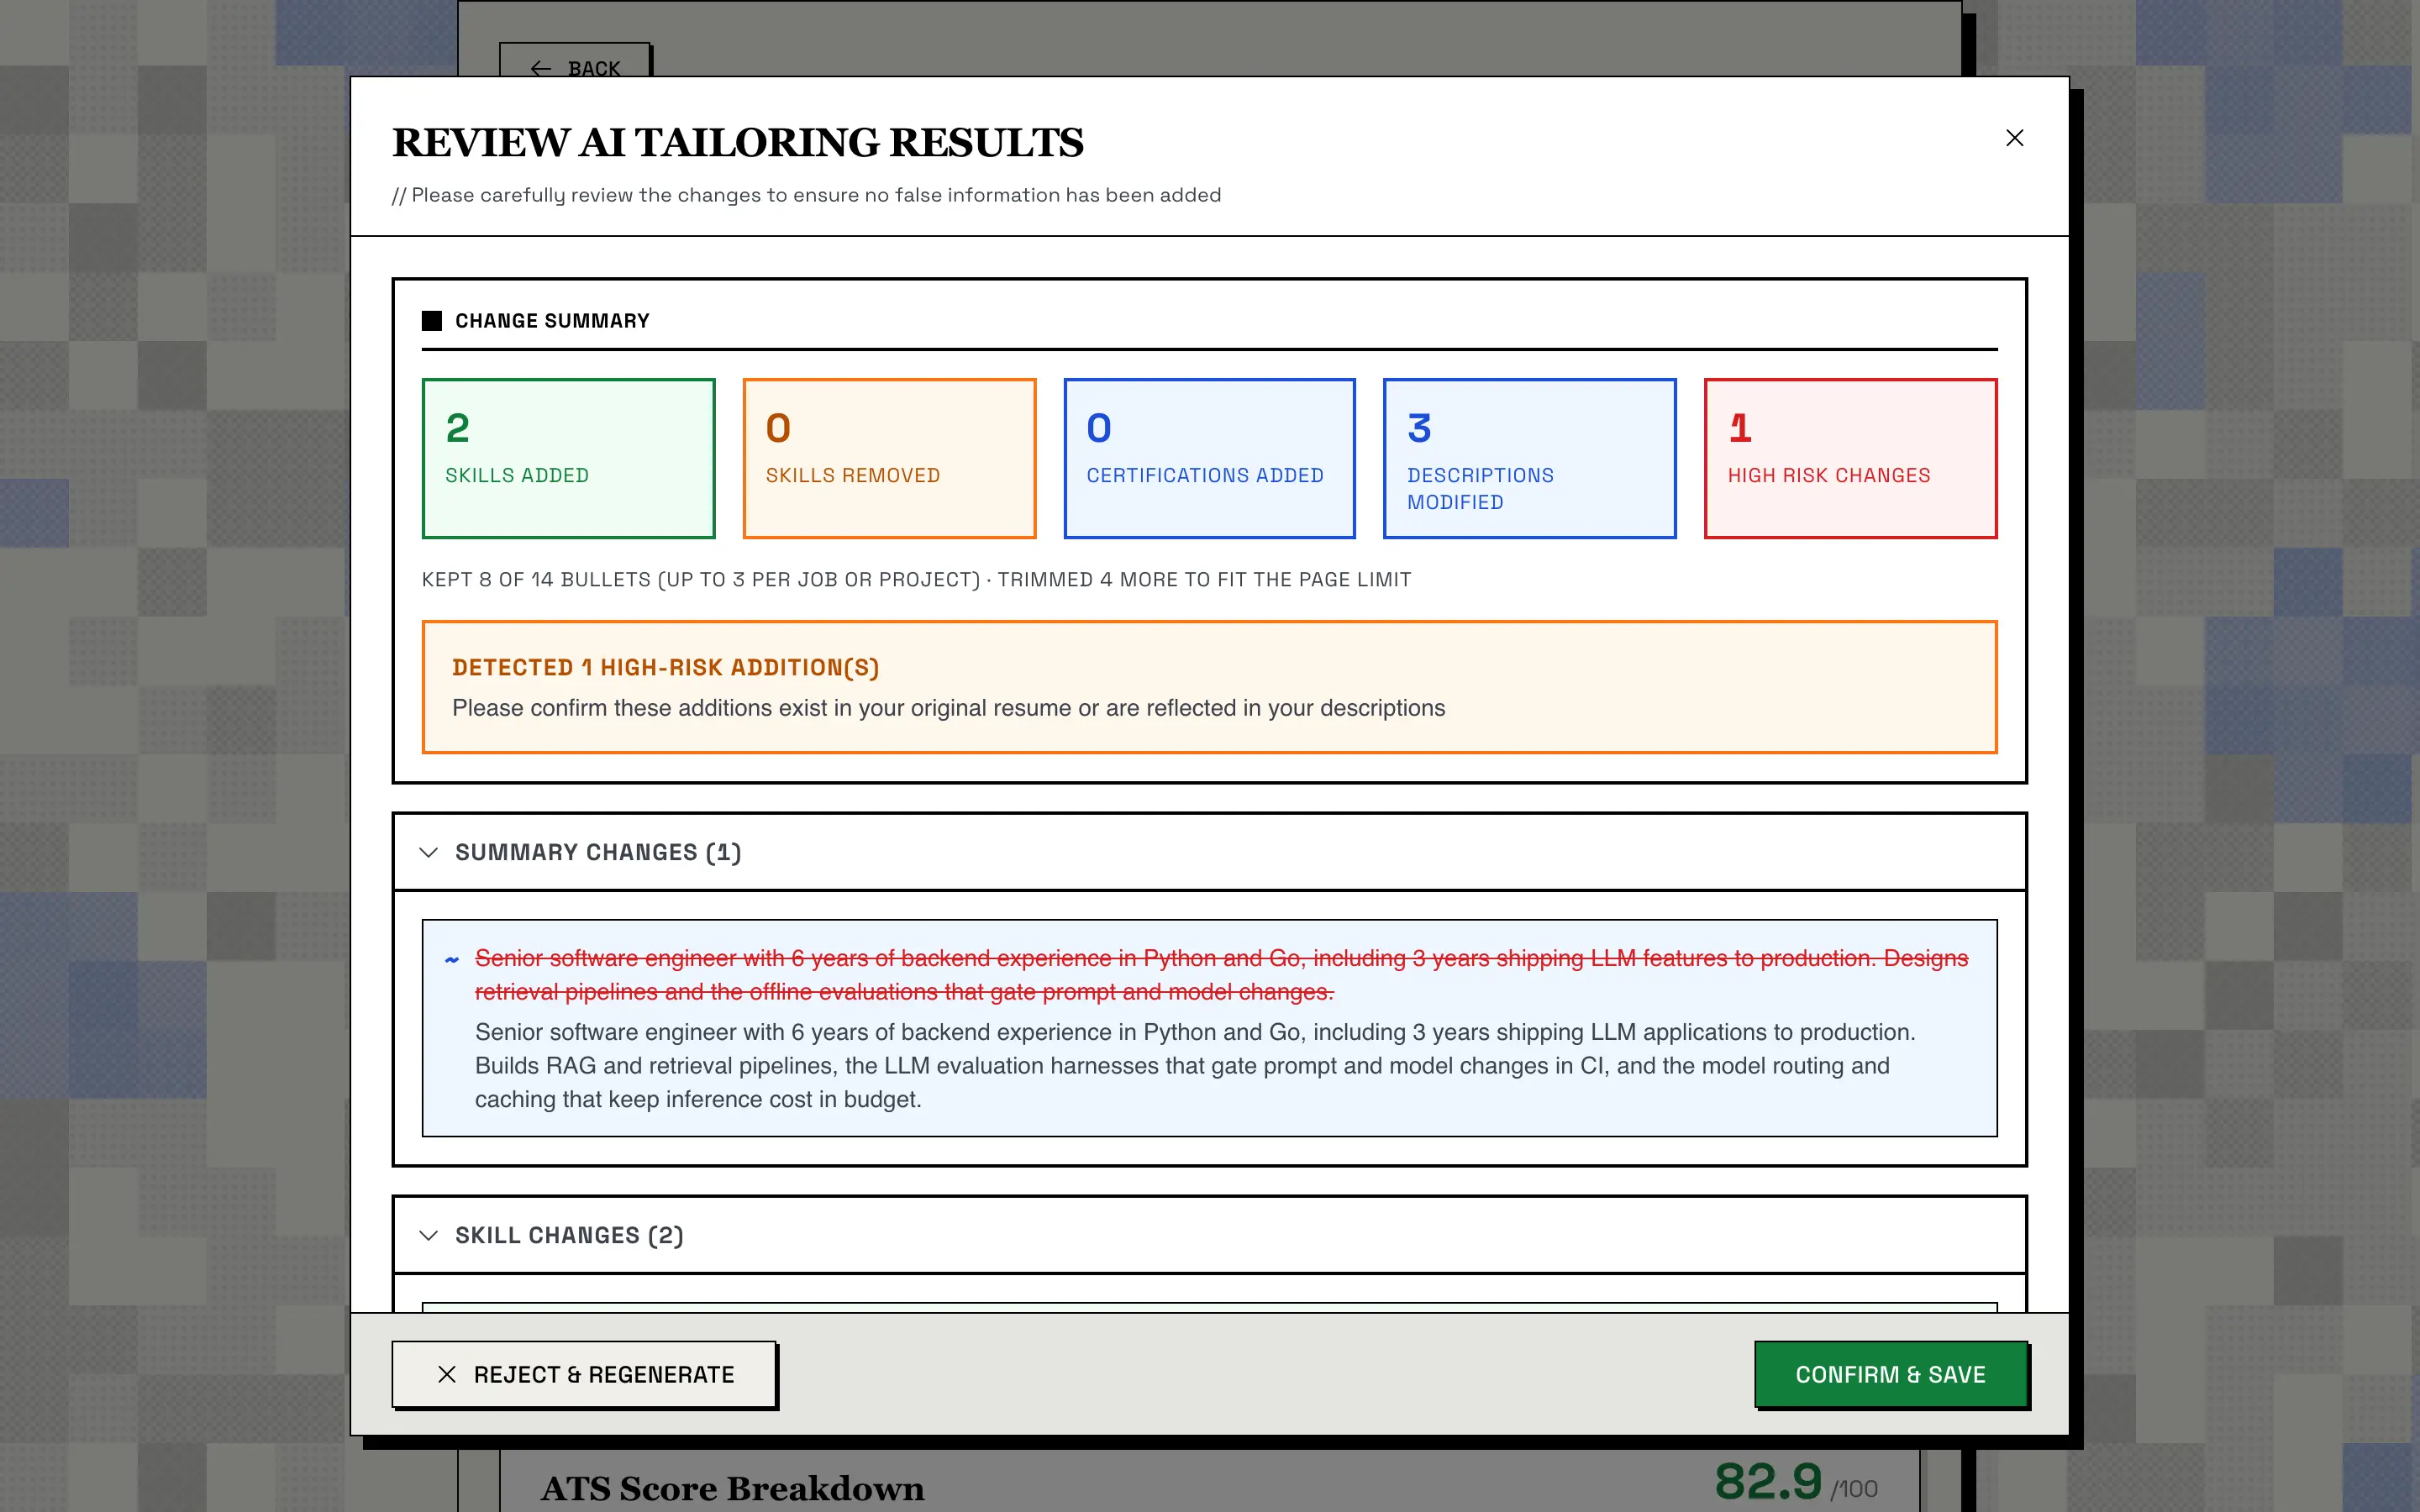
プレビューには次のものが表示されます。
変更の概要:追加・削除されたスキル、追加された資格、変更された説明、高リスクの変更。
箇条書きの選択で何が起きたか。たとえば「Kept 8 of 14 bullets (up to 3 per job or project) · Trimmed 4 more to fit the page limit」(14 件中 8 件を保持、ページ数の上限に収めるためにさらに 4 件を削除)。
AI が何かを追加したとき(多くは求人内容から取ったスキル)の高リスクの警告。自分に当てはまるか確認できます。
サマリー、スキル、変更された各箇条書きの変更前と変更後の差分。
確認して保存 で結果を残し、拒否して再生成 で破棄してやり直します。この判断はプレビュー全体に適用されます。安全策は作られた数値、勤務先、日付を防ぎますが、言い回しによってあなたの役割が誇張されることはありえます。すべての変更を読んでください。最後に確認するのはあなたです。
確定すると、カスタマイズ履歴書は「役職 @ 会社名」という名前の新しい履歴書として保存され、マスター履歴書と求人に紐づけられます。カードはトラッカーの「応募済み」列に追加され、設定でオンにしていれば、カバーレター、連絡メール、面接準備も一緒に生成されます。ビルダーですべて編集できます。
プレビューと一緒に、フォームの下に「ATSスコアの内訳」カードが表示されます。キーワード一致、スキルのカバー率、職種名の一致、セクションの充足度、日付の一貫性を重み付けしたヒューリスティックで、実在する応募者追跡システムのシミュレーションではありません。確定すると、カスタマイズ履歴書と一緒に保存されます。
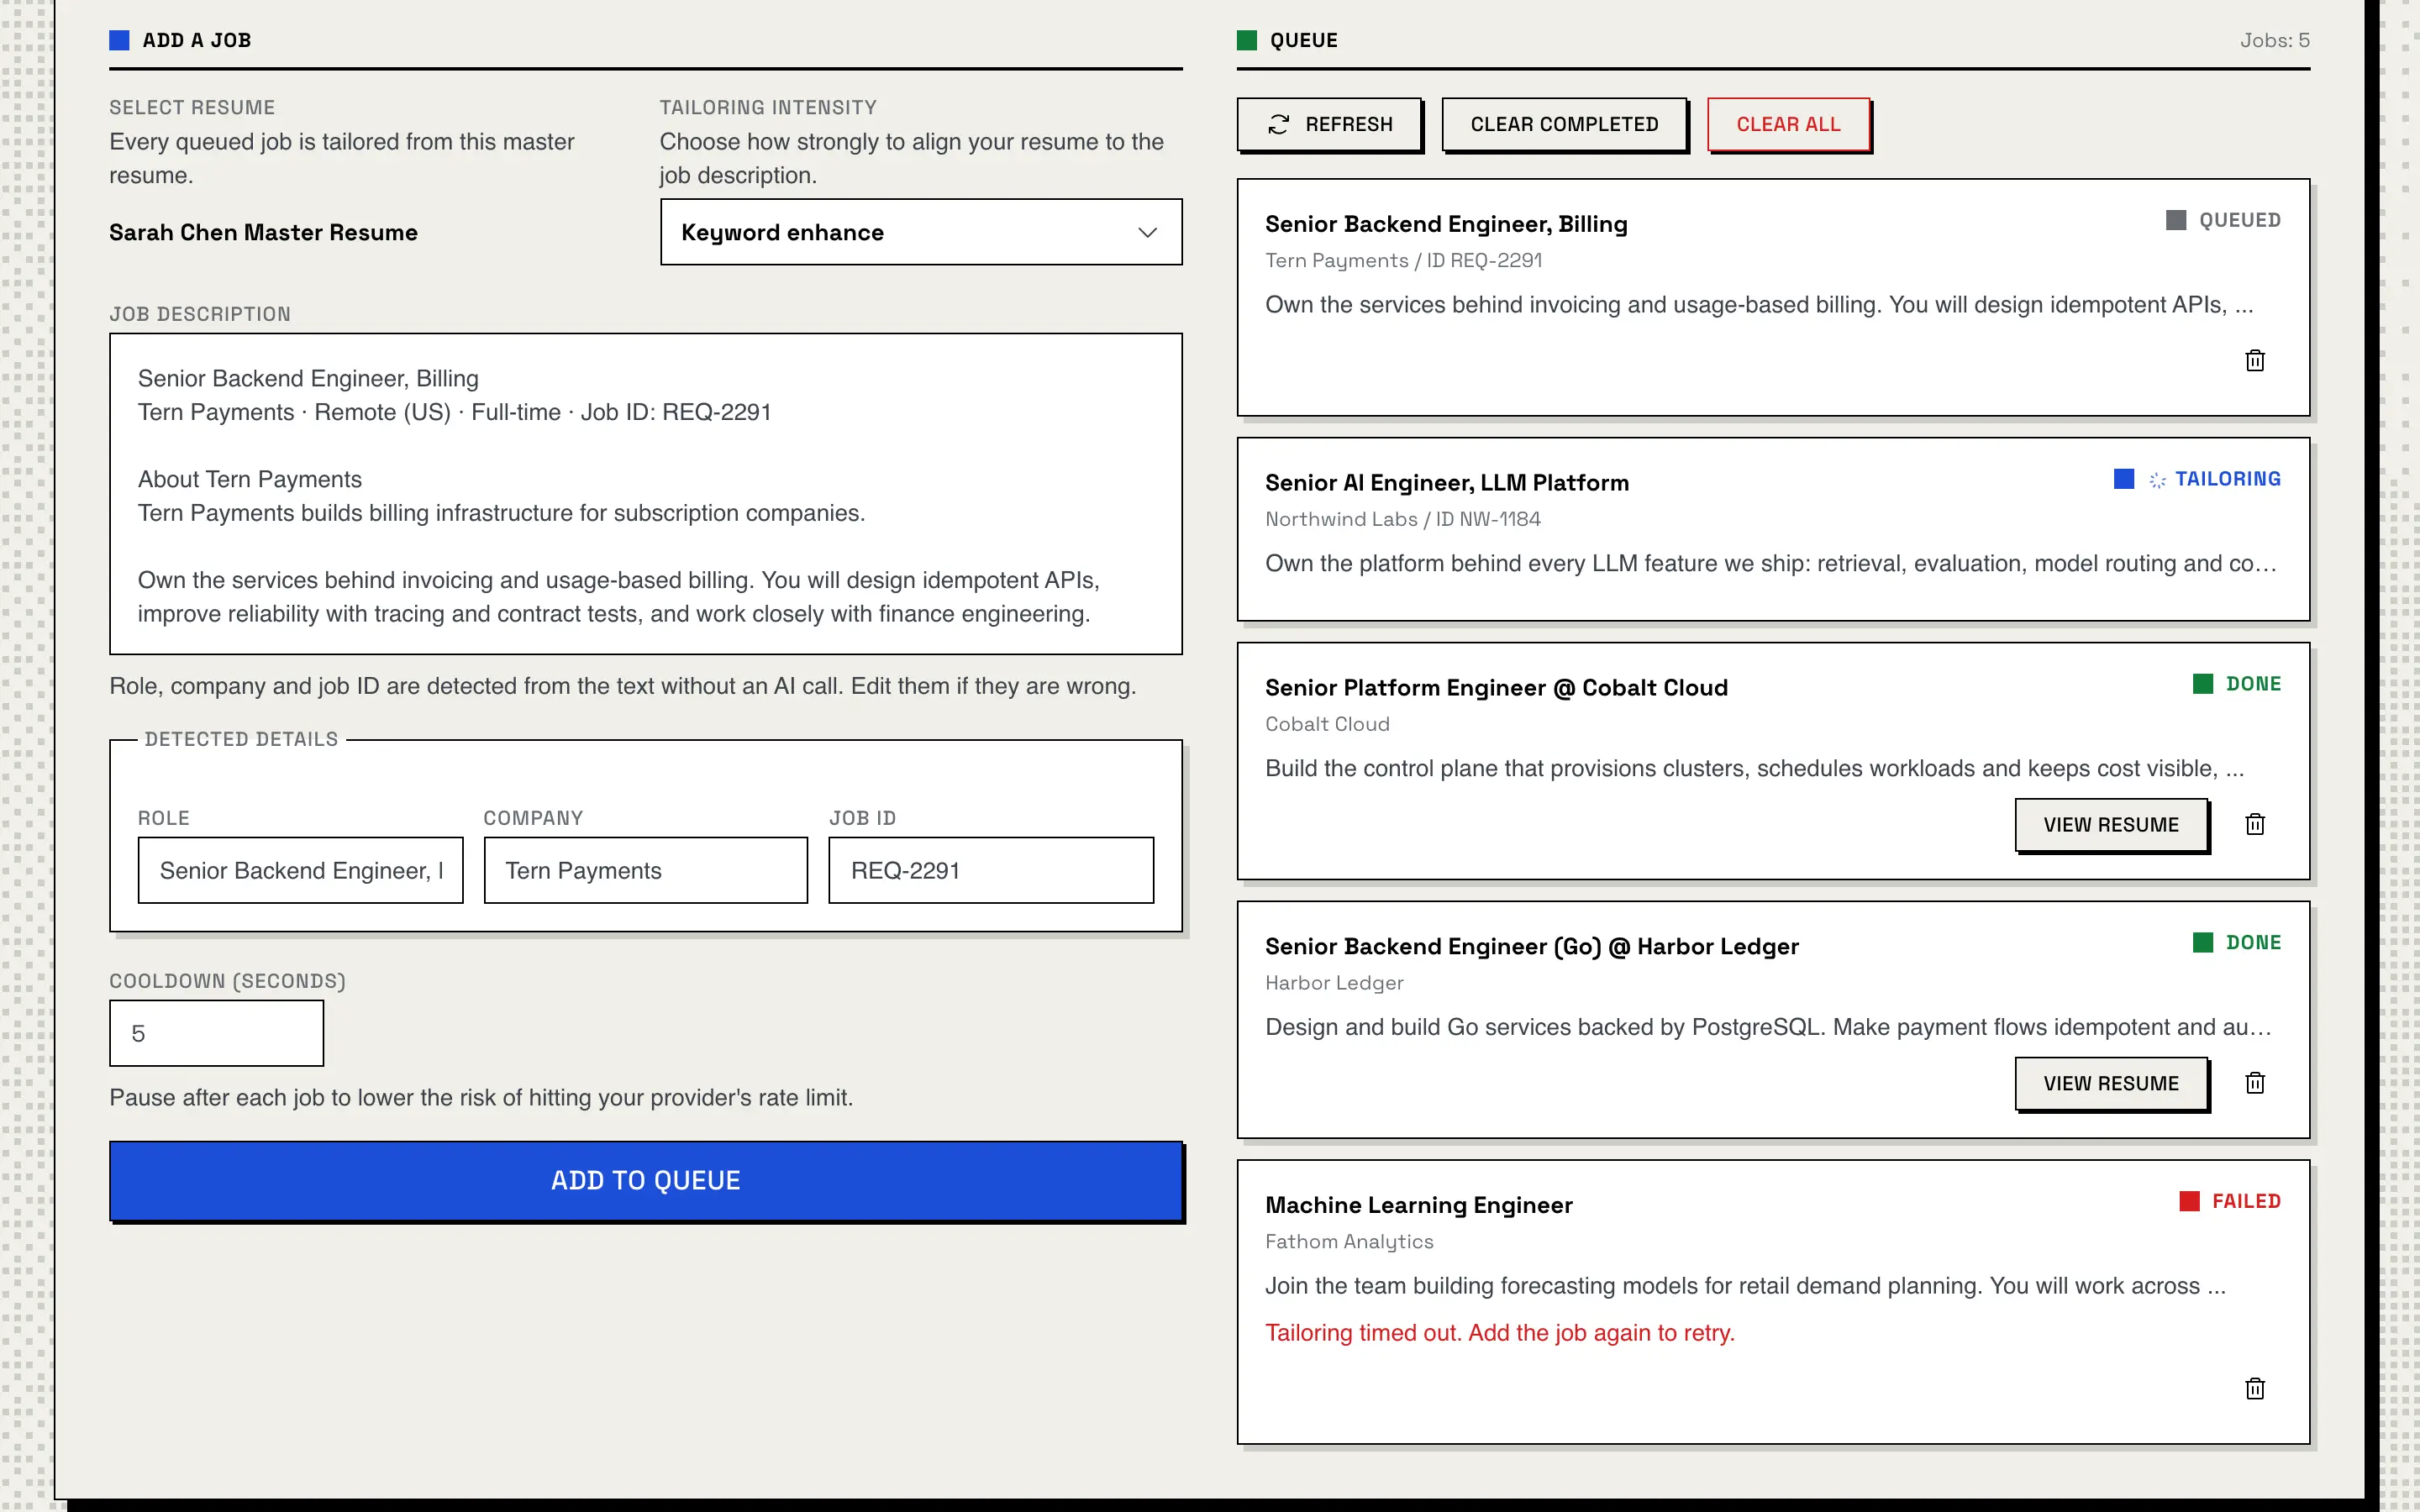
複数の求人に同時に応募しますか? 求人内容をそれぞれカスタマイズキューに貼り付ければ、Resume Matcher が 1 件ずつ順番にカスタマイズします。プロバイダーのレート制限にかからないよう、求人のあいだには短い待機時間(デフォルト 5 秒)があります。職種、会社名、求人 ID は AI を呼び出さずにテキストから検出されます。
キューに入れた求人は確認ステップを経ません。それぞれ同じ的を絞った編集と安全策を通ったあと、すぐにカスタマイズ履歴書として保存され、トラッカーのカード、ATS スコア、設定でオンにした関連書類も作られます。キューはすべての箇条書きを残し、ページ数の上限を無視するので、送る前にビルダーでそれぞれの結果を読んでください。
キューはデータベースに保存されるので、再読み込みや再起動のあとも残ります。時間制限を超えるなどして失敗した求人は再試行されないので、もう一度追加してください。
カスタマイズは言い換えるためのもので、作り出すためのものではありません。次のルールはプロンプトでお願いしているだけでなく、コードで強制しています。
求人の言葉を使って、サマリーと箇条書きを言い換える
スキルを並べ替え、強調する
ページ数の上限と職歴ごとの箇条書き数の範囲で、残す箇条書きを選ぶ
求人が求めるスキルが求人内容に一字一句そのまま書かれていれば、追加する(高リスクとして表示)
名前、メール、電話番号、所在地、リンクを変える
勤務先、役職、日付を変える
学校、学位、在学期間を変える
元の履歴書にない数値、割合、指標を加える
既存のスキル、資格、語学、受賞歴を削除する
新しい職歴、学校、プロジェクトを加える
カスタムセクションに手を加える
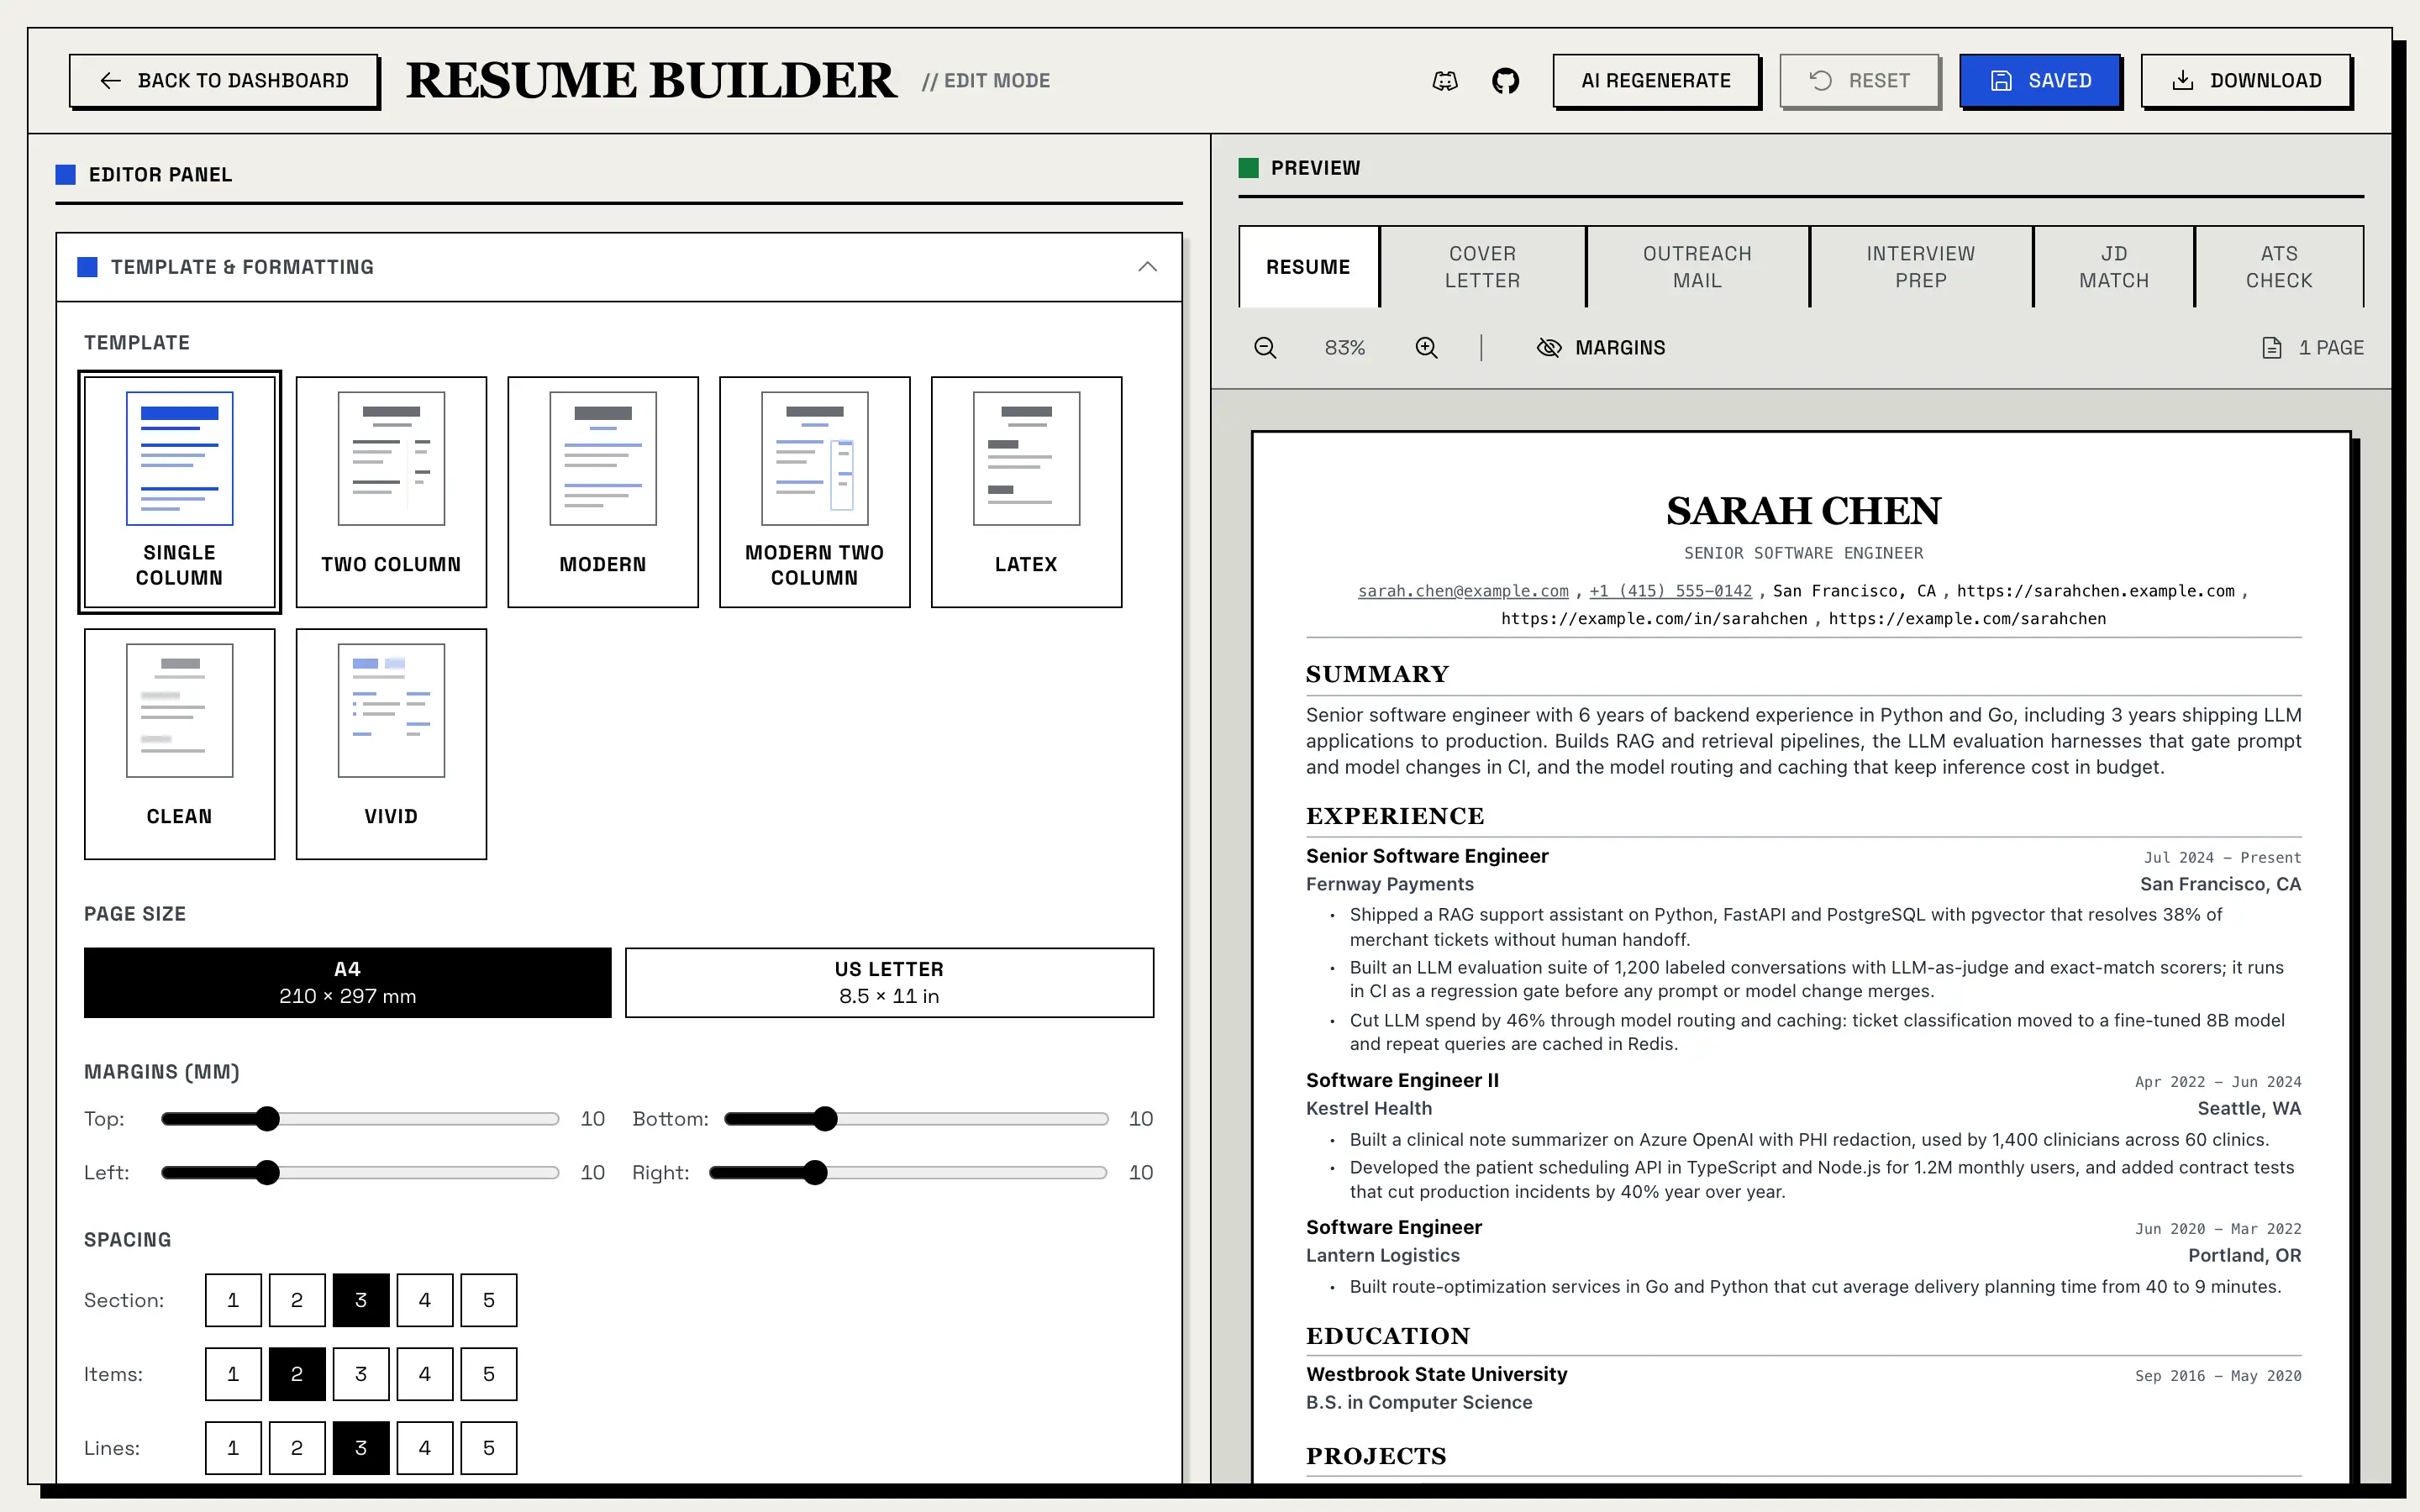
マスター履歴書もカスタマイズ版も、すべての履歴書はビルダーで開きます。左にエディター、右にページ単位のライブプレビューがあり、履歴書、カバーレター、連絡メール、面接準備、ATSチェック、そしてカスタマイズ履歴書では JD一致 のタブがあります。
7
テンプレート(1 段組みと 2 段組み)
A4 / Letter
用紙サイズ。プレビューのとおりに印刷
5〜25 mm
各辺の余白(デフォルト 10 mm)
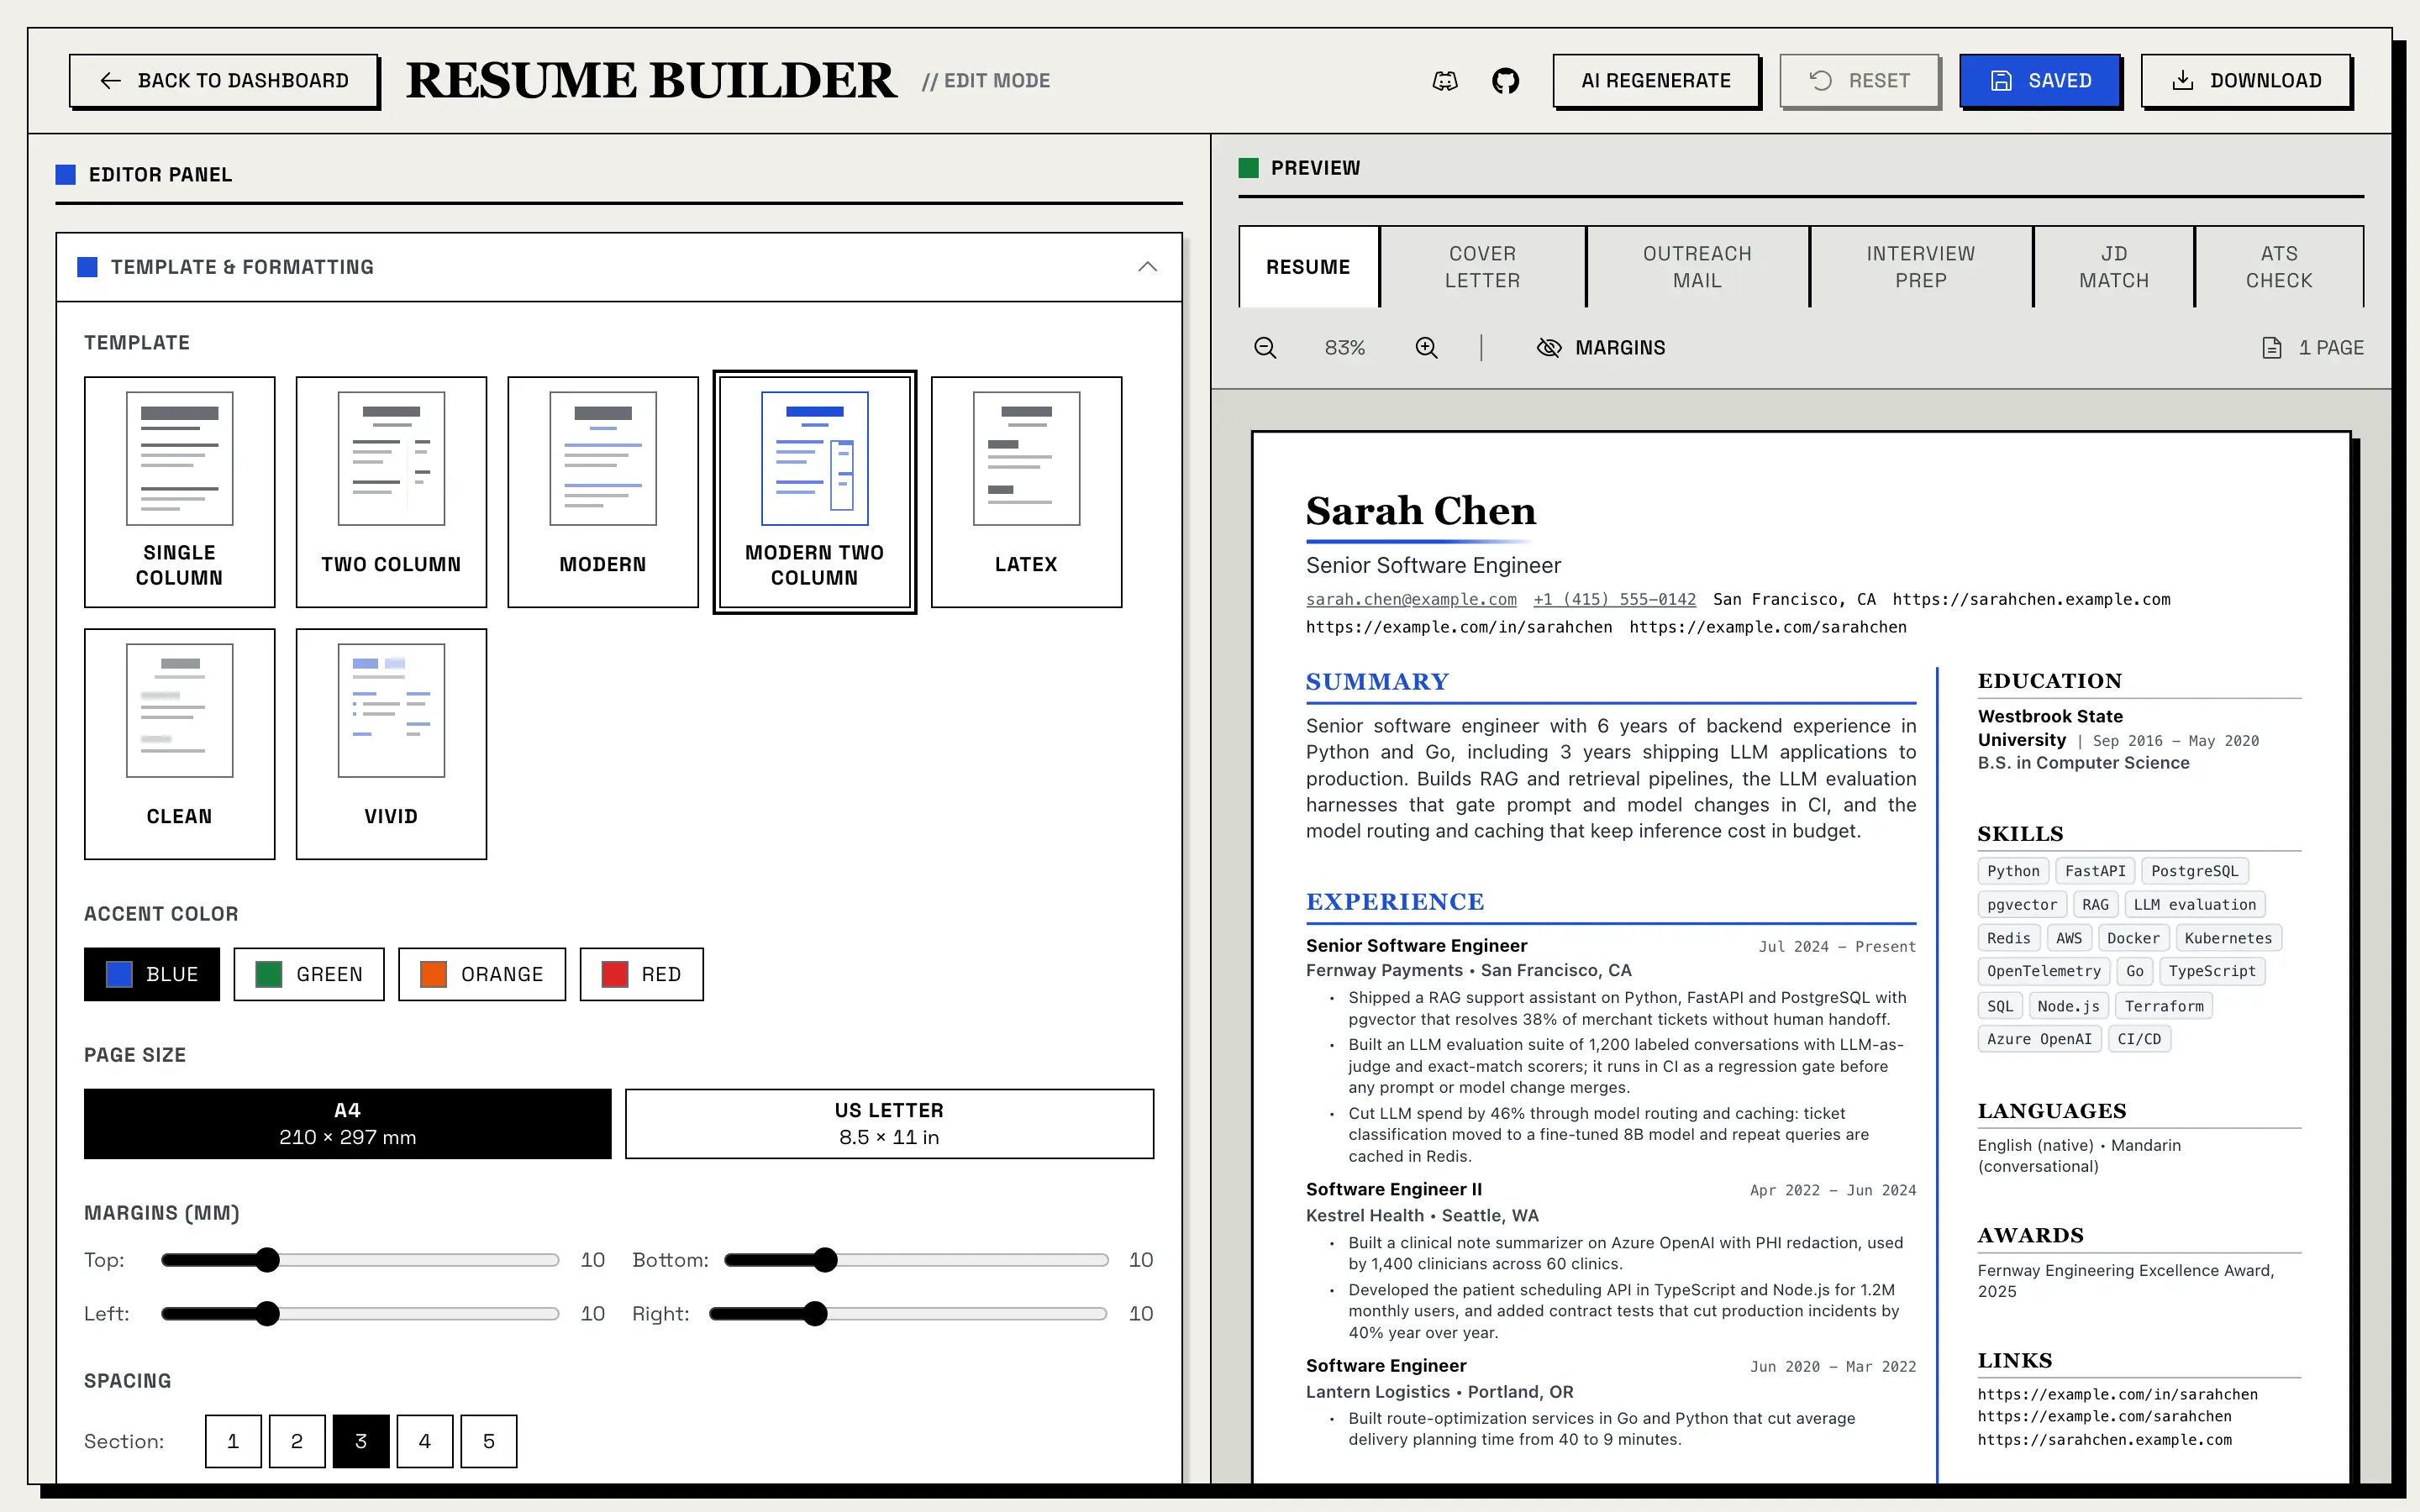
Single Column
1 段組み
Two Column
2 段組み
Modern
1 段組み、アクセントカラー
Modern Two Column
2 段組み、アクセントカラー
LaTeX
1 段組み
Clean
1 段組み
Vivid
2 段組み、アクセントカラー
2 段組みのテンプレートは読み取り順で本文が先に来るので、テキスト抽出ツールはサイドバーより先に職歴を読みます。
カスタマイズ履歴書では、JD一致 タブで求人内容(Job Description、JD)が履歴書の横に表示され、履歴書にすでに含まれている求人内容のキーワードがすべて黄色でハイライトされます。
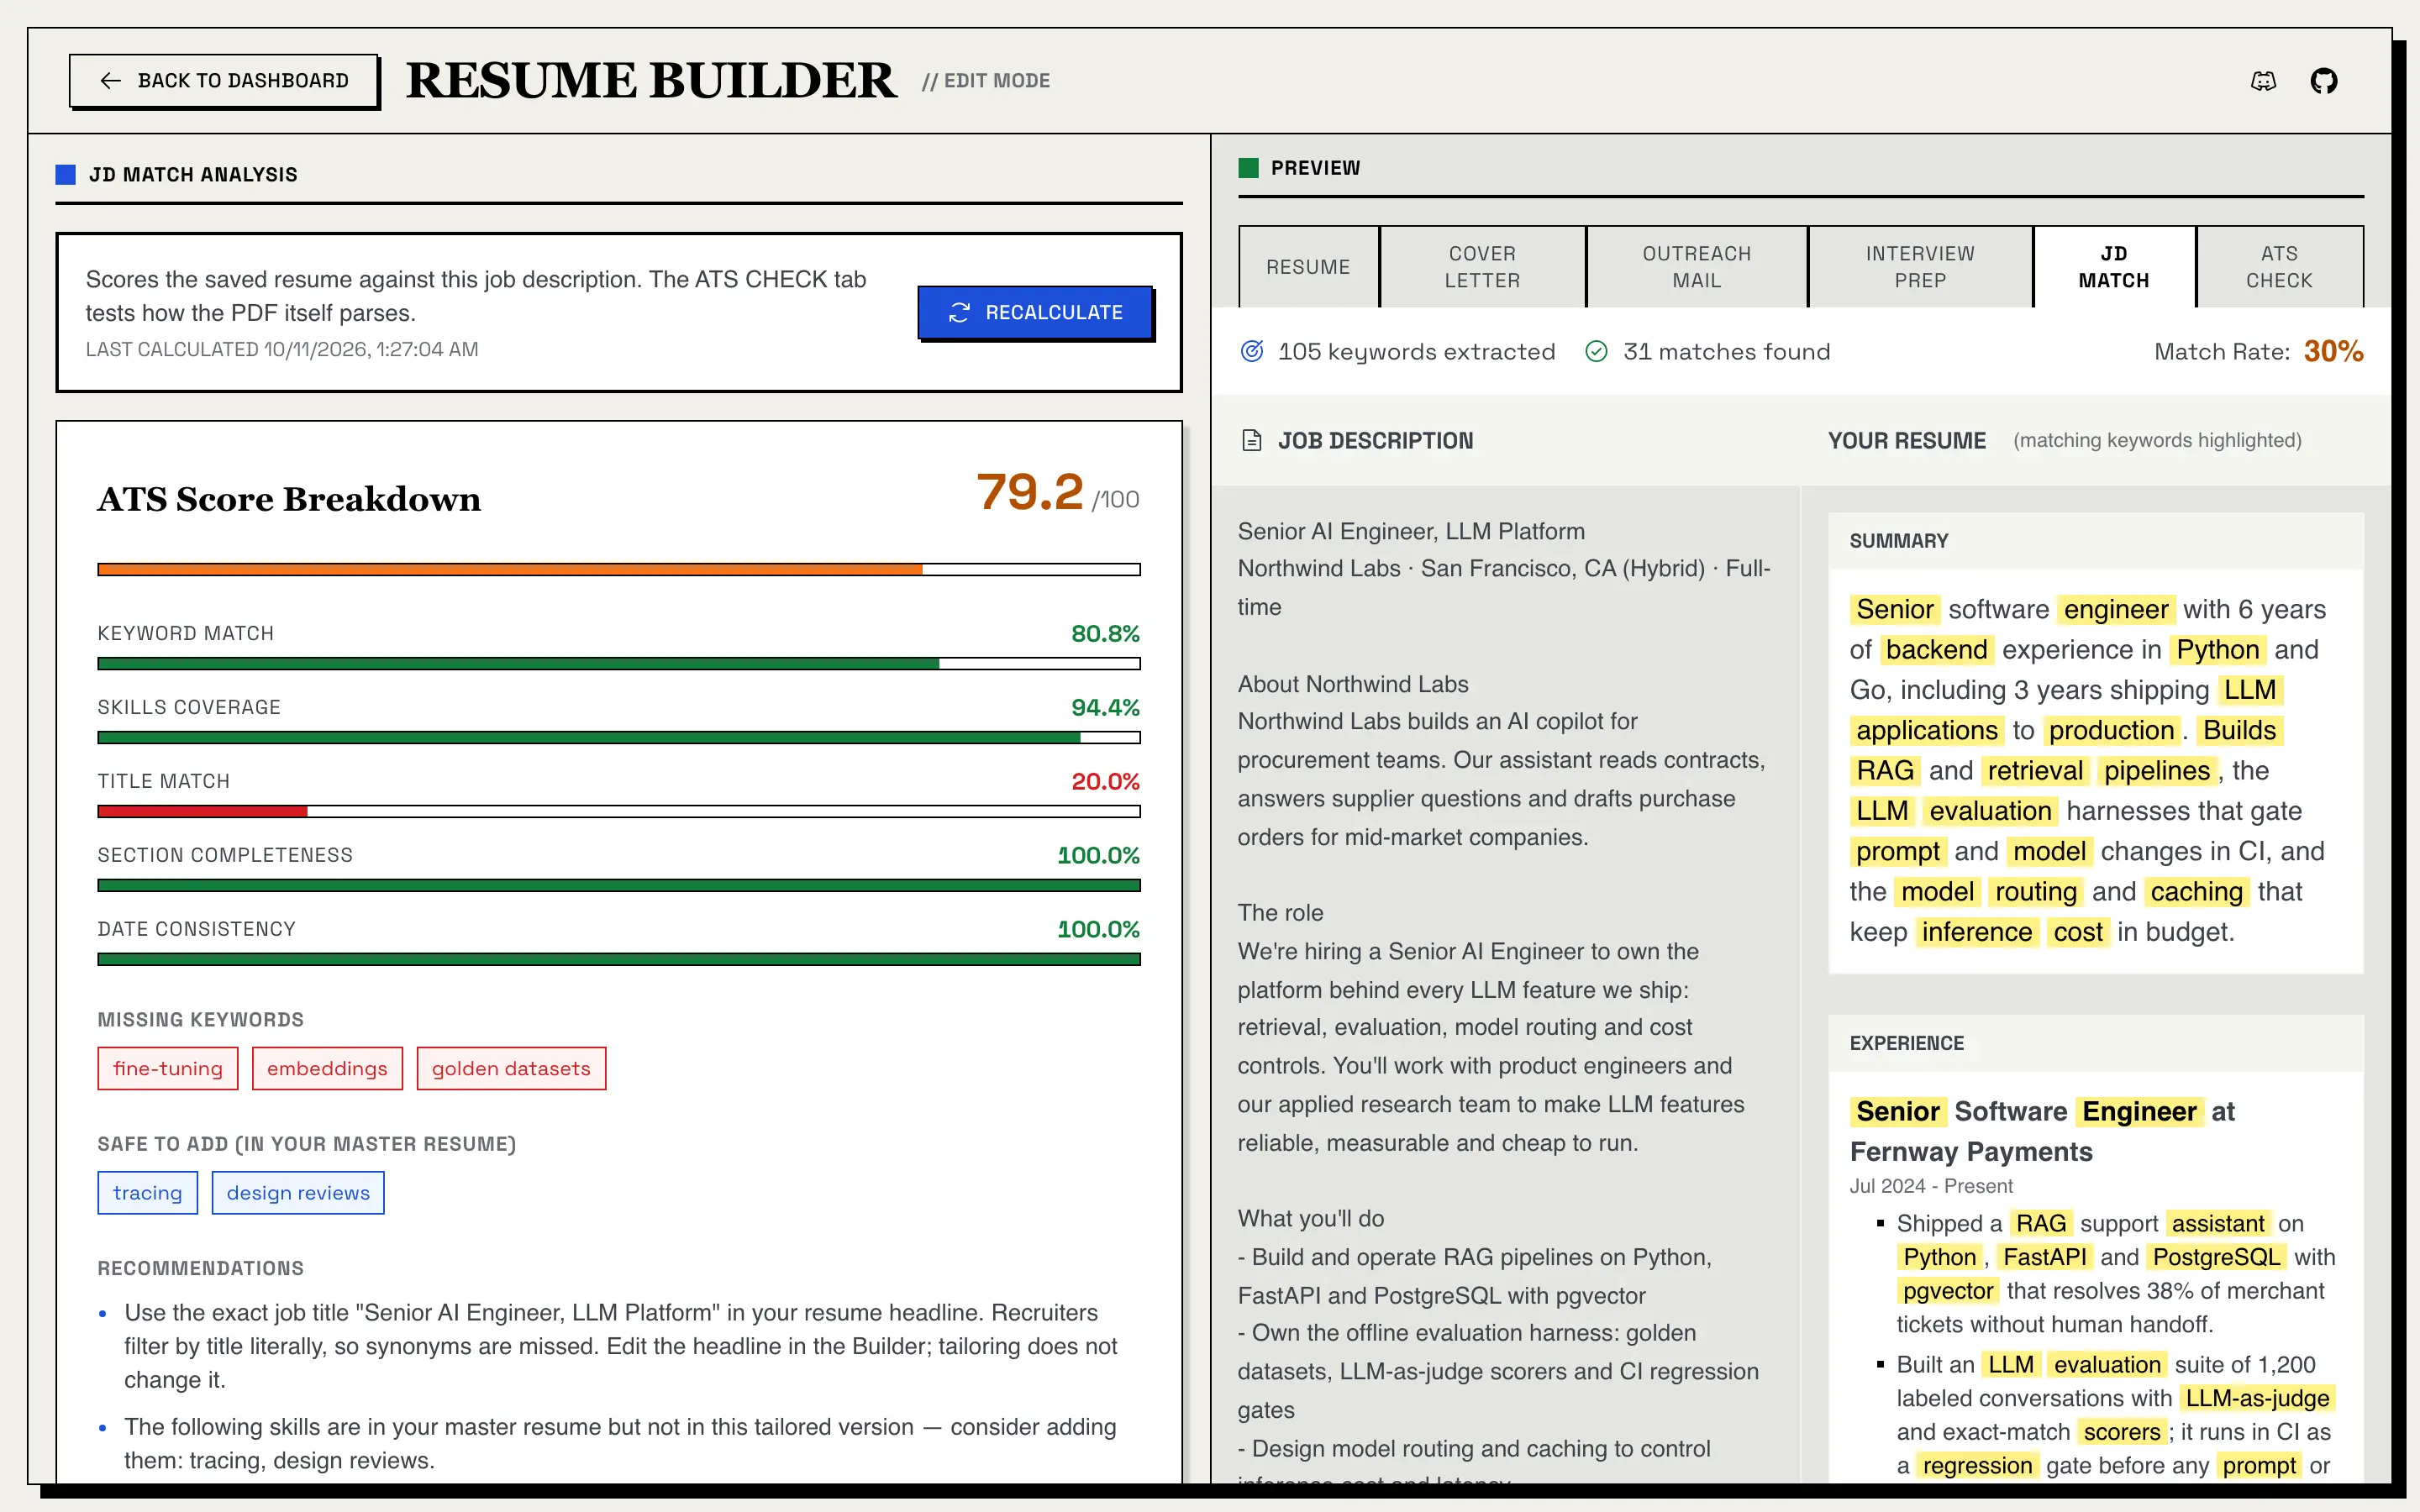
一致率は AI を使わない単純な計算です。
求人内容の単語から、英語の一般的な語と求人票によくある語(「team」「role」「experience」など)を除き、3 文字以上の単語を残します。
履歴書でも同じことをします。
一致率 = 履歴書に含まれる求人内容のキーワード数 ÷ 求人内容のキーワードの総数。
求人内容
We are hiring a backend engineer to build Python services on Kubernetes. You will run Postgres, Redis and Kafka and cut latency with the team.
あなたの履歴書
Built Python services on Kubernetes; cut latency by 40%.
10 キーワード · 4 一致
一致率: 4 ÷ 10 = 40%
50% 以上で緑、30% 以上で黄、30% 未満で赤になります。会社紹介も含めて求人の意味のある単語をすべて数えるため、よくできた履歴書でも 30〜50% になることがよくあります。足りないスキルや用語を見つけるために使い、合格ラインとしては扱わないでください。現在は a〜z の単純な単語しか数えないため、アクセント付きの単語や中国語、日本語、韓国語のテキストは数えられません。英文の求人と英文レジュメのための機能です。
どちらも雇用主の応募者追跡システムをシミュレーションするものではありません。あなたが自分で管理できること、つまりソフトウェアが PDF を読めるか、履歴書が求人をどれだけカバーしているかを調べます。
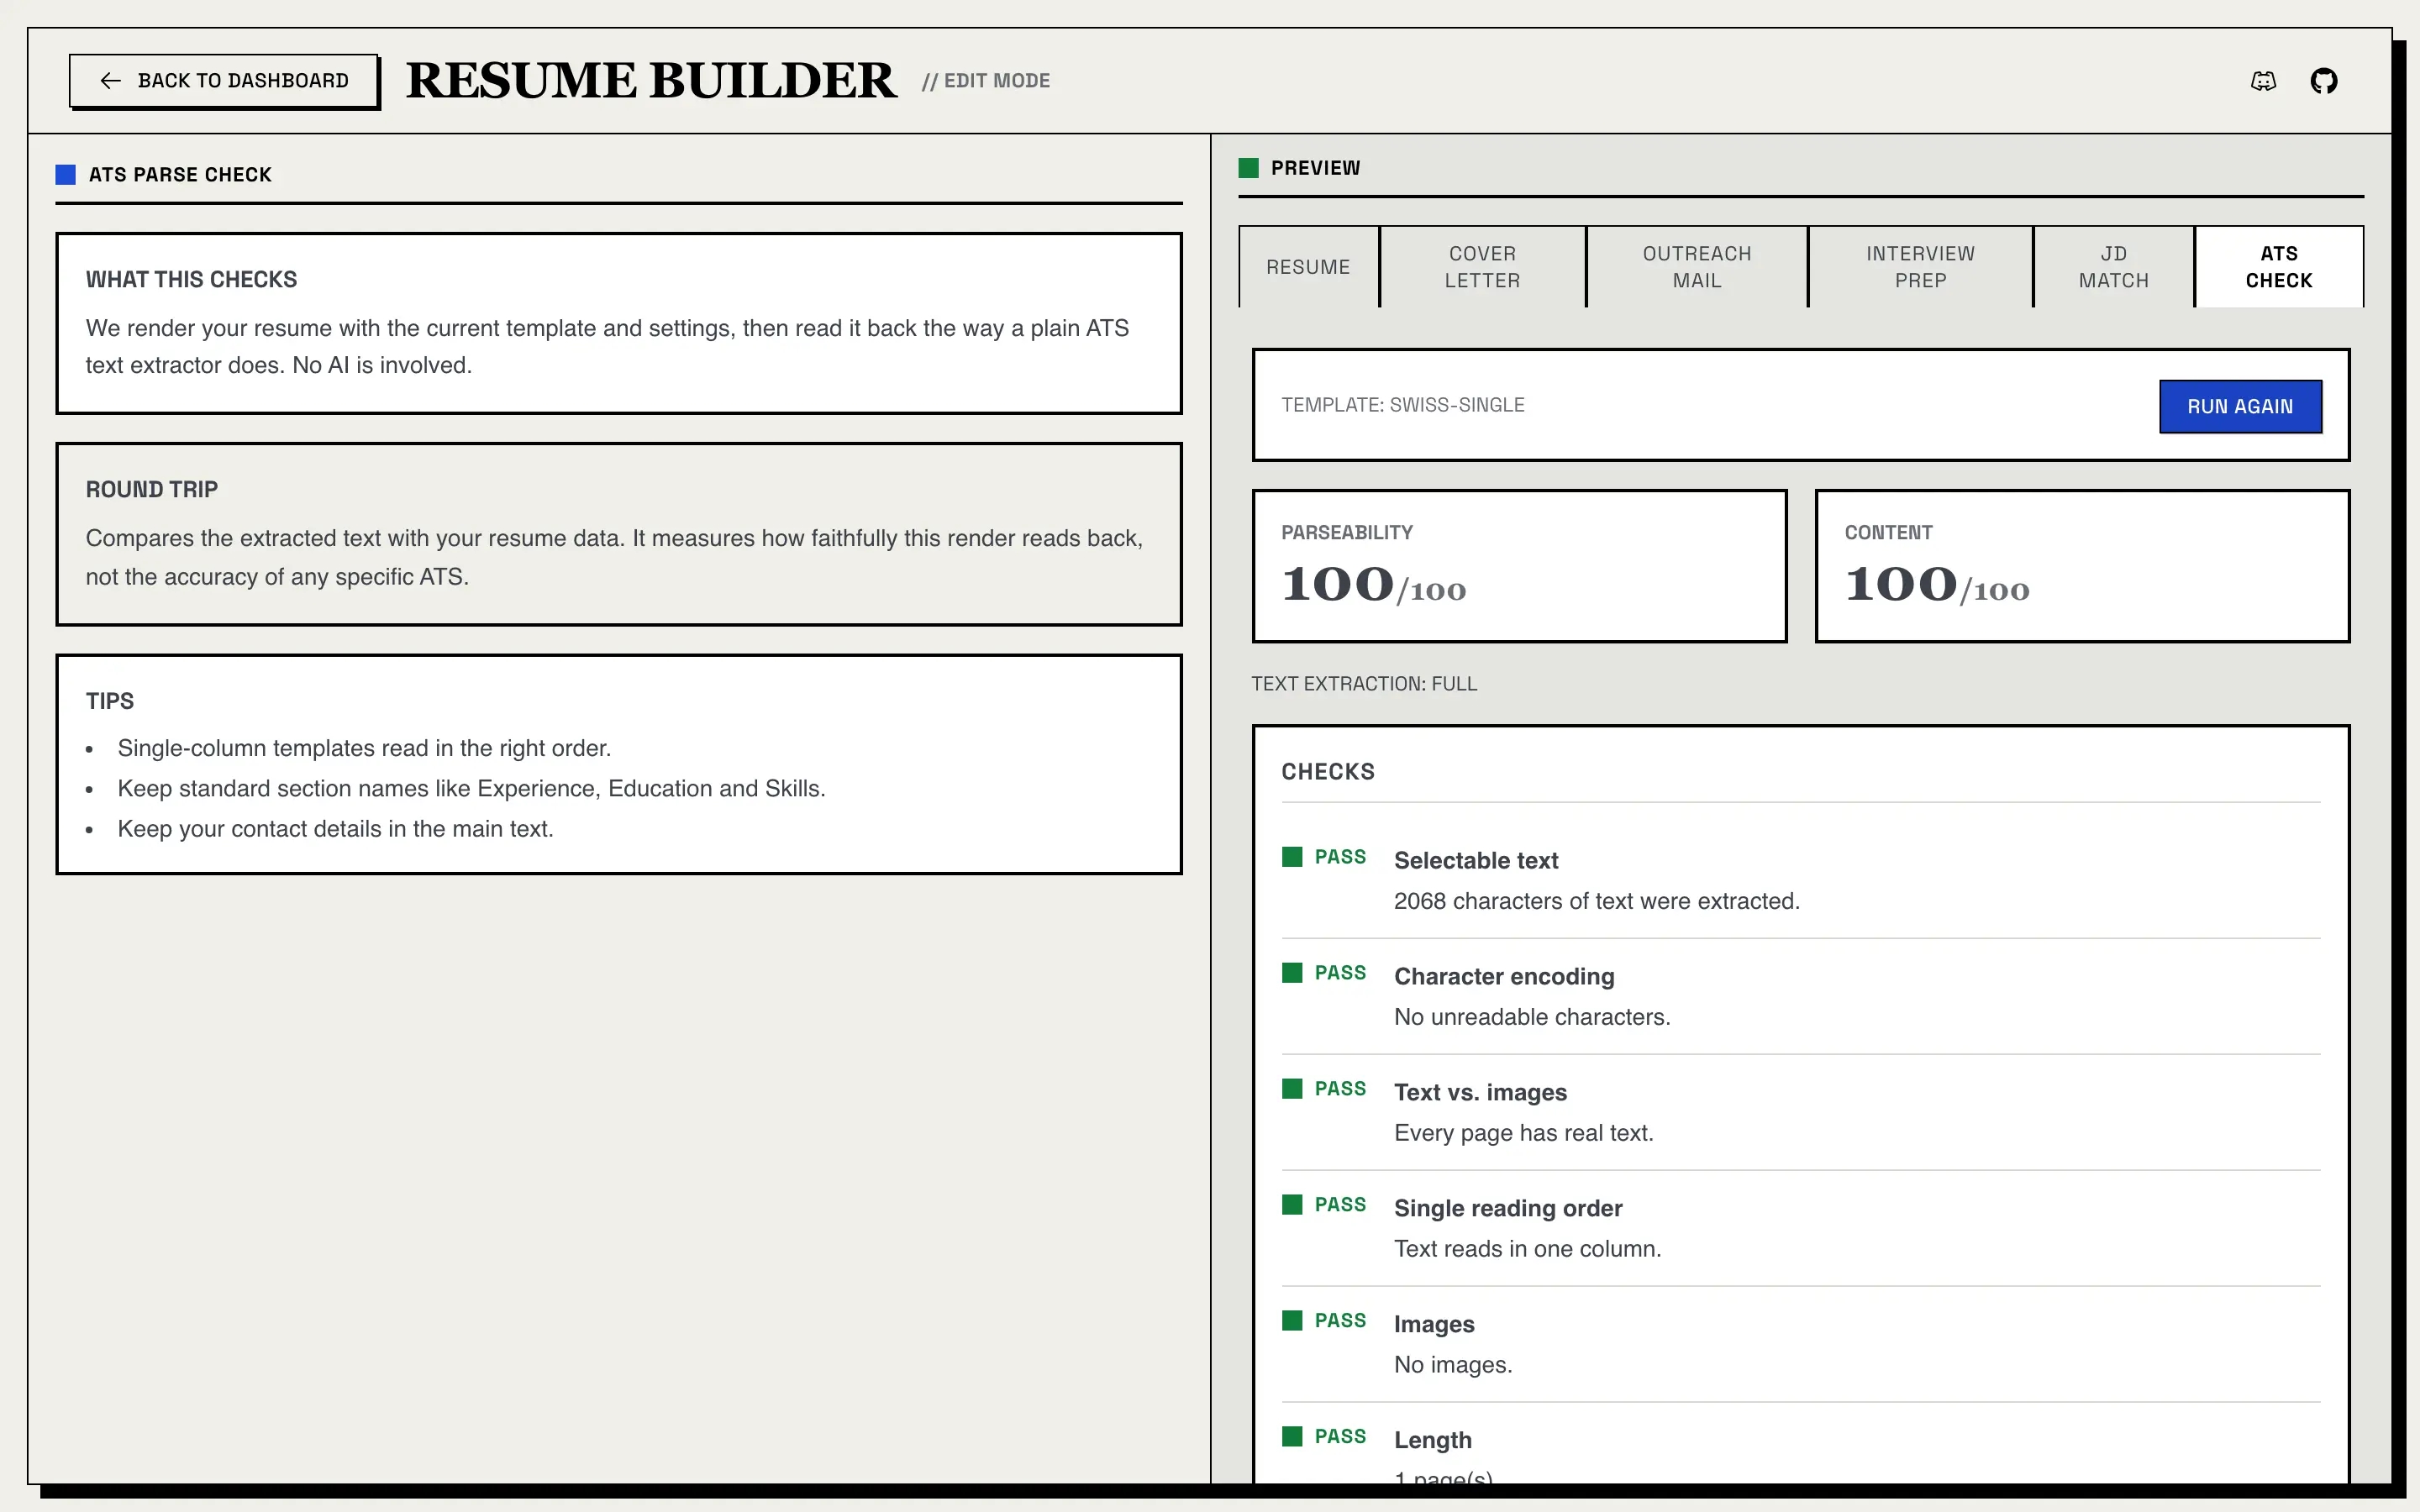
ATSチェック タブは、最後に保存した履歴書を現在のテンプレートで描画し(ダウンロードで得られるのと同じ PDF です)、単純な ATS のテキスト抽出ツールと同じやり方で読み戻します。AI は使いません。読み取りやすさと内容をそれぞれ 100 点満点で採点し、すべてのチェックを一覧にします。選択可能なテキスト、文字エンコーディング、テキストと画像、単一の読み取り順、ヘッダーとフッター、画像、長さ、連絡先、セクション見出し、日付。往復チェックは、抽出したテキストを履歴書のデータと比べます。保存済みのどの履歴書でも使えます。
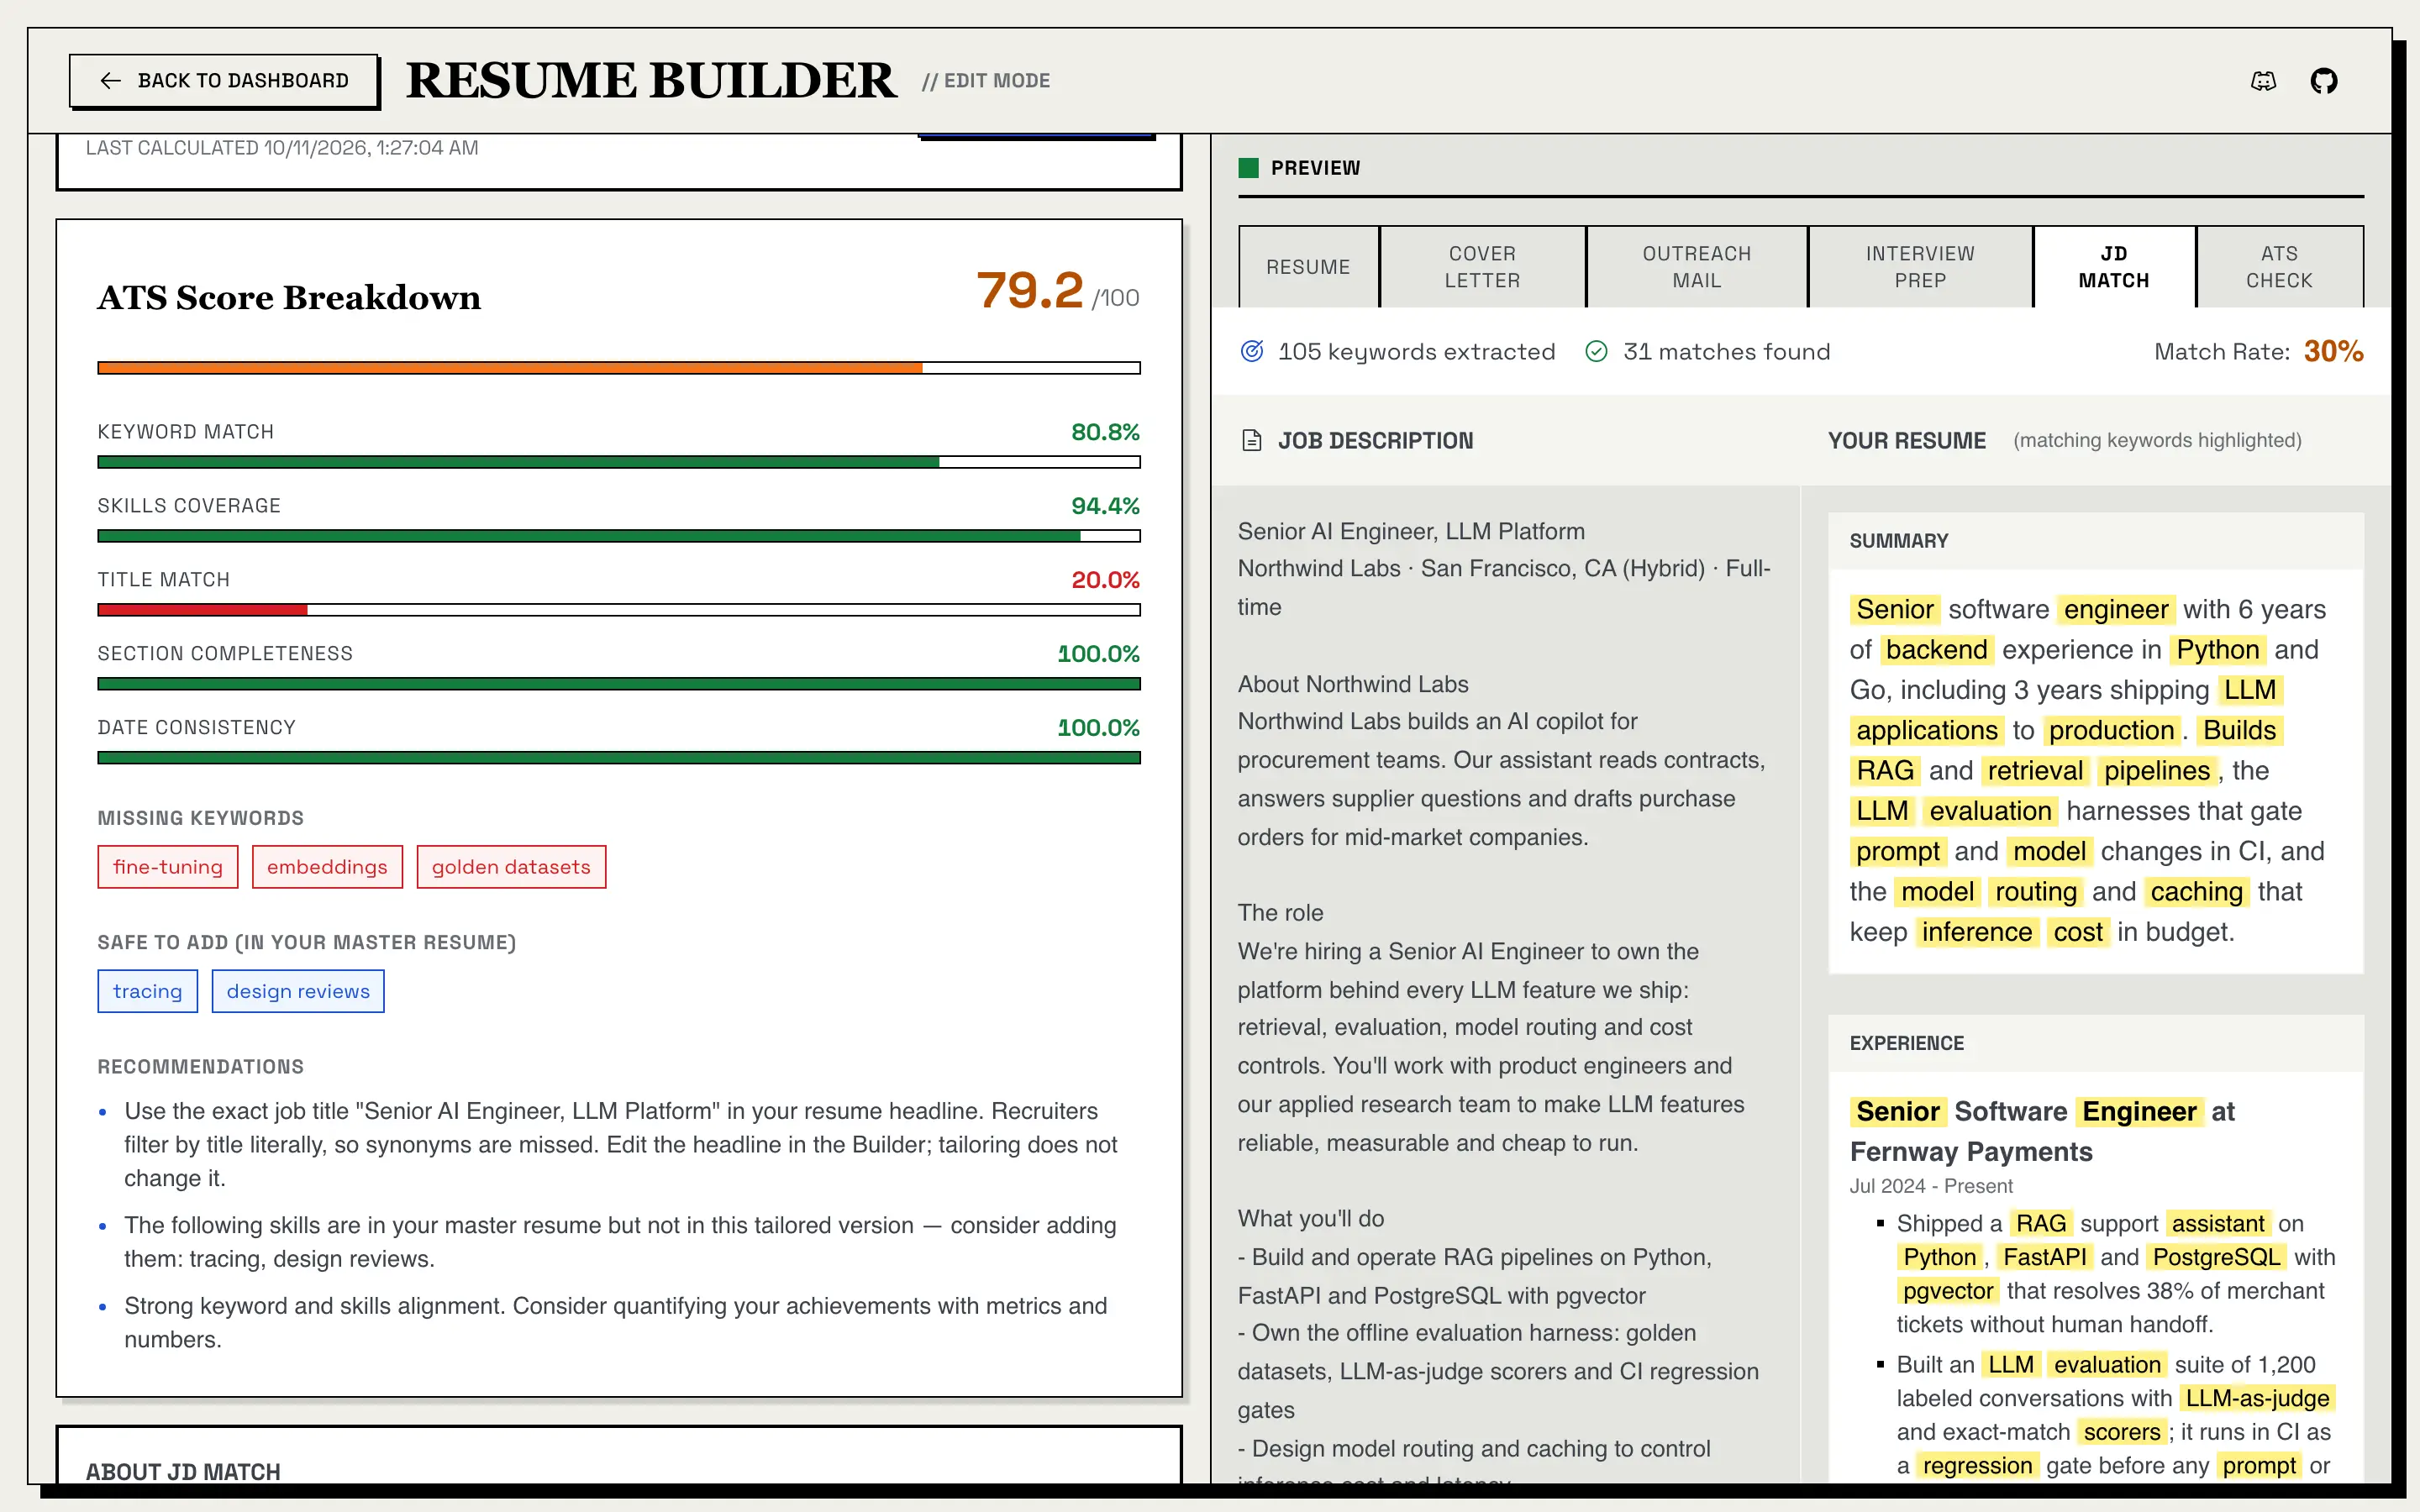
カスタマイズ履歴書では、ATSスコアの内訳が履歴書をその求人に対して採点します。キーワード一致 40%、スキルのカバー率 20%、職種名の一致 15%、セクションの充足度 15%、日付の一貫性 10%。不足しているキーワード、マスター履歴書から安全に追加できるキーワード、推奨事項も一覧にします。スコアは履歴書と一緒に保存されるので、編集したら保存して「再計算」をクリックしてください。採点は単純なコードで、AI は呼び出しません。
どちらも同じ求人に向けて、あなたの履歴書をもとに書かれます。ビルダーのタブから必要なときに生成するか、設定でオンにして、カスタマイズ履歴書を確定するたびに作られるようにします。
100〜150
語のカバーレター
70〜100
語の連絡メール
5
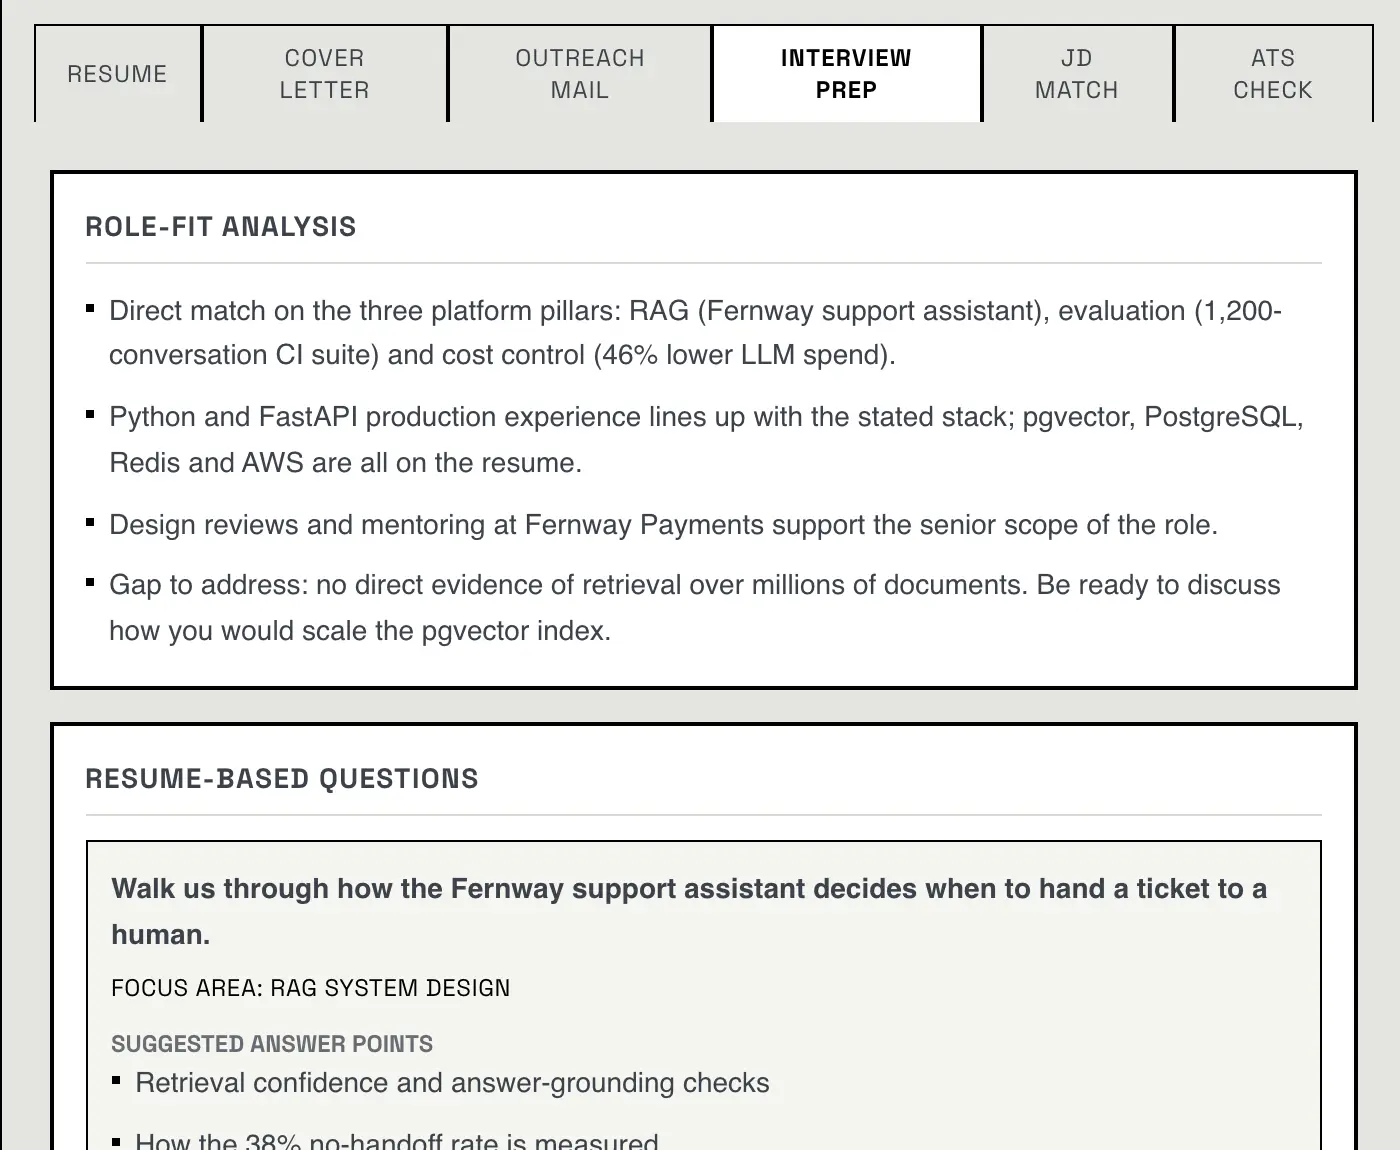
つの面接準備のパート(職務への適合度から話すポイントまで)
履歴書をもとに特定の求人に向けて書く、100〜150 語の短いレターです。プロンプトは、履歴書にないことを作り出さないようモデルに指示しています。印刷レイアウトの横で編集し、保存、再生成、または PDF でダウンロードします。日本企業への応募では一般的ではなく、外資系や海外への応募で役立ちます。
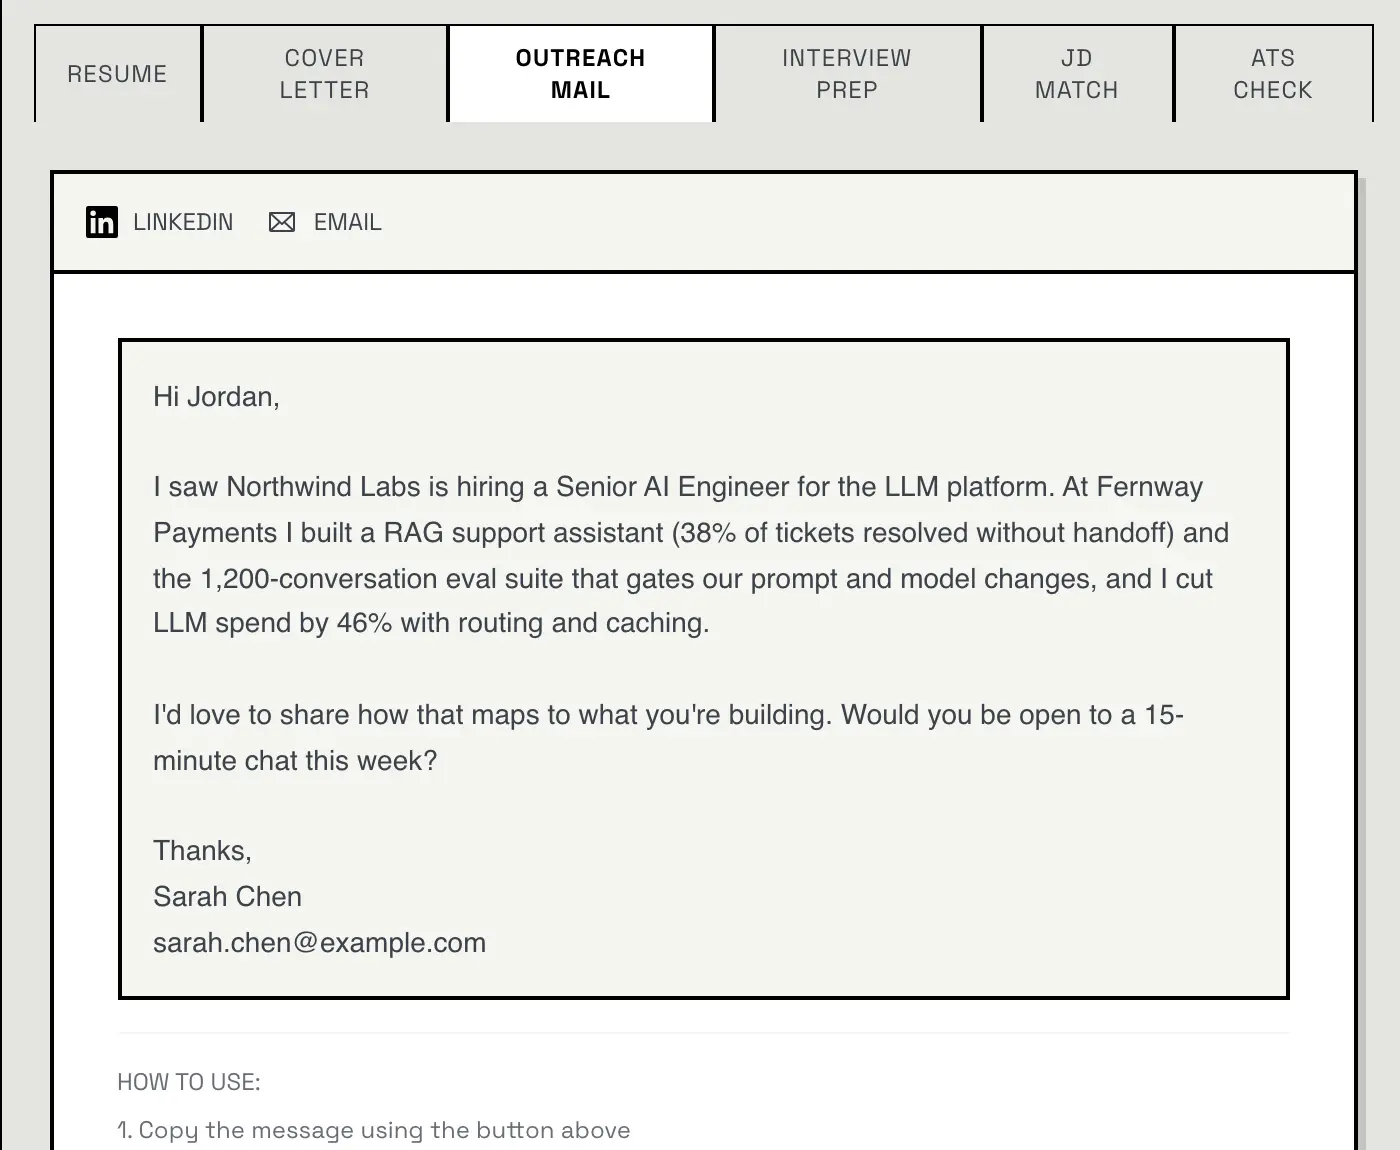
同じ求人に向けて履歴書をもとに書く、70〜100 語のコールドメールまたは LinkedIn のメッセージです。編集、再生成、クリップボードへのコピーができます。カバーレターと同じく、プロンプトは設定で自分のものに置き換えられます。
マスター履歴書を開き、「履歴書を強化」をクリックします。AI が内容の薄い職歴やプロジェクトの項目を探し、それについて最大 6 つの質問をします。回答をもとに項目ごとに 2〜4 個の新しい箇条書きを書き、あなたが確認してから「履歴書に追加」をクリックします。使うのはあなたが提供した情報だけで、数値を作り出すことはありません。
ビルダーで、作り直したい職歴、プロジェクト、スキルを選び、「use stronger action verbs」(より力強い動詞を使う)や「emphasise leadership」(リーダーシップを強調する)のような指示を書きます。適用前に変更前と変更後のプレビューが表示されます。プロンプトは、新しい事実、数値、日付、会社、役職、実績を加えることを禁じています。
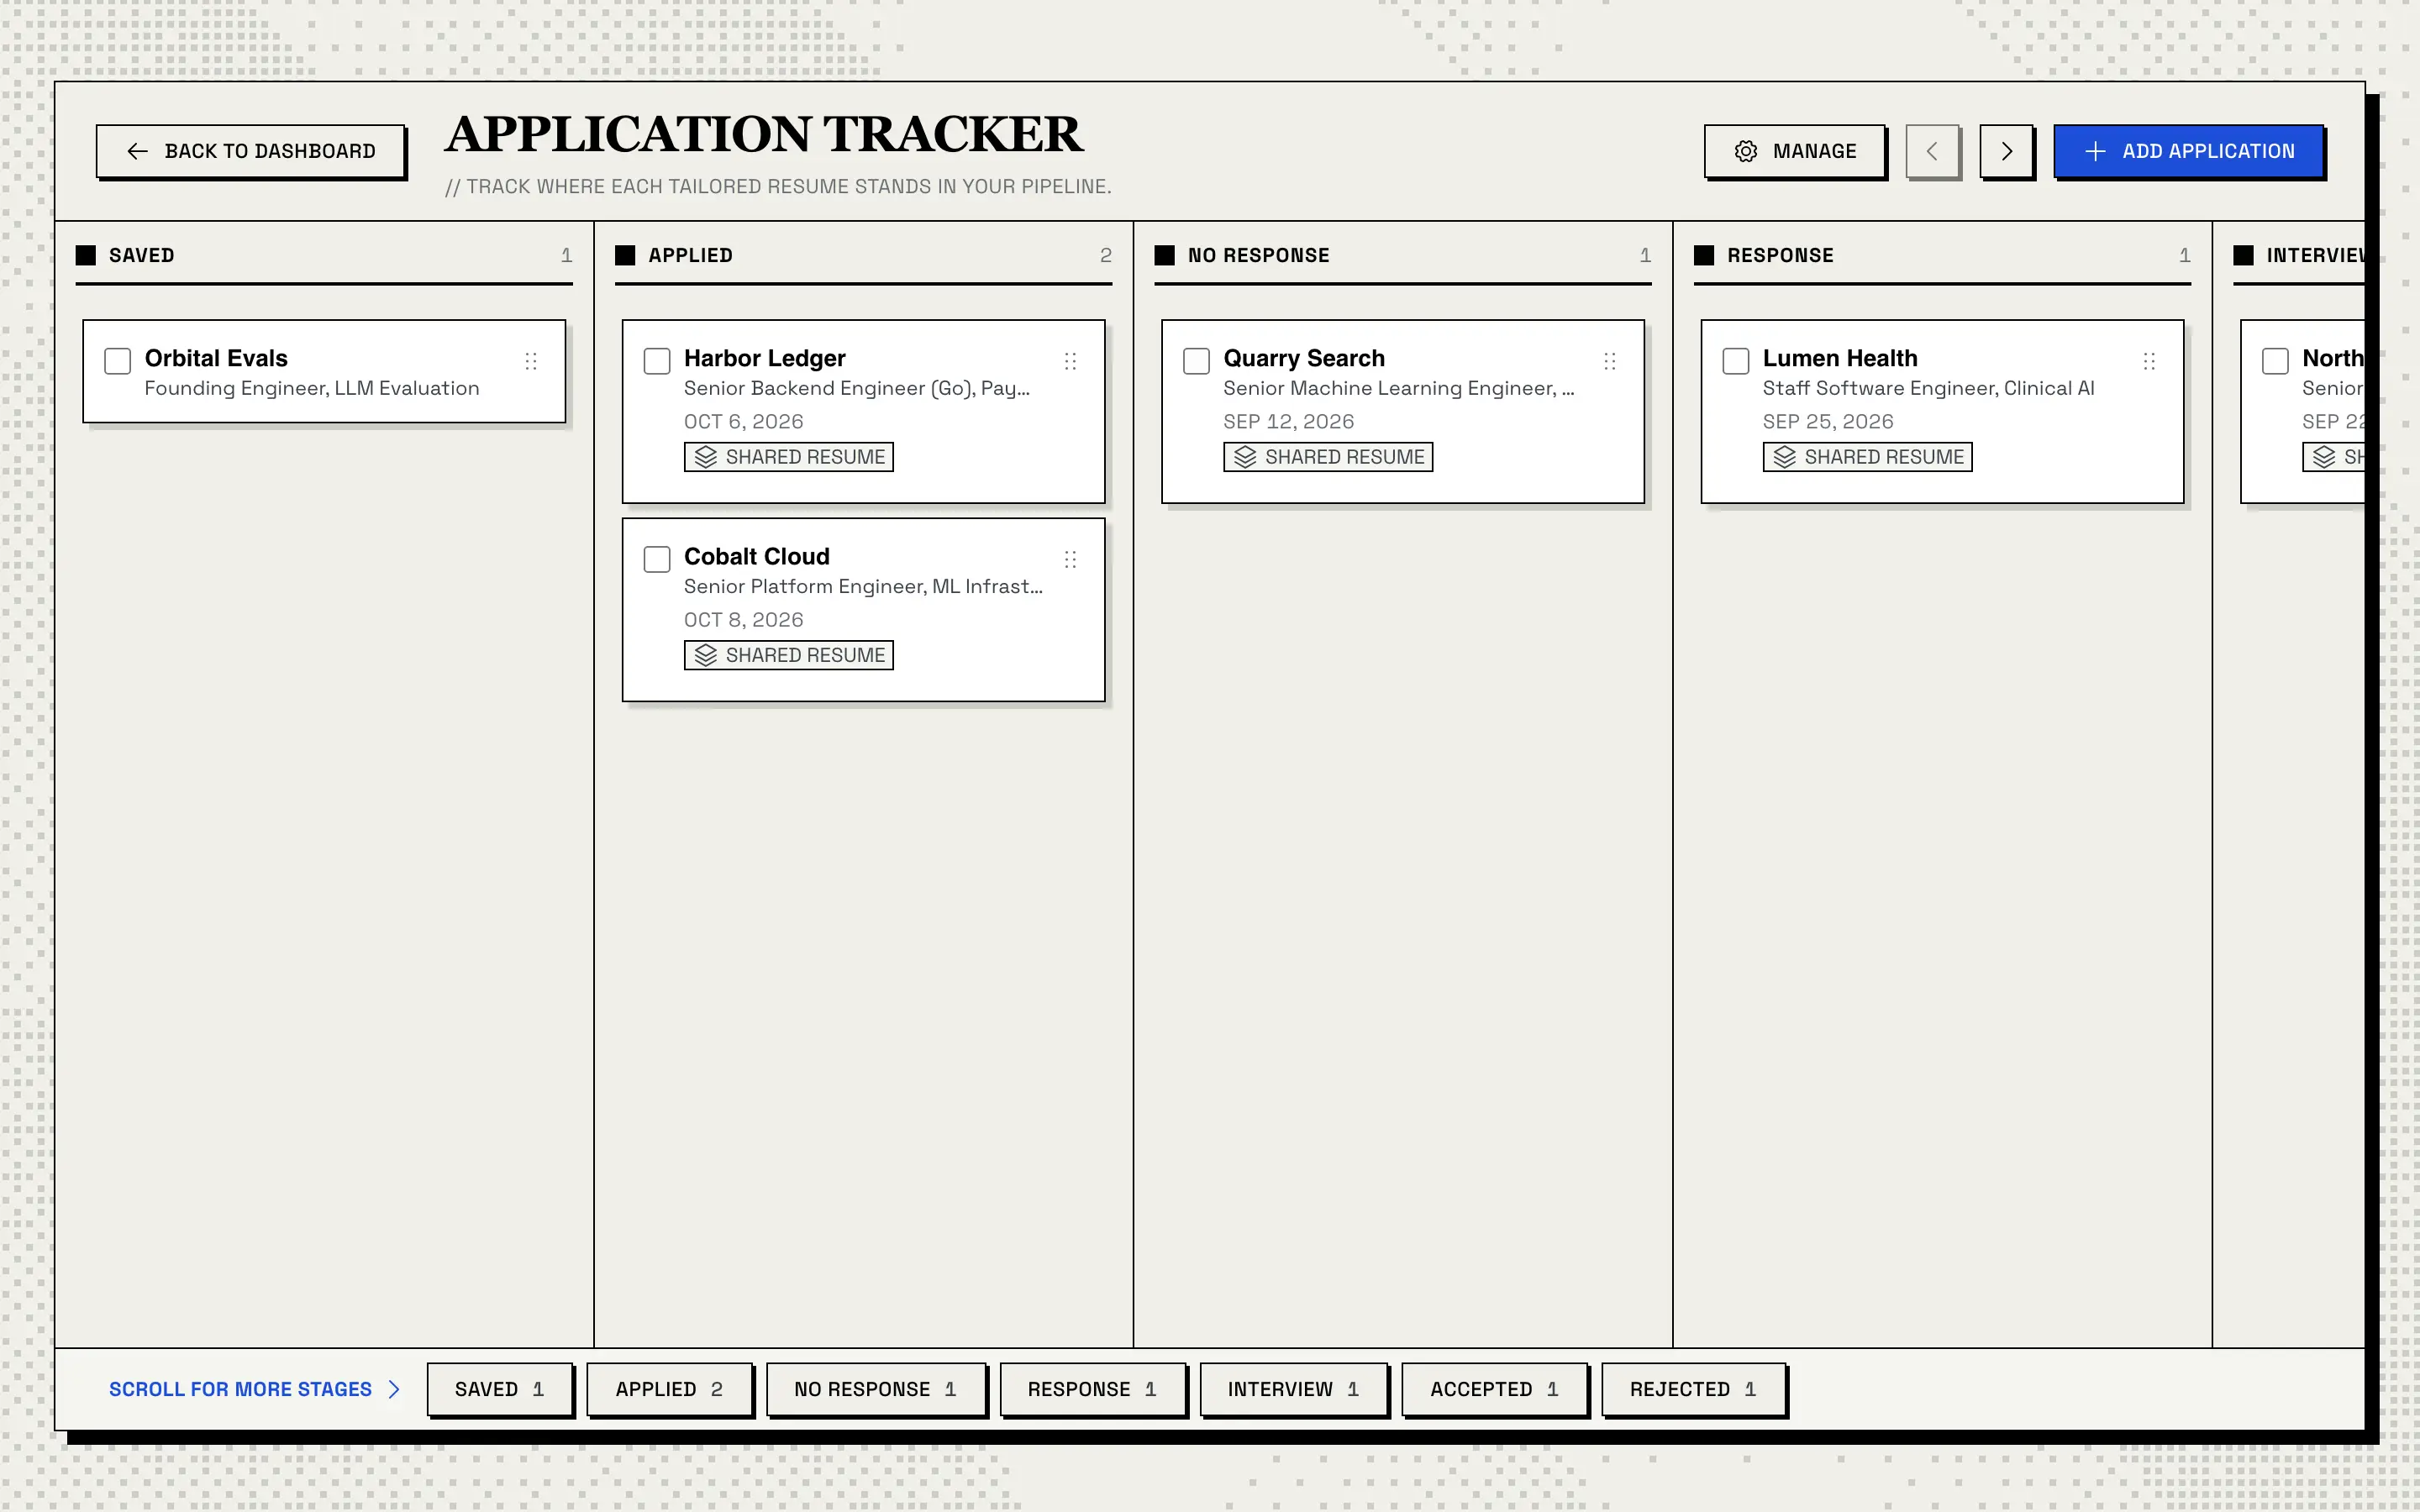
トラッカーは就職・転職活動のためのカンバンボードです。確定したカスタマイズ履歴書には自動でカードが作られ、まだカスタマイズしていない求人のカードは手動で追加できます。
7
つのステージ(保存済みから内定または不採用まで)
1
確定したカスタマイズ履歴書ごとに自動で追加されるカード
0
接続する求人サイト:トラッカーはあなた自身の記録です
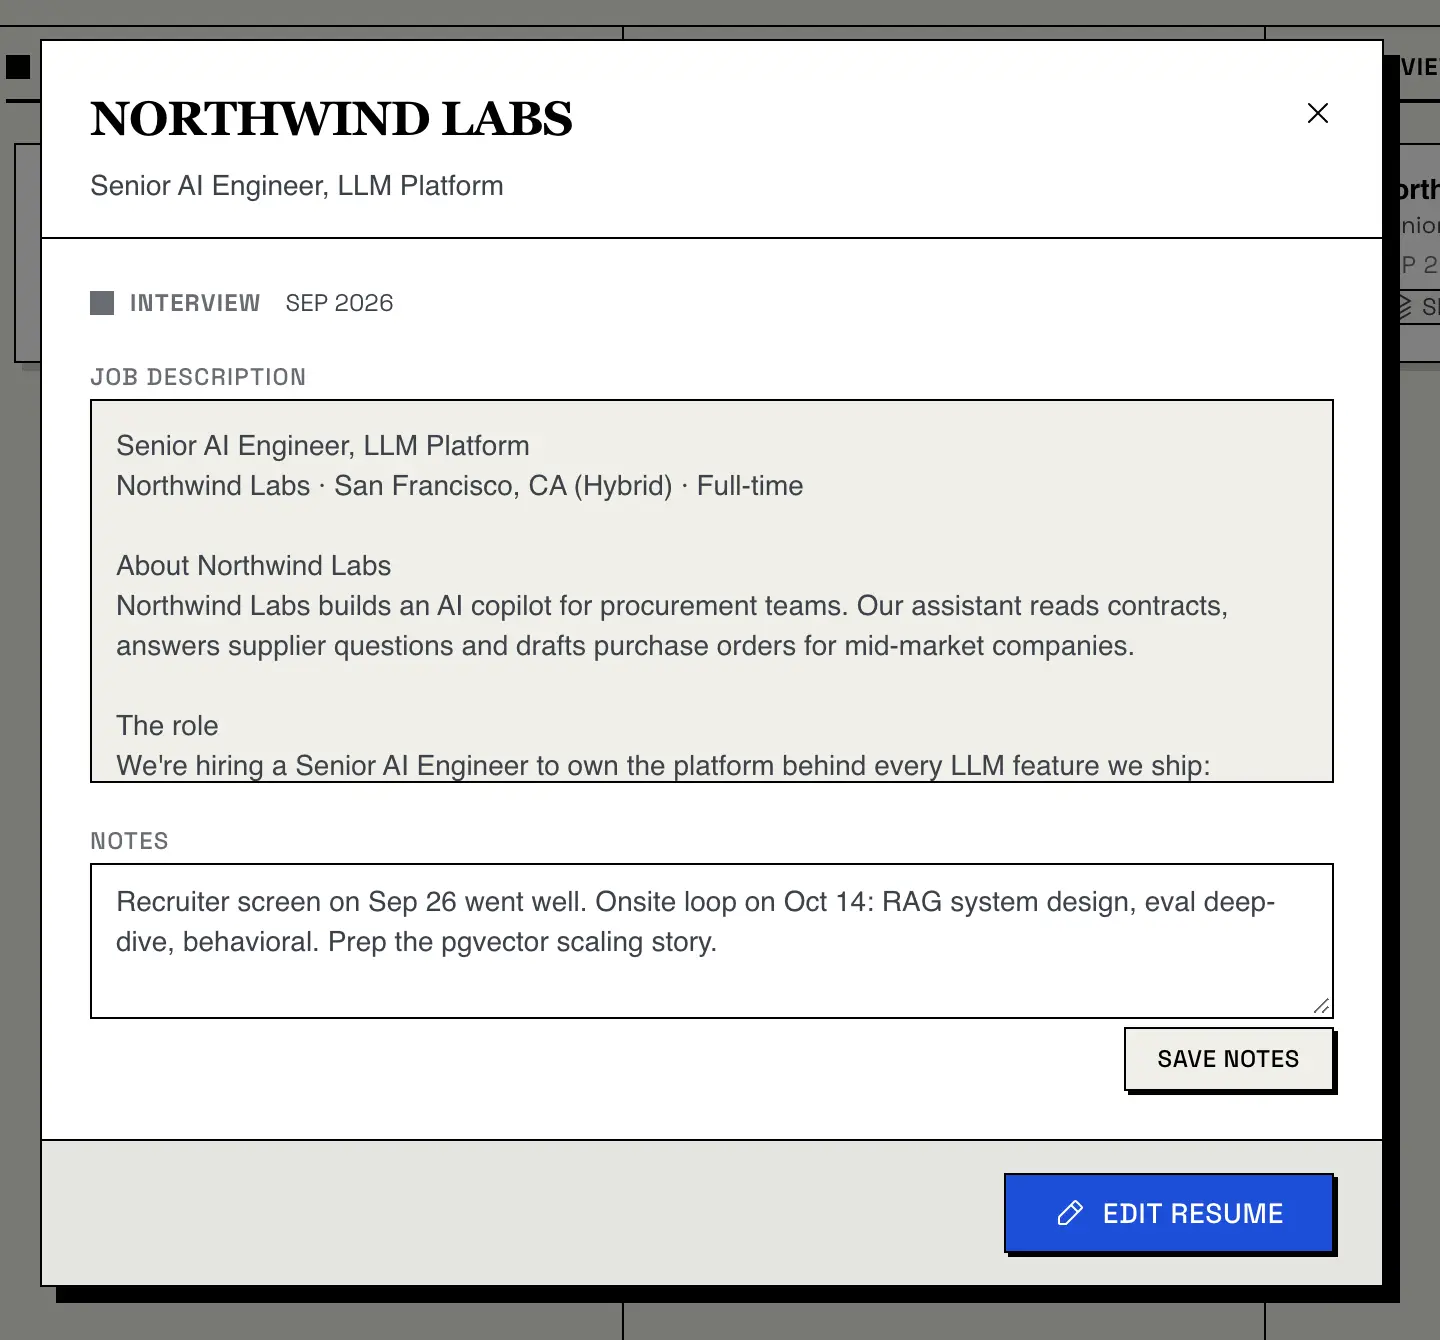
カードをクリックすると、求人内容の全文を読み、メモを残し、応募に使った履歴書そのものを開けます。「履歴書を編集」でビルダーに移動します。その履歴書がすでに削除されていても、カードは開き、その旨が表示されます。
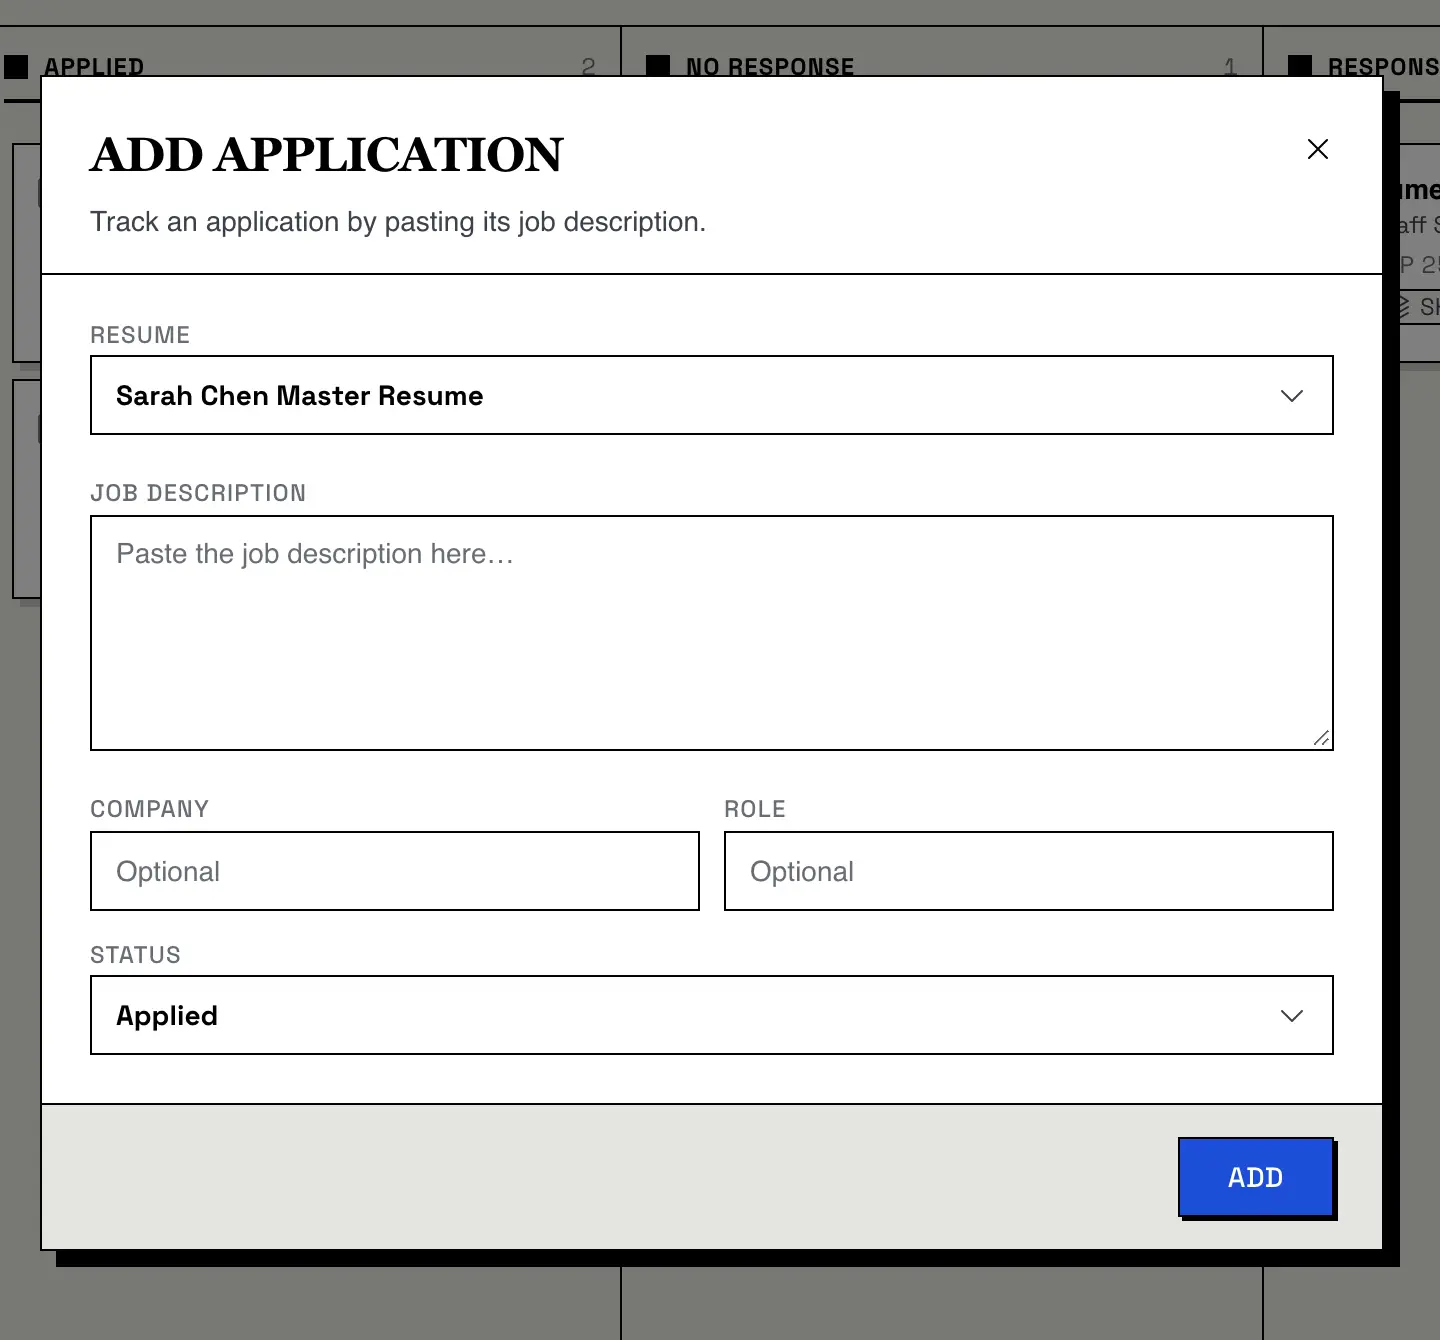
「応募を追加」をクリックし、履歴書を選び、求人内容を貼り付けて、最初のステージを選びます。あとでカスタマイズする予定の求人なら「保存済み」などです。会社名と職種は任意で、空欄にすれば AI が求人内容から抽出します。
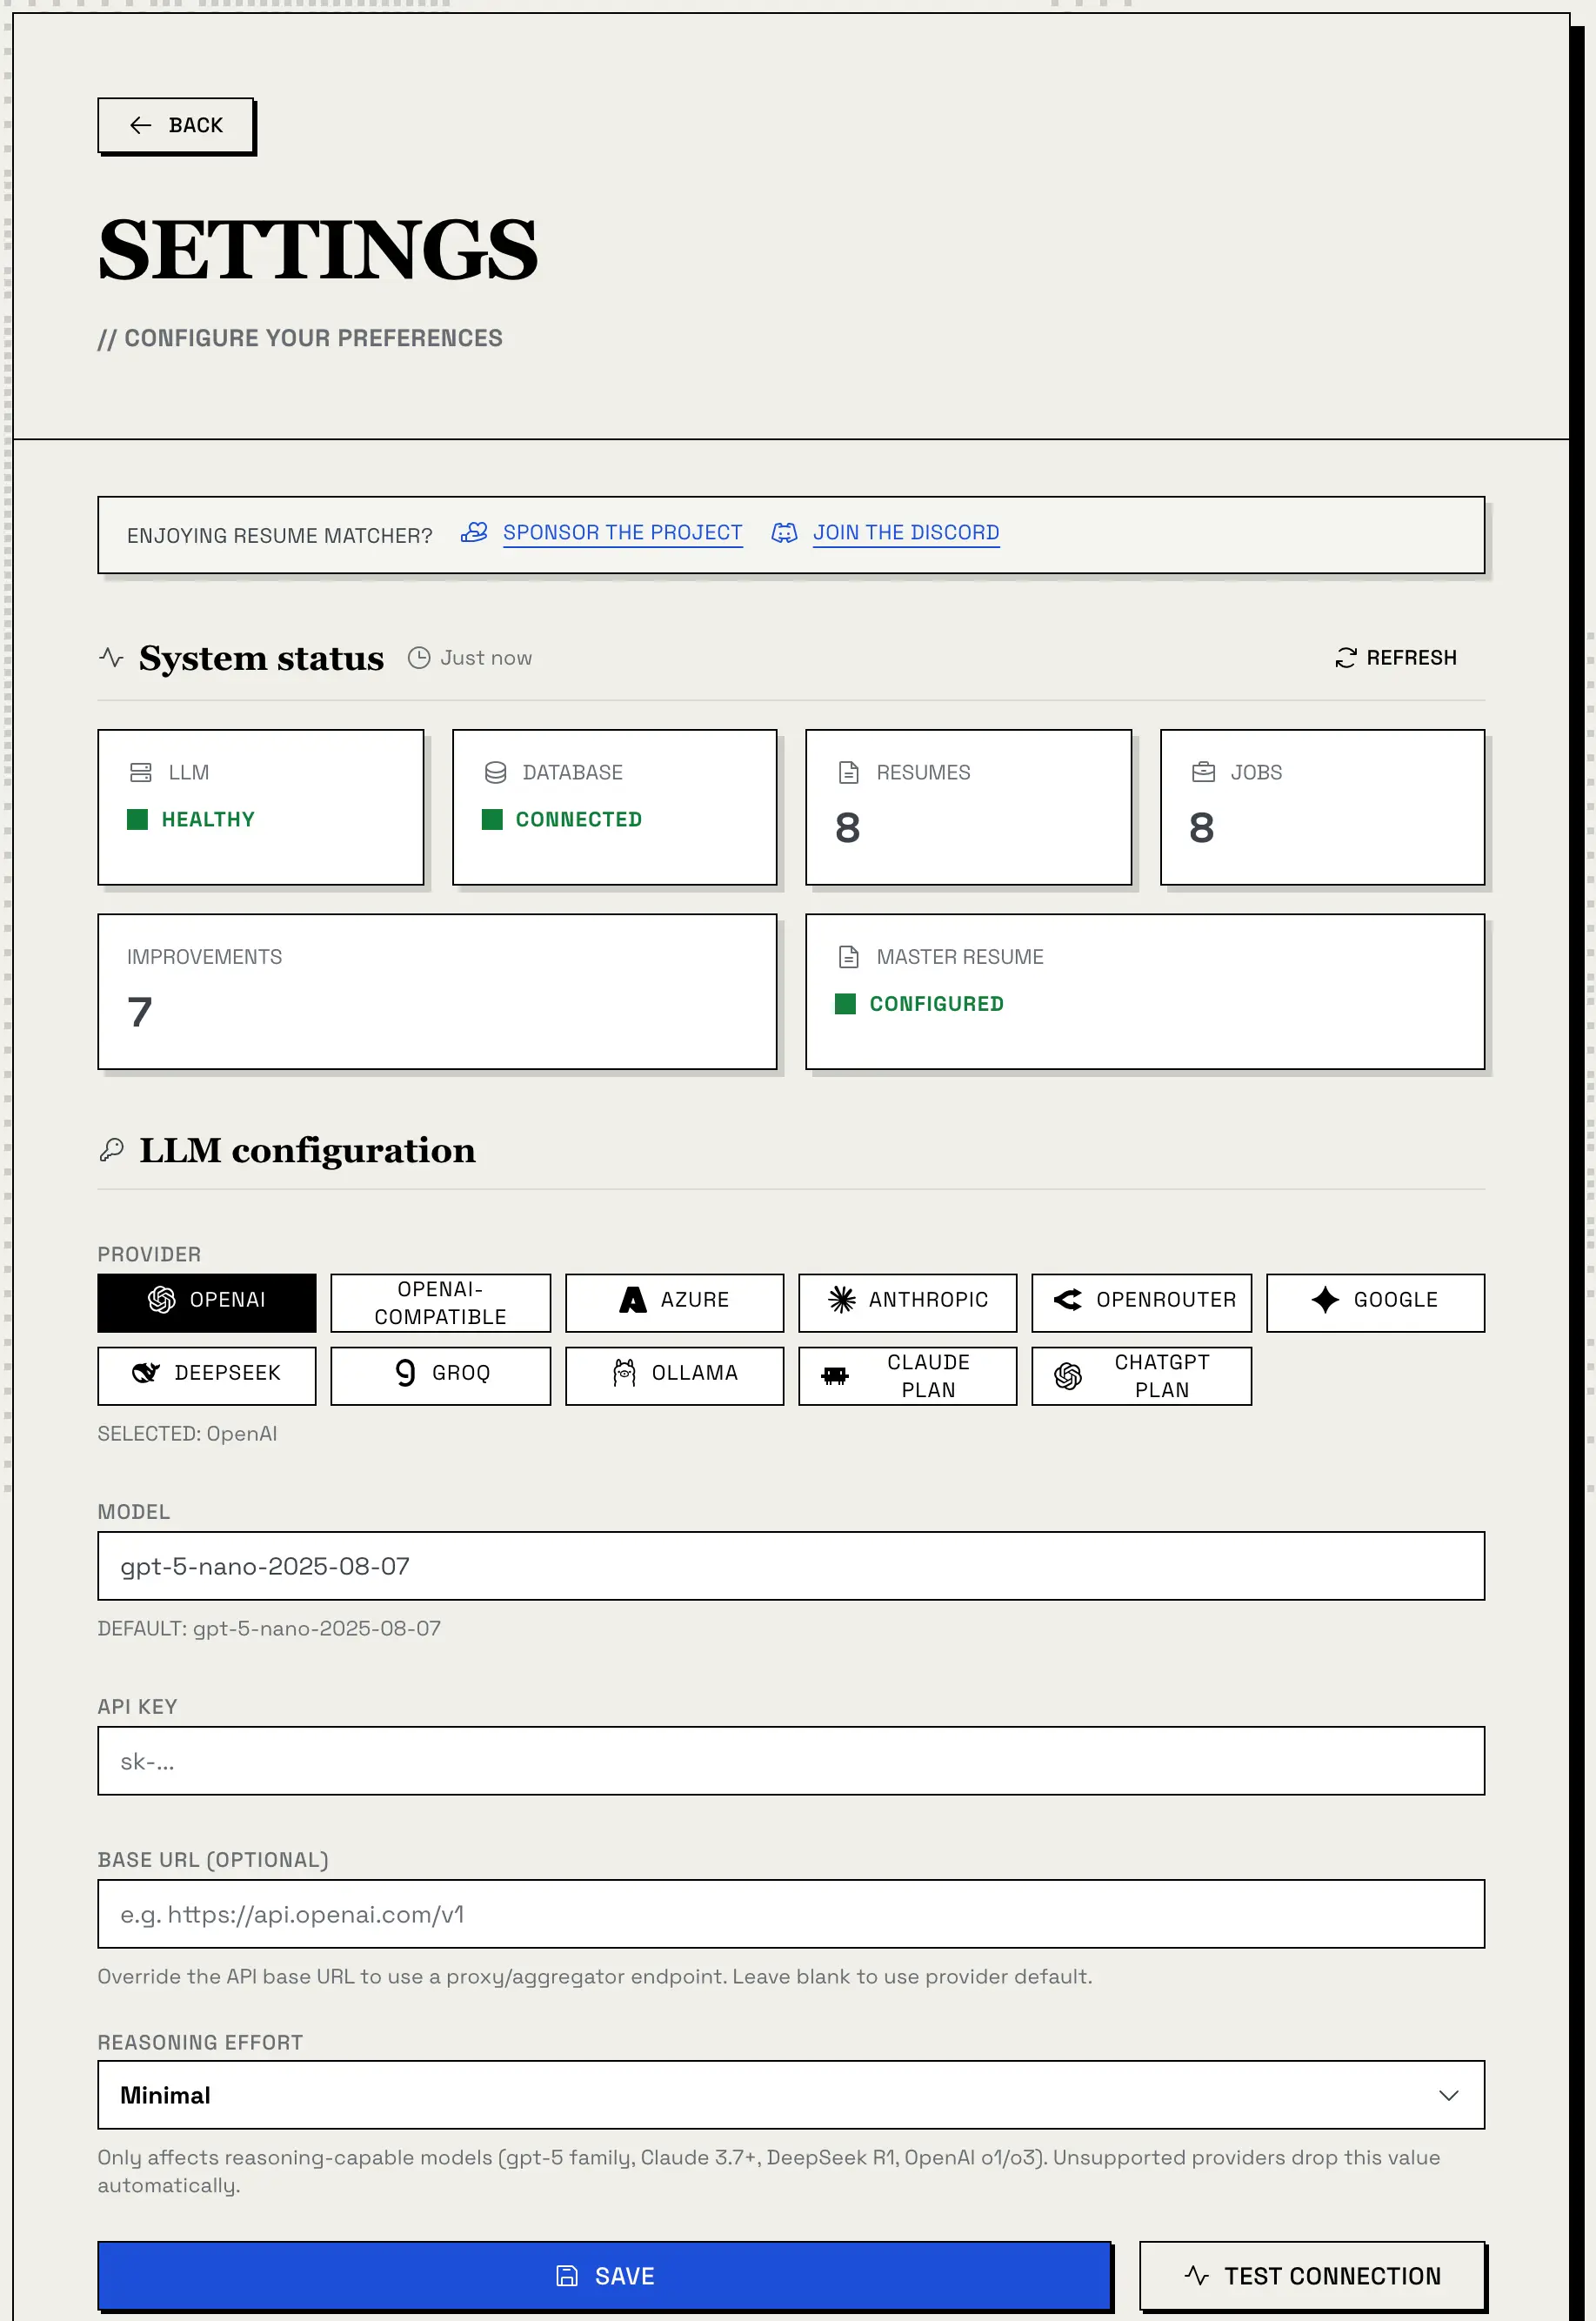
Resume Matcher には AI モデルが含まれていません。クラウドか自分のマシンでモデルを 1 つ接続すれば、プロンプト、チェック、書式はアプリが担当します。
11
のモデルの接続方法:API キー、自分のマシン、または契約しているプラン
7
つの言語(画面表示と AI の文章に対応)
0
アプリ内の分析・追跡コード
| プロバイダー | デフォルトモデル | 動作場所 |
|---|---|---|
| OpenAI | gpt-5-nano-2025-08-07 | クラウド |
| Anthropic (Claude) | claude-haiku-4-5-20251001 | クラウド |
| Google Gemini | gemini-3-flash-preview | クラウド |
| DeepSeek | deepseek-chat | クラウド |
| OpenRouter | deepseek/deepseek-chat | クラウド |
| Groq | llama-3.3-70b-versatile | クラウド |
| Azure AI Foundry | mistral-large-latest | クラウド |
| Ollama | gemma3:4b | 自分のマシン |
| OpenAI 互換サーバー(llama.cpp、vLLM、LM Studio) | 自分で入力 | 自分のマシン |
| ChatGPT プラン(Sign in with ChatGPT) | アカウントで使えるモデル | クラウド |
| Claude プラン(Claude Code 経由) | Claude Code のデフォルト | クラウド |
プロバイダーが提供している任意のモデル名を入力できます。公式な最低条件のモデルはありませんが、小さなモデルはカスタマイズの工程で使う構造化された編集形式を苦手とすることがあります。
設定画面(プロバイダー、モデル、API キー、プロキシやローカルサーバーにはベース URL。保存してから接続テスト)か、apps/backend/.env や Docker の環境の環境変数で設定します:LLM_PROVIDER、LLM_MODEL、LLM_API_KEY、必要なら LLM_API_BASE。プロバイダー名は小文字です(anthropic、ollama)。アプリで保存した設定は環境変数より優先されます。
{job_description}、{resume_data}、{output_language} のプレースホルダーを残せば、自分のものに置き換えられます。設定画面で入力した API キーは暗号化して保存されます。キーはプロバイダーごとに保存されるので、切り替えても別のプロバイダーのキーは消えません。ChatGPT と Claude のプランはキーが不要ですが、コミュニティ製で、先に読んでおくべき注意点があります。
Resume Matcher には MCP サーバーも付属しているので、Claude Code、Claude Desktop、Cursor、Codex から直接履歴書を扱えます。内容を書くのはクライアント側のモデルで、Resume Matcher はアプリ自身のデータベースでそれを保存、チェック、採点、描画し、独自の AI キーは不要です。Docker ではなく、ローカルインストールが必要です。
英語、スペイン語、中国語(簡体字)、日本語、ブラジルポルトガル語、フランス語、韓国語。UI言語は画面表示を切り替え、コンテンツ言語は AI がカスタマイズ履歴書、カバーレター、連絡メール、面接準備を書く言語です。2 つは別々に設定するので、画面は日本語、英文レジュメは英語、といった使い方ができます。PDF には中国語、日本語、韓国語のテキスト用に Noto Sans フォントが含まれています。
履歴書とカバーレターは PDF で書き出します。アプリはヘッドレスの Chromium で履歴書の印刷専用ページを開いて印刷するので、PDF には選択、コピー、ソフトウェアでの読み取りができる本物のテキストが含まれます。見出しは本物の見出しで、2 段組みのレイアウトでも読み取り順では本文が先に来て、テンプレート、フォント、間隔、用紙サイズはビルダーのとおりです。
書き出しにはフロントエンドの起動が必要です。ローカルでは Playwright の Chromium(uv run playwright install chromium)をインストールするか、Chrome か Edge をインストールしておいてください。Docker イメージにはすべて含まれています。
すべては 1 つのフォルダー apps/backend/data/、または Docker ボリュームにあります。resume_matcher.db は履歴書、求人内容、カスタマイズ版、トラッカーのボードを保存する SQLite データベースです(DATABASE_URL を設定すれば代わりに PostgreSQL)。config.json は秘密ではない設定、そして API キーは、あなたのユーザーアカウントだけが読める秘密鍵ファイルで暗号化して保存されます。
マシンの外に出るのは、あなたが実行した AI リクエストだけで、選んだプロバイダーに送られます。クラウドプロバイダーの場合、そこには連絡先を含む履歴書と求人内容が含まれます。アプリには分析や追跡のコードはありません。起動時に AI ライブラリ(LiteLLM)が公開されているモデルの価格表を取得しますが、このリクエストにあなたのデータは含まれません。Ollama などのローカルモデルサーバーを使えば、履歴書、求人内容、AI の出力はすべてあなたのコンピューターに残ります。
いちばん速いのは Docker です。Resume Matcher は 1 つのコンテナイメージとして、Docker-Sponsored Open Source のイメージである Docker Hub と、GitHub Container Registry で公開されており、どちらも linux/amd64 と linux/arm64 向けにビルドされています。そのあと http://localhost:3000/settings を開いてモデルを接続します。
リポジトリからビルドする場合は、クローンして Docker Compose で起動します:git clone、続いて docker compose up -d。
resume-data ボリュームにデータベースと設定が保存されるので、コンテナを更新してもデータは残ります。再現可能なデプロイのためにはバージョンを固定してください(例::1.3.0)。ソースから動かす場合は Python 3.13+、Node.js 22+、npm、uv が必要です。
$ git clone https://github.com/srbhr/Resume-Matcher.git$ cd Resume-Matcher$ docker compose up -d$ docker run --name resume-matcher -p 3000:3000 \ -v resume-data:/app/backend/data \ srbhr/resume-matcher:latest# そのあと開く http://localhost:3000/settings
ホスティングされたウェブサイトではありません。ローカルまたは Docker で自分で動かします。1 人で使うことを前提にしています。
応募はしません。求人サイトや企業のシステムにも接続しません。トラッカーはあなた自身の記録です。
ATS があなたをどう順位付けするかは予測しません。ATSチェックは自身の PDF からテキストが読み戻せるかを調べ、スコアはキーワードとセクションのヒューリスティックです。どれも雇用主のソフトウェアをシミュレーションしません。
ゼロから履歴書を書くことはしません。アップロードした履歴書か、ウィザードへの回答をもとにします。
スキャンした PDF は読めません。ファイルにはテキスト層が必要です。
書き出しは PDF だけです。Word ファイルは入力としては受け付けますが、出力はできません。
バックエンド、フロントエンド、SRE、ML:次に狙う求人を貼り付けて、その技術スタックの言葉で語る履歴書を送りましょう。無料、オープンソース、そして自分のマシンで動きます。