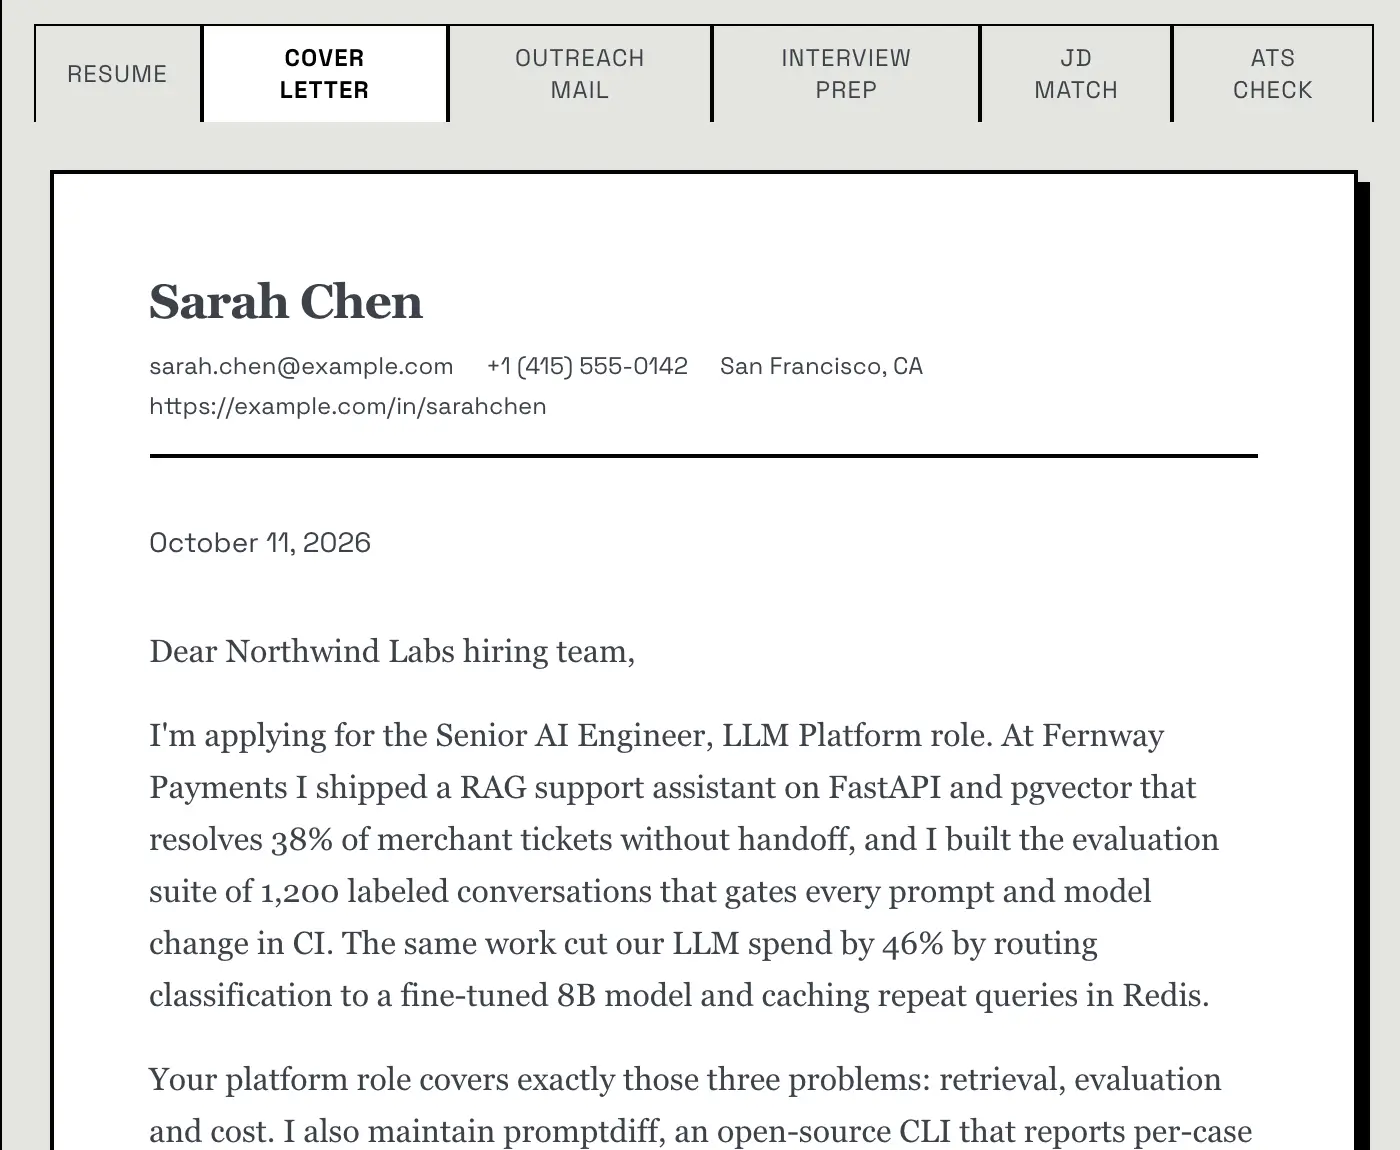
求职信
一封 100 到 150 词的简短信件,根据你的简历针对具体职位撰写。提示词要求模型不编造简历里没有的任何内容。在打印版式旁边编辑它,然后保存、重新生成,或下载为 PDF。
Resume Matcher 的全部功能,按你使用的顺序排列。粘贴职位描述,审核 AI 提出的每一处修改,在简历生成器里完善简历,写好求职信,再追踪这份申请。一切都在你自己的电脑上运行,使用你选择的 AI 模型。
接入 AI 模型。在设置页面里接入:使用你自己 API 密钥的云端服务商,或者本地模型。
添加主简历。上传 PDF 或 Word 文件,或者用简历向导创建一份。
粘贴职位描述。AI 会针对你的主简历提出定向修改。
审核修改。在修改前后的对比预览里查看,然后确认或重新生成。
在简历生成器里润色。选择模板,调整布局,编辑任何内容。
生成配套材料。为同一个职位生成求职信、联系邮件和面试准备。
下载。简历和求职信,均为 PDF。
追踪申请。在看板上追踪。确认一份定制简历时,会自动为它添加卡片。
定制只改写你简历里已有的内容。它不会编造经历;在定制页面上,你读过并确认修改之前,什么都不会保存。
2 页
默认页数上限,相关性最低的要点会被删减以符合页数
0
新增数字:改写后多出数字的句子会被还原
4 分钟
每次定制的默认时间上限
主简历是你完整、未经定制的简历:所有工作、项目和技能都在一处。上传不超过 4 MB 的 PDF、DOC 或 DOCX 文件,AI 会把它转换成可编辑的结构化板块,并保留一份原始文本。扫描件这类纯图片 PDF 没有文本层,会被拒绝;请先用 OCR 处理。
没有简历文件?简历向导一次问一个问题,最多 15 个,并在你回答的同时把简历写进实时草稿。它被明确要求绝不编造雇主、职位、日期、学位、证书、指标、工具或技能。
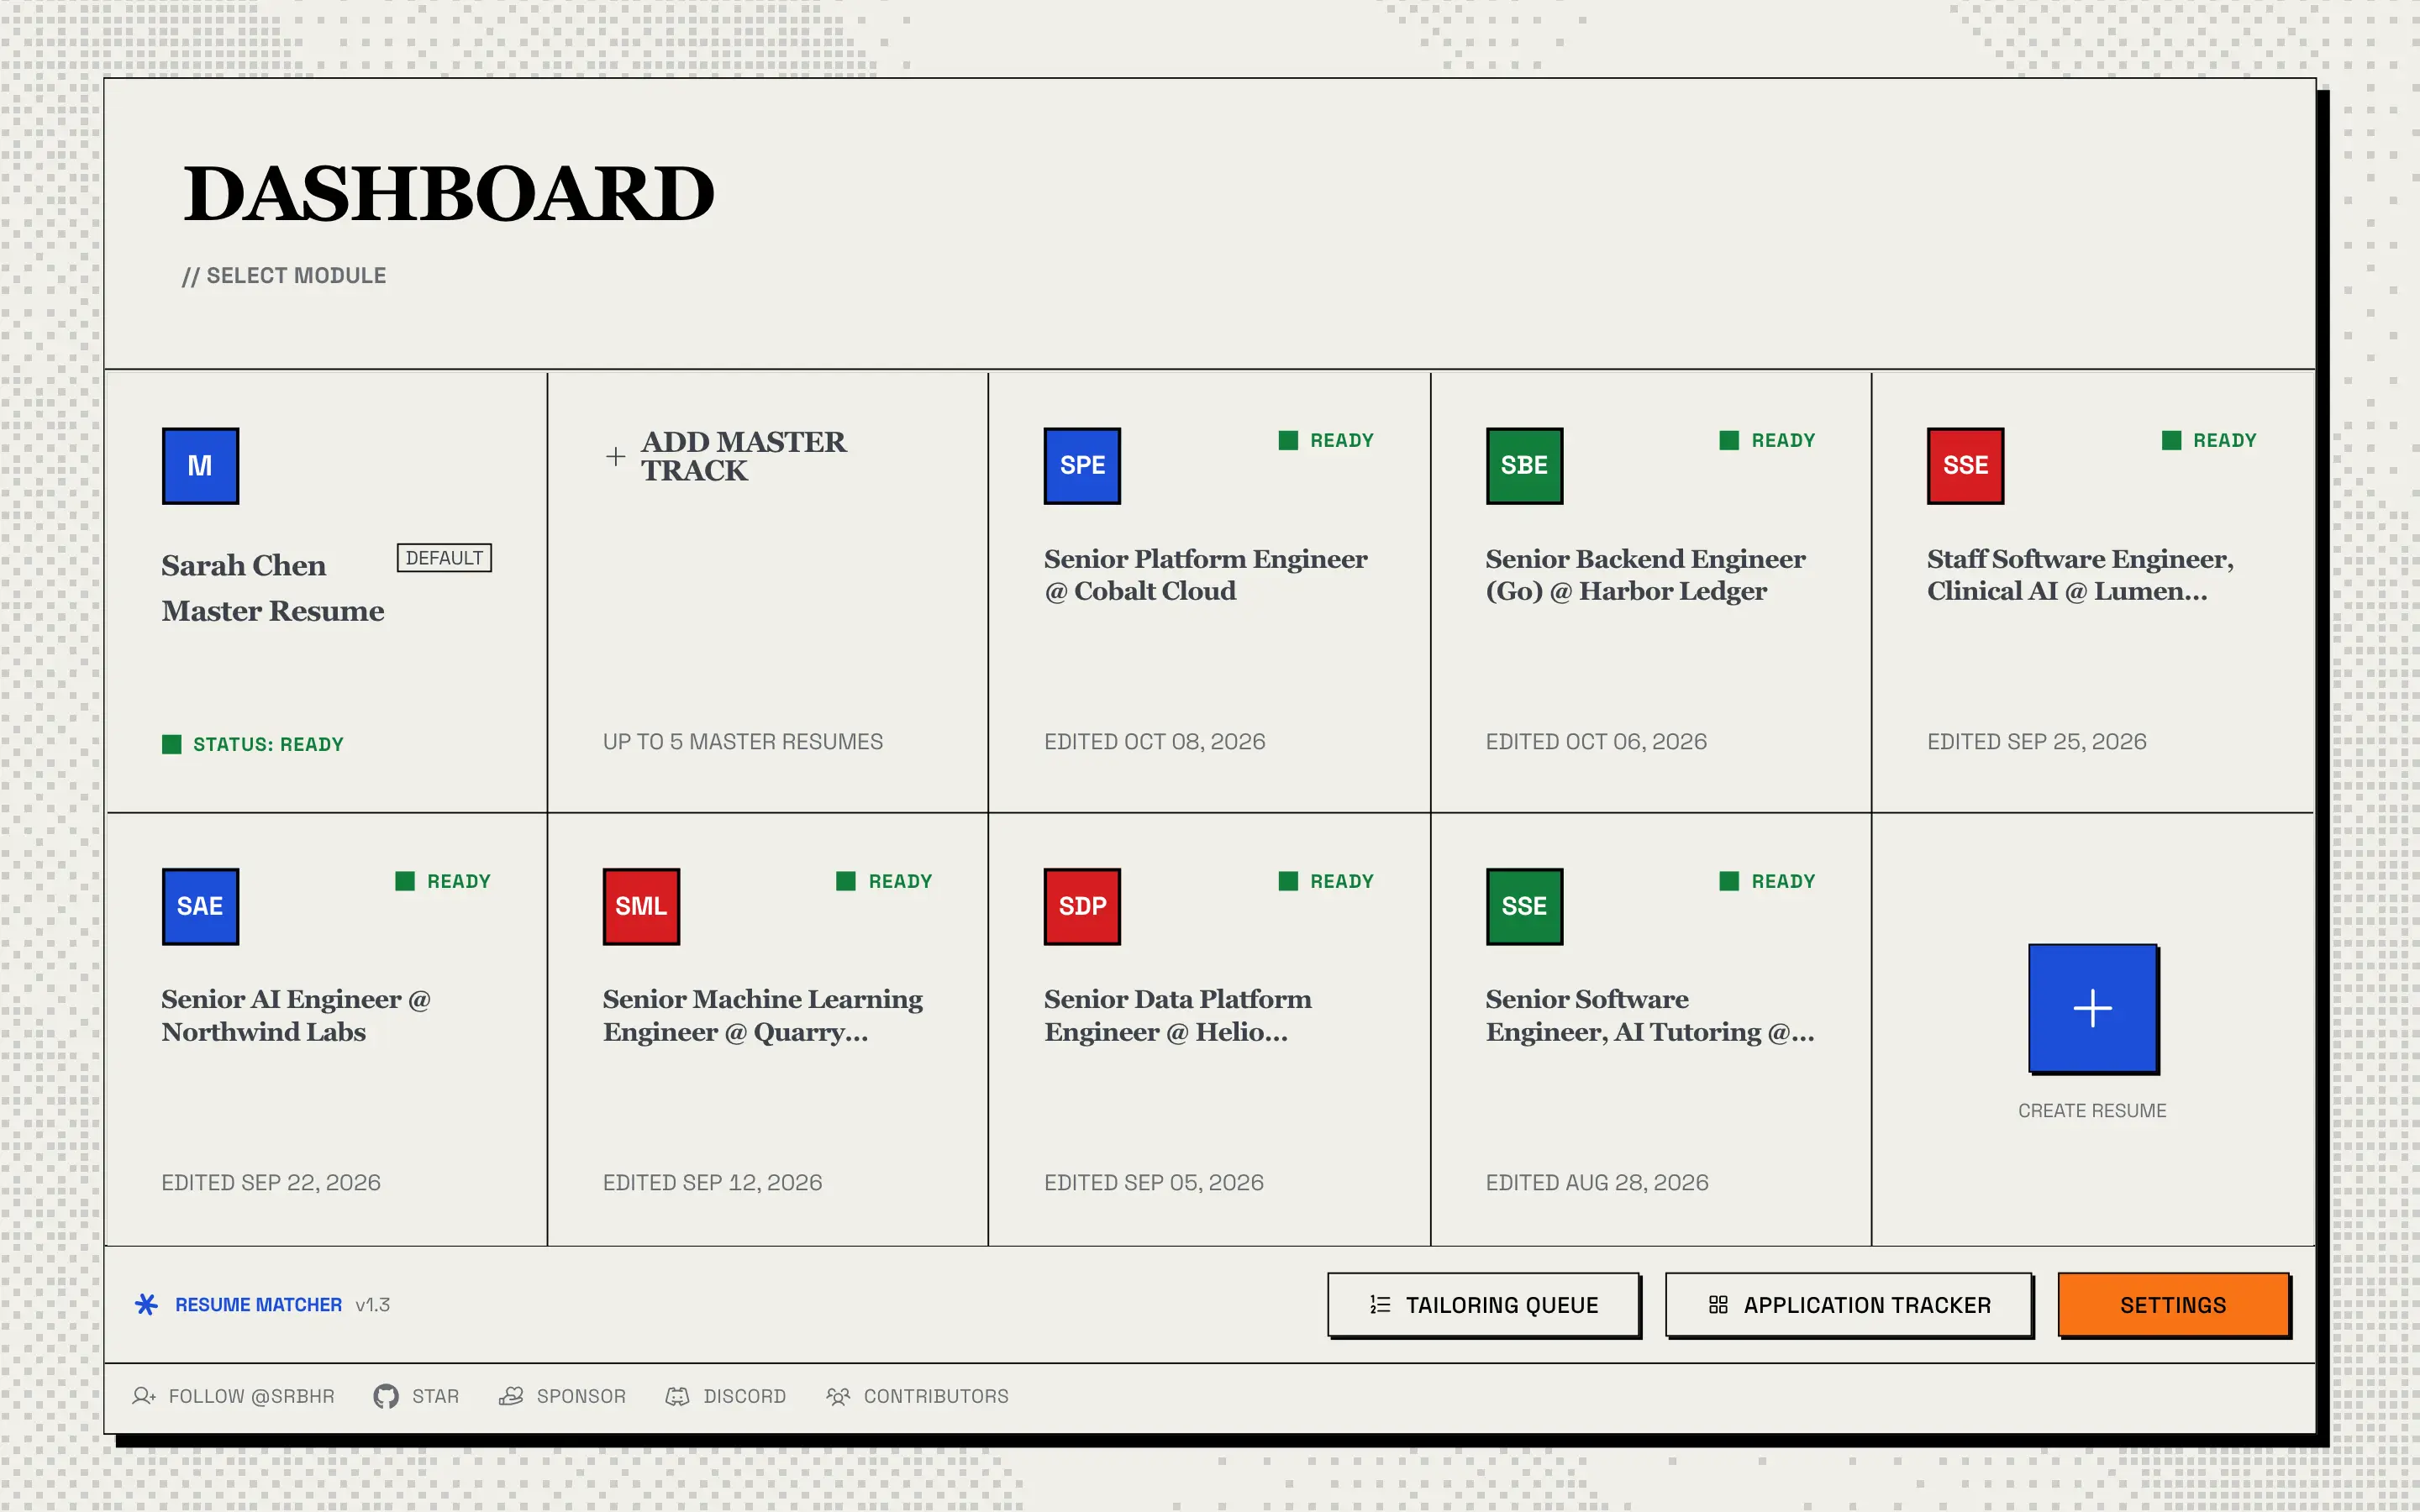
最多可以保留五份主简历,作为不同的职业方向,比如一份投后端岗位,一份投机器学习岗位。其中恰好有一份是默认简历,定制页面从它开始。
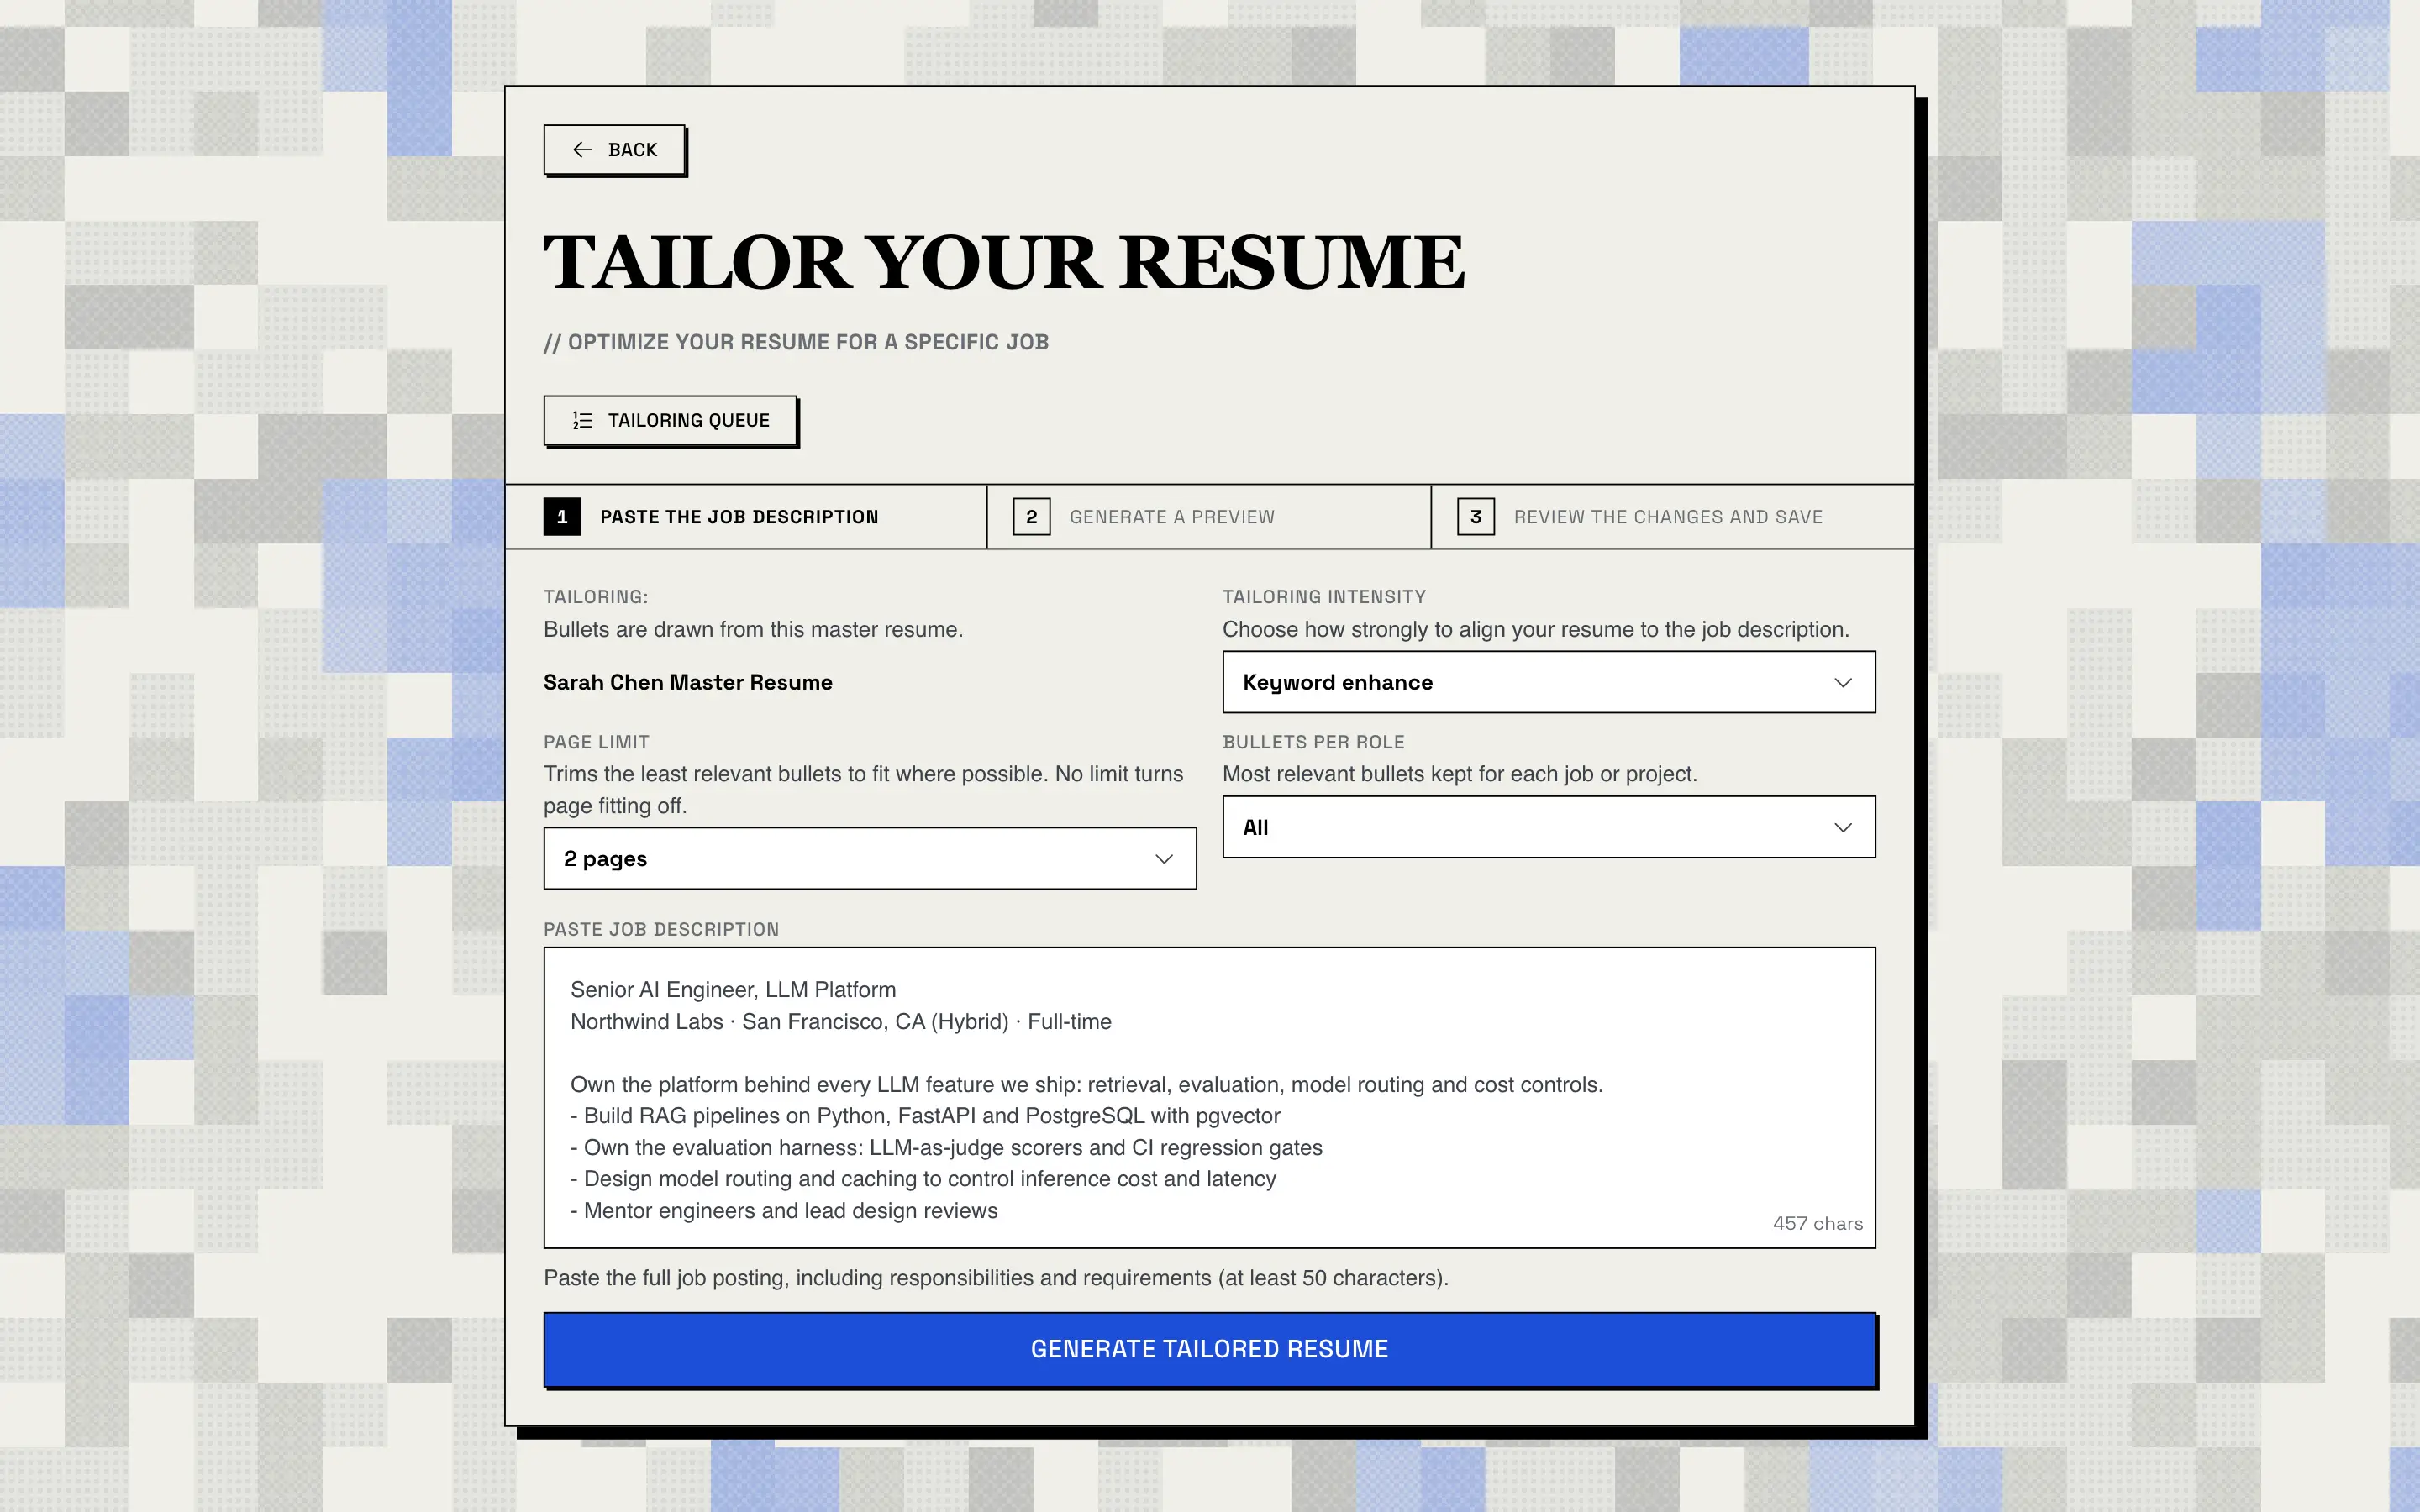
选好定制强度,设置页数上限(1–3 页,或不限)和每段经历保留的要点数,粘贴职位描述(最多 100,000 个字符),然后点击「生成定制简历」。
AI
AI 提取公司、职位、必备和加分技能、主要职责以及关键词。这些信息随职位一起保存,所以之后追踪卡片无需再调用一次 AI,就能拿到公司和职位。
AI 代码
AI 为每条要点打分,评估它与职位的相关度。它只打分,不能改写或编造要点。然后由代码在你设定的上限内,为每段工作或每个项目保留最相关的要点,并通过实际渲染页面,从相关性最低的要点开始删减,直到简历符合你的页数上限。
AI 代码
AI 提出要突出哪些技能。代码只接受满足以下条件之一的技能:已经在你的简历里、出现在你简历的文本中,或者是在职位描述里逐字出现的必备或加分技能。
AI 代码
AI 不会重写整份简历,而是返回一份具体的修改清单,每条都引用它要替换的原文。代码会对照你的简历核实每一处引用,并拒绝针对受保护字段的修改。
代码
代码会还原你的个人信息和日期,保留所有原有技能,删除一批用滥了的「AI 腔」短语(除非职位描述里用到了它们);如果某行改写引入了原文没有的数字,就撤销这行改写。
整个流程有时间上限,默认四分钟,慢速模型不会让应用卡住。
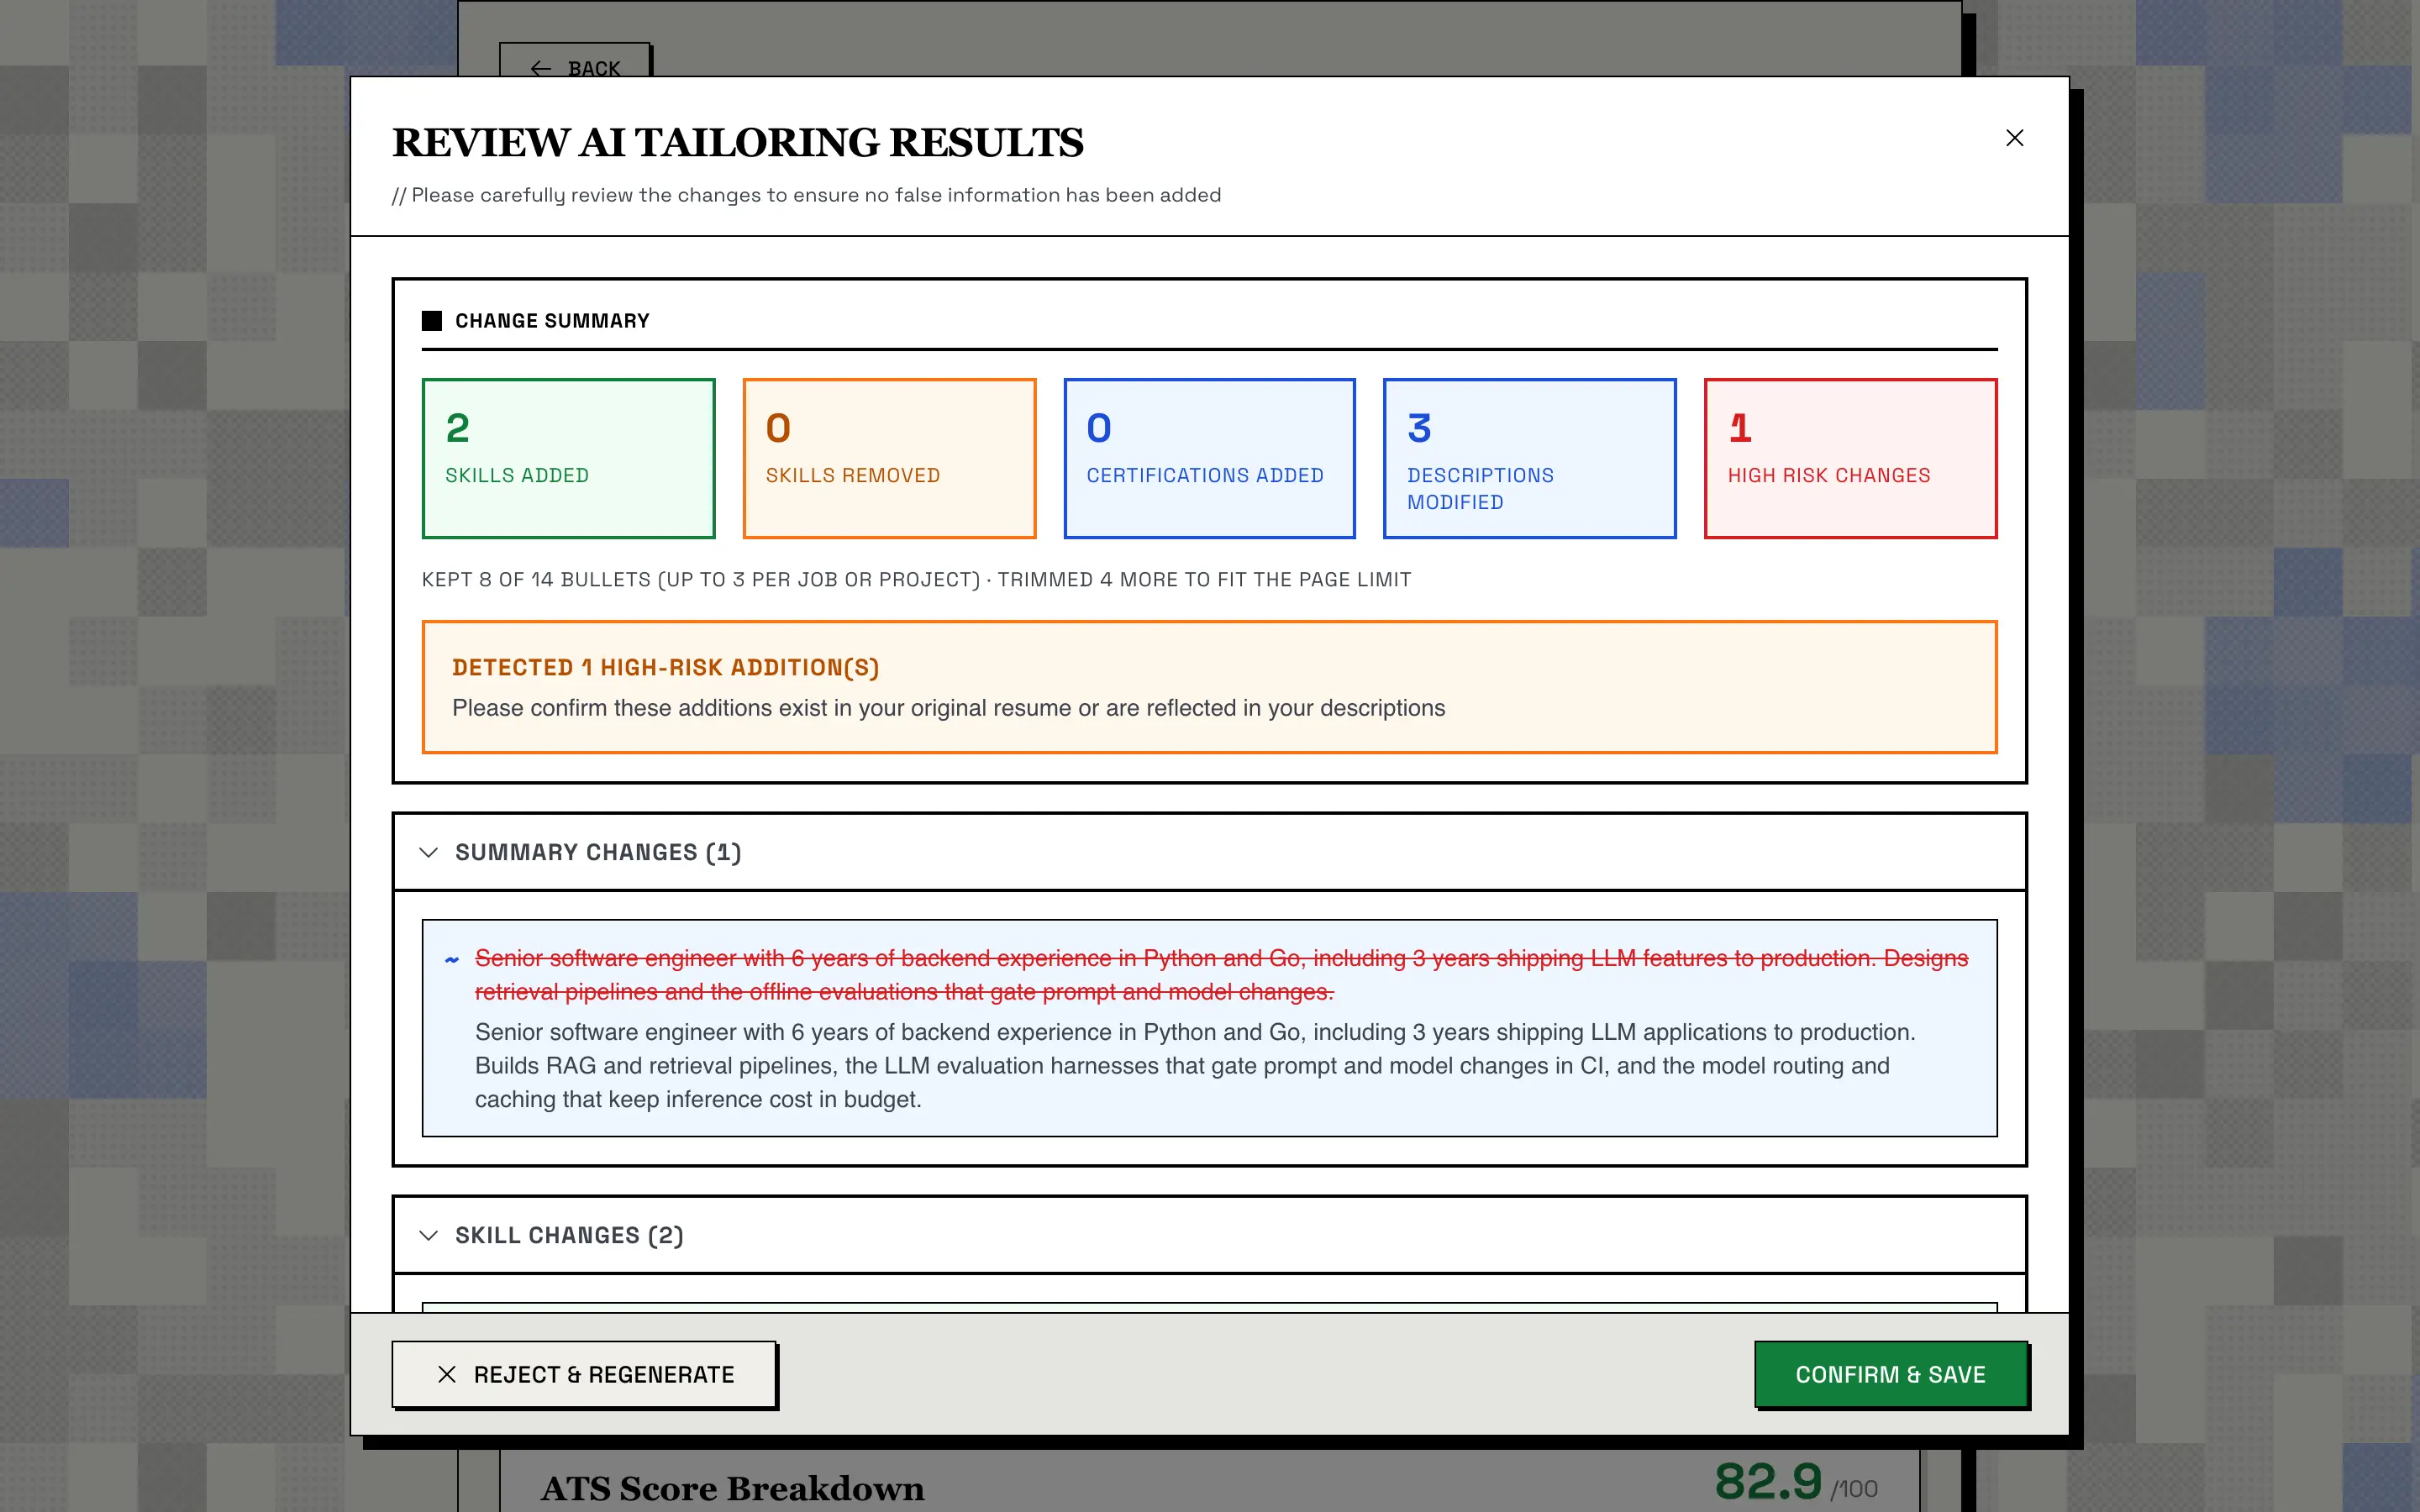
预览会显示:
变更摘要:新增和删除的技能、新增的证书、修改的描述,以及高风险变更。
要点筛选的结果,例如「已保留 14 条要点中的 8 条(每个职位或项目最多 3 条)· 为符合页数上限又删减了 4 条」。
当 AI 添加了内容(通常是取自职位描述的技能)时,会显示高风险警告,方便你确认它对你来说属实。
个人简介、技能和每条改动过的要点的修改前后对比。
确认并保存保留结果;拒绝并重新生成丢弃结果并重试。这个决定针对整个预览。护栏能拦住编造的数字、雇主和日期,但措辞仍可能夸大你的角色。请读完每一处修改:你是最后一道检查。
确认后,这份定制简历会另存为一份标题为「职位 @ 公司」的新简历,并关联到它的主简历和职位。它的卡片会出现在追踪看板的「已投递」列;如果你在设置里开启了相应开关,还会同时生成求职信、联系邮件和面试准备。所有内容都可以在简历生成器里继续编辑。
生成预览时,表单下方会出现一张 ATS Score Breakdown(ATS 评分明细)卡片。它是一个加权的启发式评分,综合关键词匹配、技能覆盖、职位名称匹配、板块完整度和日期格式一致性,不是对任何真实申请人跟踪系统的模拟。确认后,它会随定制简历一起保存。
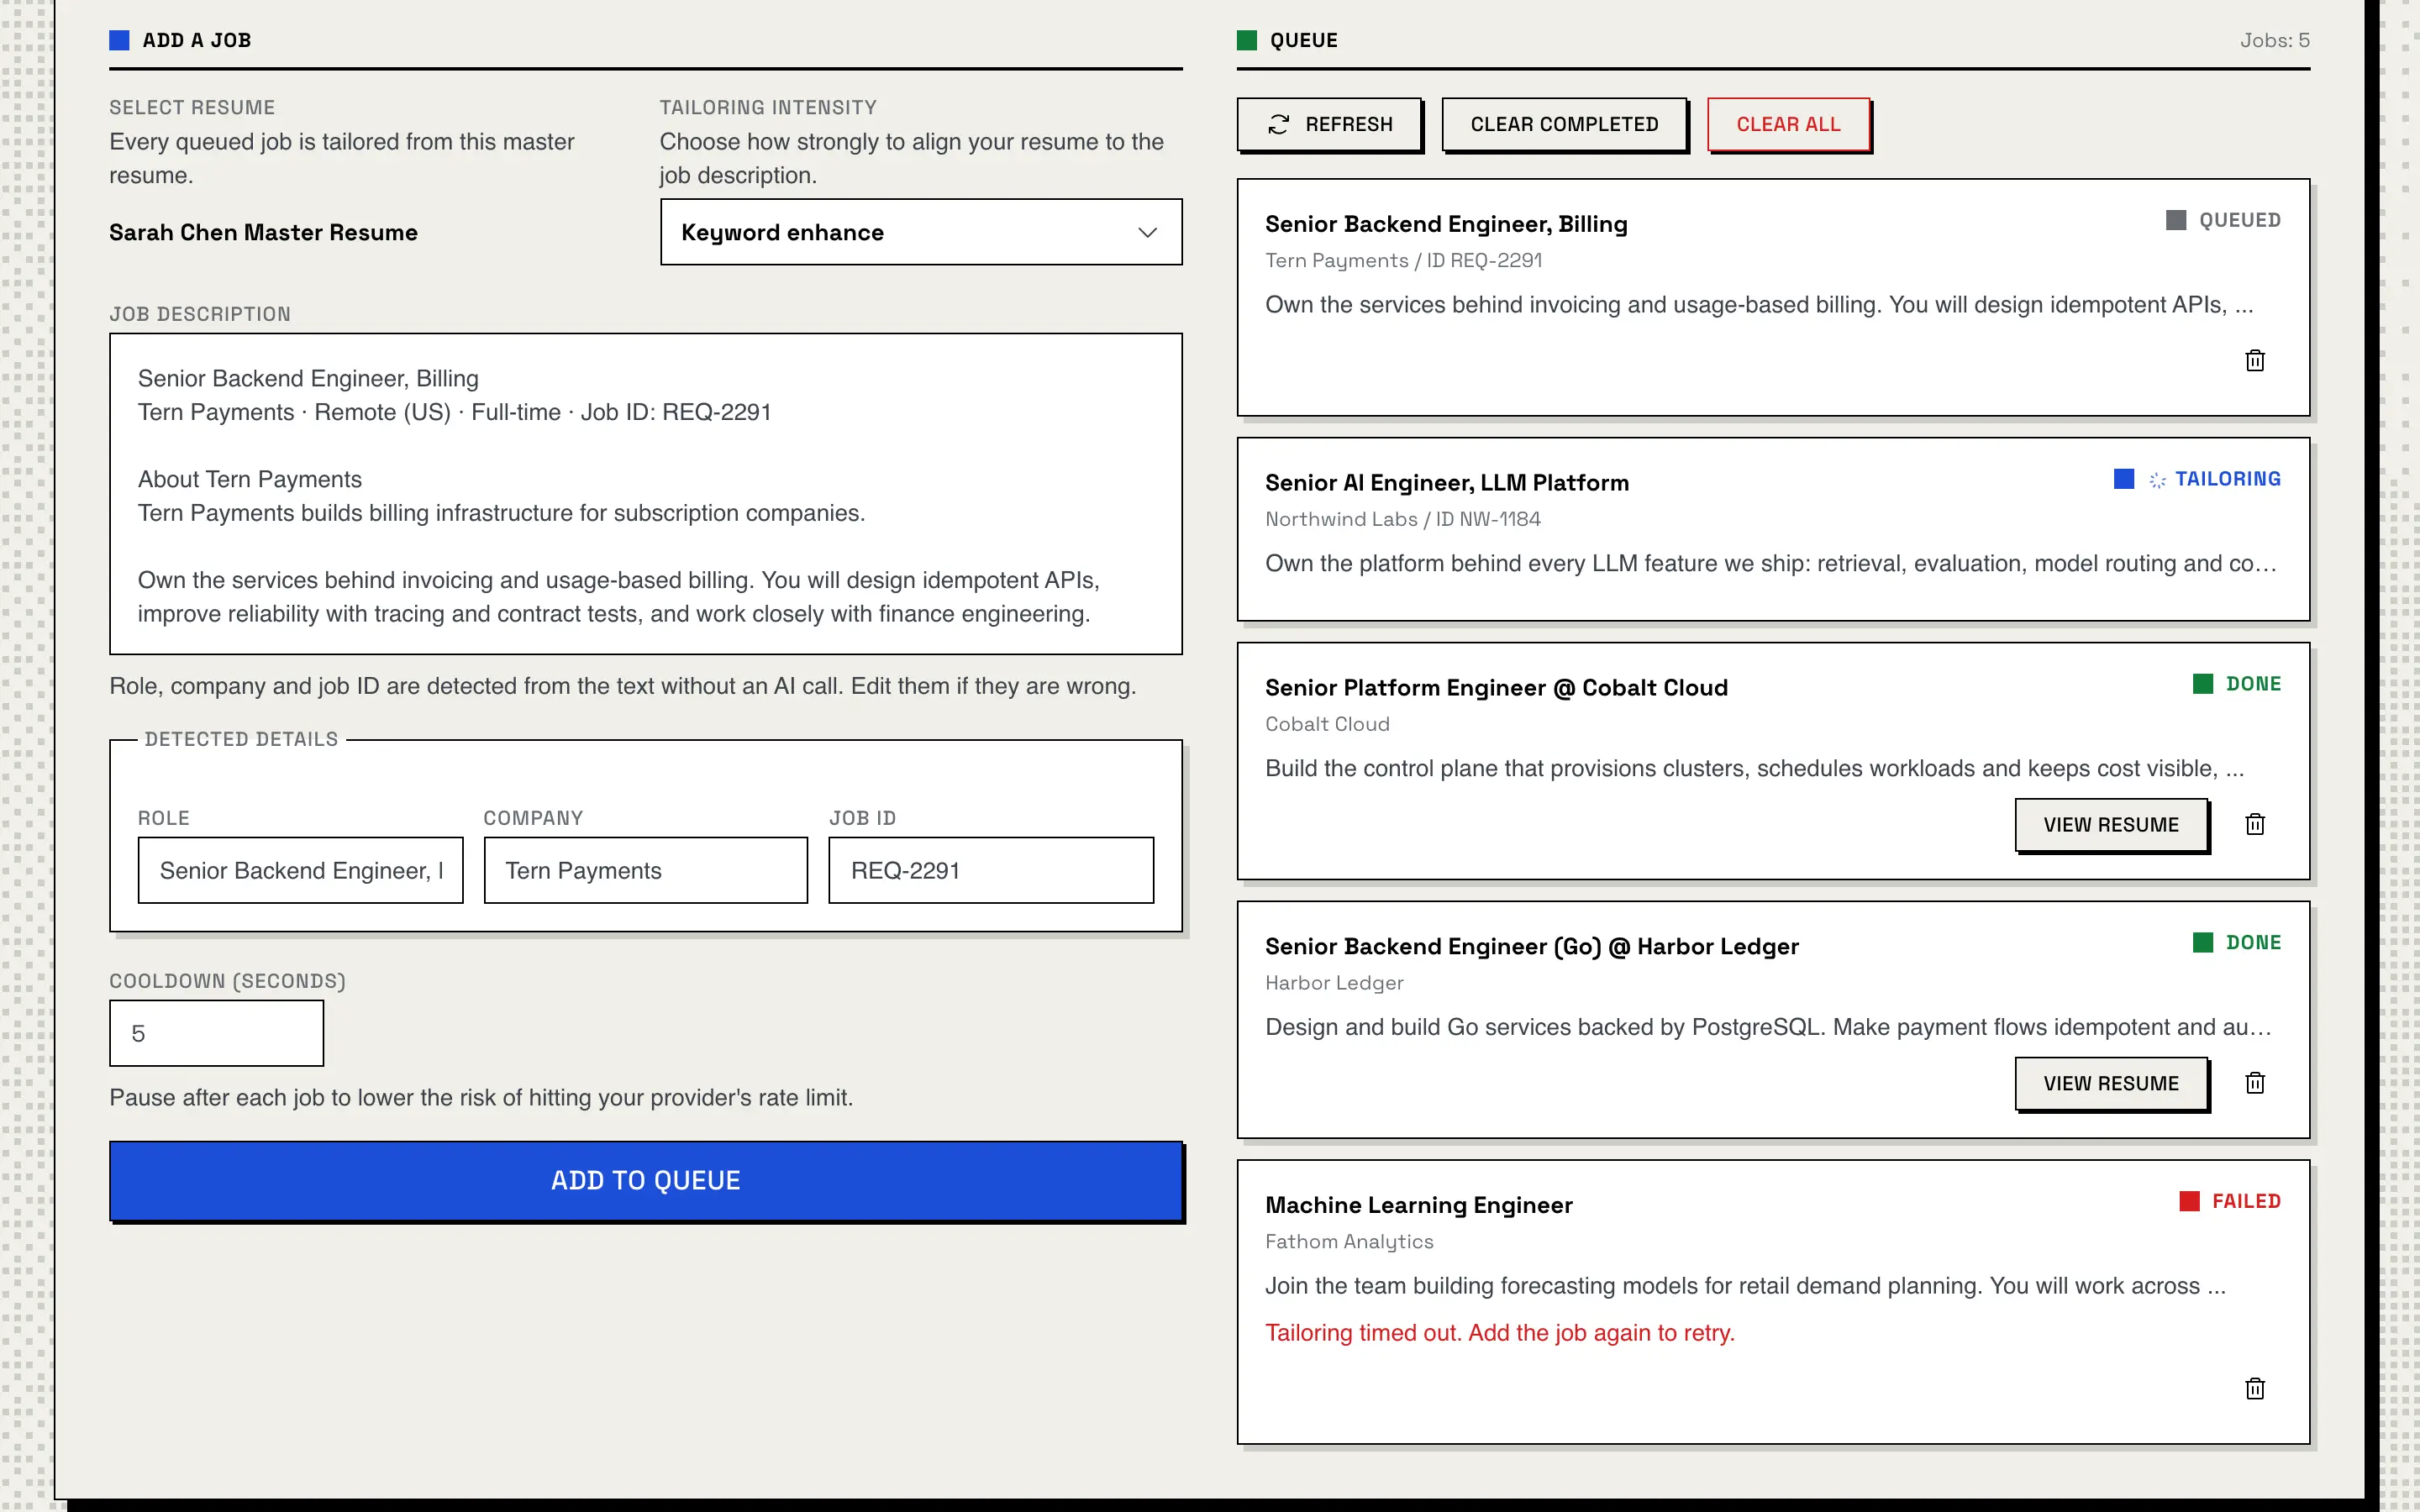
同时申请好几个职位?把每份职位描述粘贴进定制队列,Resume Matcher 会逐一定制,每两个职位之间有一段短暂的间隔(默认 5 秒),以免触发服务商的速率限制。职位名称、公司和职位编号直接从文本中识别,无需调用 AI。
队列中的职位会跳过审核步骤。每个职位都会执行同样的定向修改和安全网,然后直接保存为定制简历,同时生成追踪卡片、ATS 评分,以及你在设置里开启的配套材料。队列会保留所有要点,也不考虑页数上限,所以发送之前,请在简历生成器里读一遍每份结果。
队列保存在数据库里,所以刷新页面或重启后依然存在。失败的职位(比如运行超过了时间上限)不会重试,需要重新添加。
定制的设计目标是改写,而不是编造。这些规则由代码强制执行,而不只是在提示词里提出要求。
用职位描述的措辞改写你的个人简介和要点
重新排序并突出技能
选择保留哪些要点,不超出你设定的页数上限和每段经历的要点数
添加职位要求的技能,前提是它在职位描述里逐字出现(会被标记为高风险)
修改你的姓名、邮箱、电话、所在地或链接
修改雇主、职位名称或日期
修改学校、学位或教育经历的日期
添加原文里没有的数字、百分比或指标
删除你已有的技能、证书、语言或奖项
添加新的工作、学校或项目
改动你的自定义板块
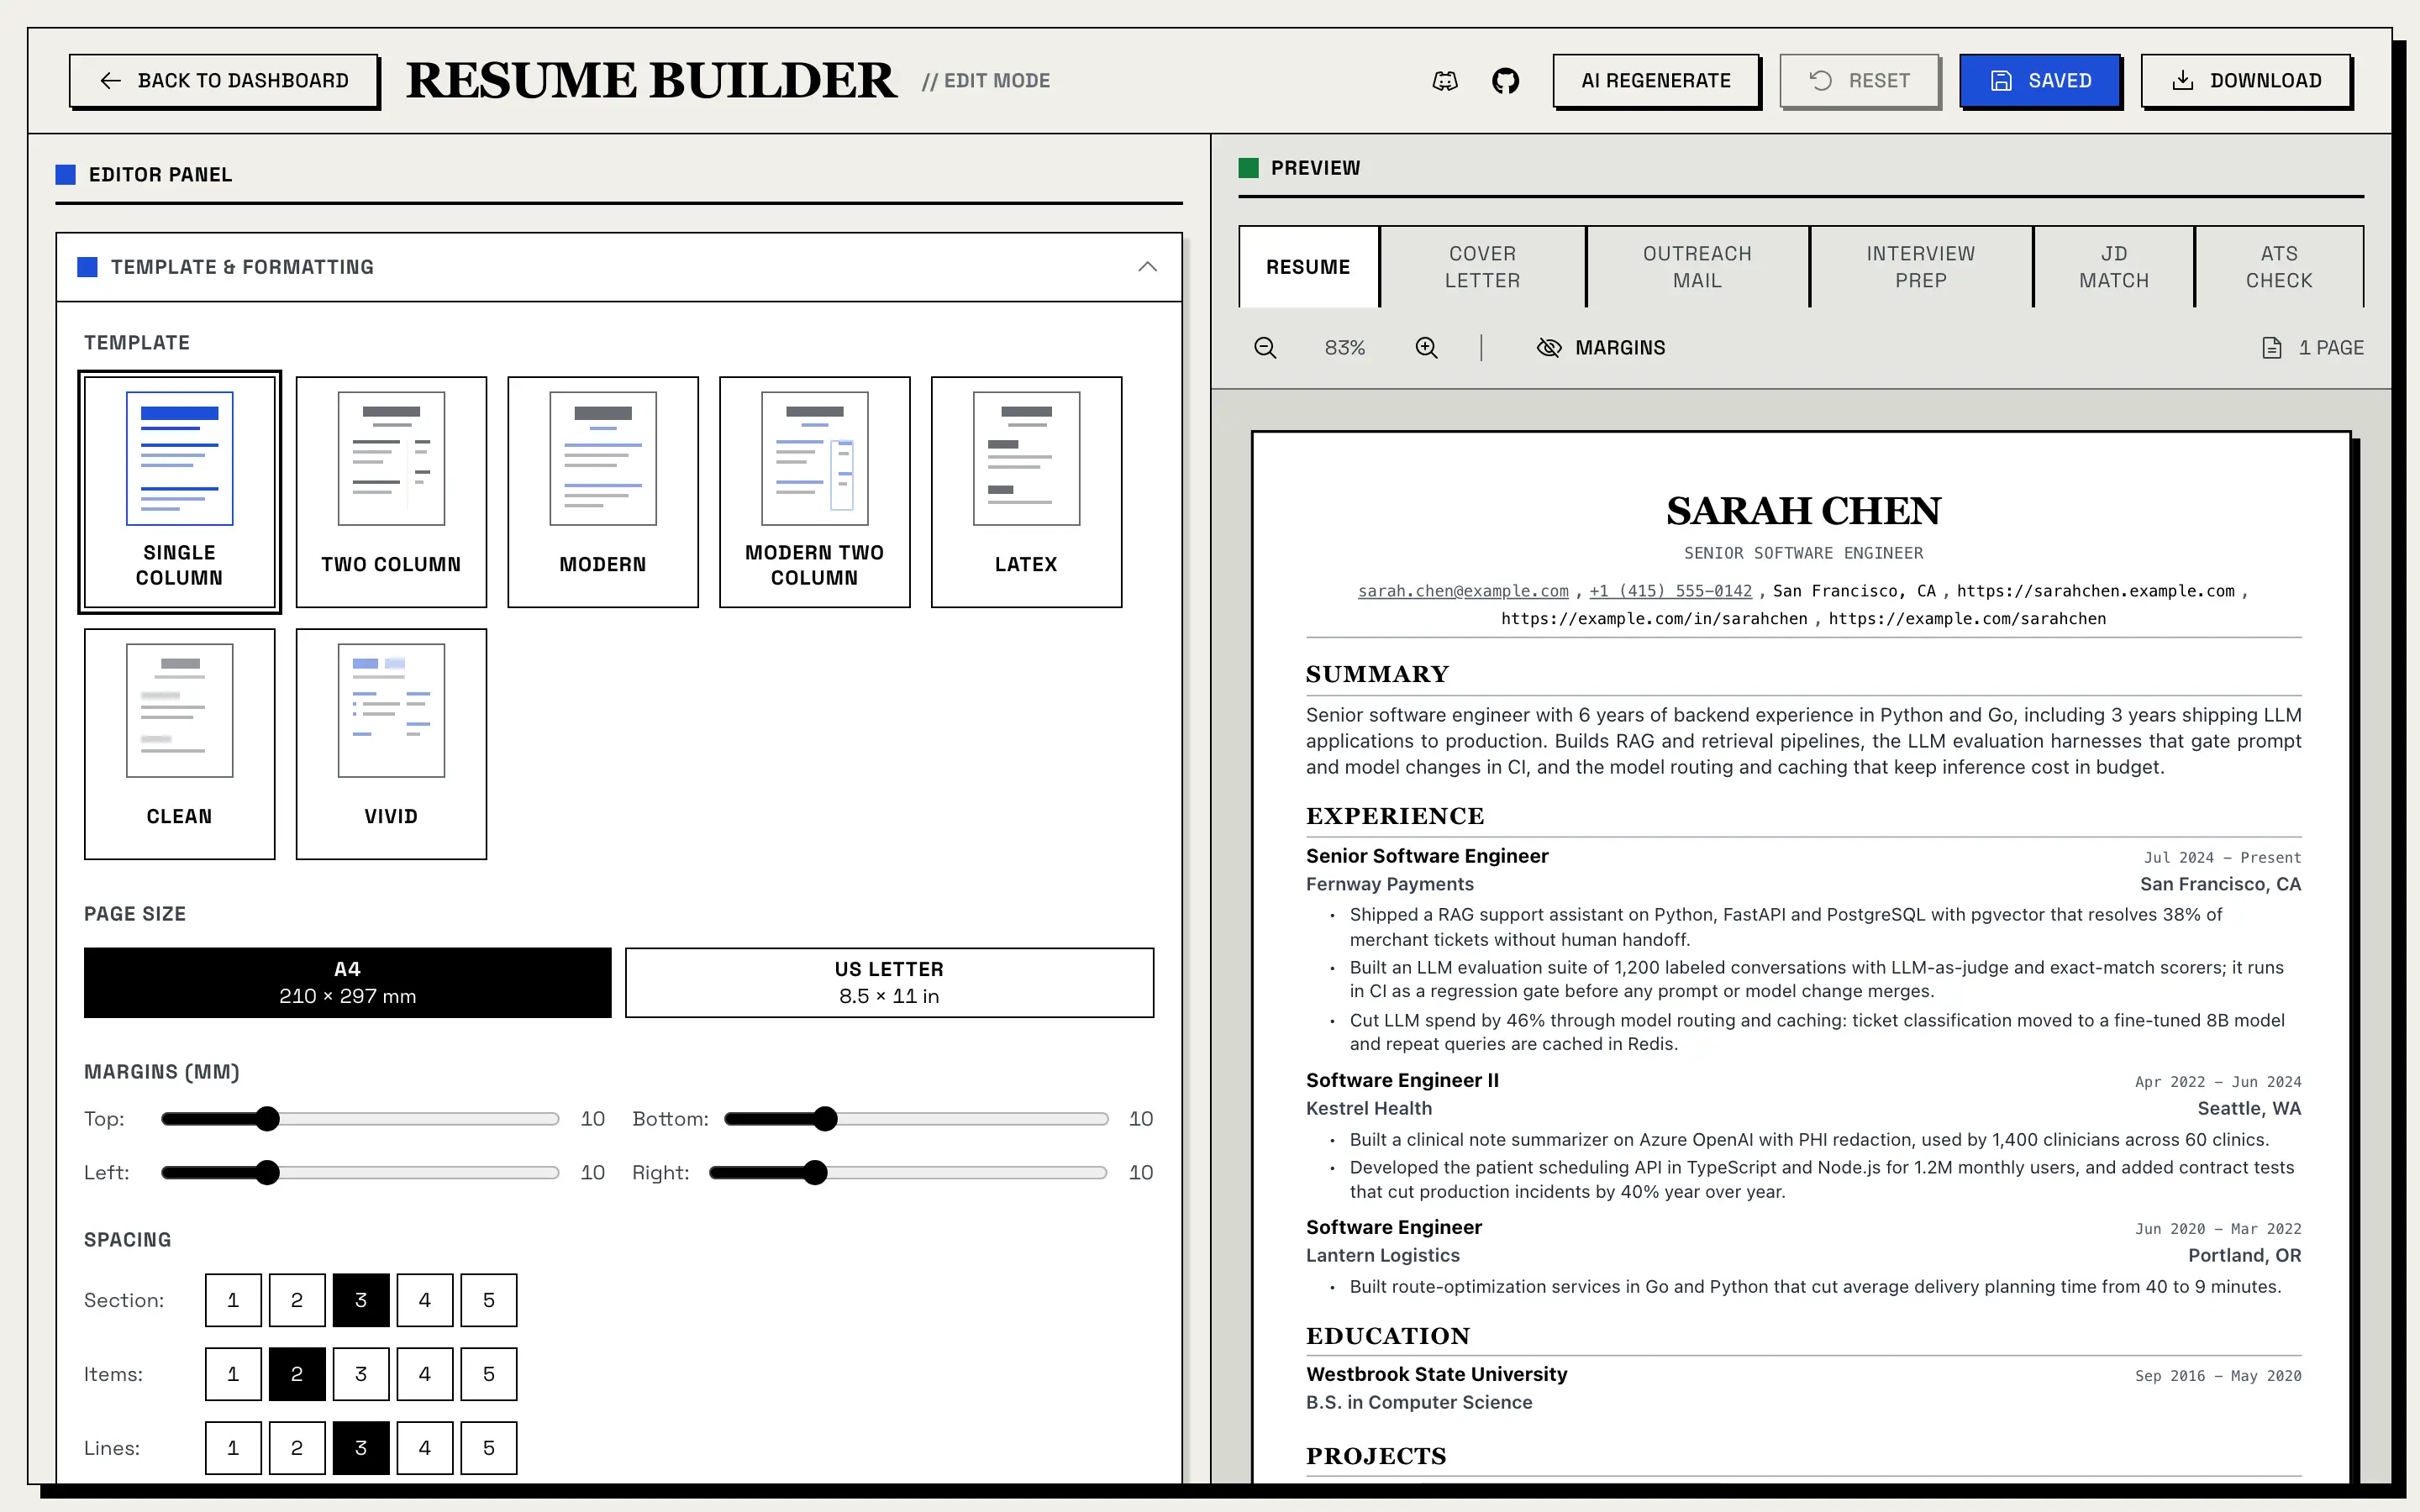
每份简历,无论是主简历还是定制简历,都在简历生成器里打开:左侧是编辑器,右侧是分页的实时预览,上方有简历、求职信、联系邮件、面试准备、ATS 检查标签页,定制简历还有「JD 匹配」标签页。
7
套模板,单栏和双栏
A4 / Letter
两种纸张尺寸,打印效果与预览一致
5–25 mm
每边页边距,默认 10 mm
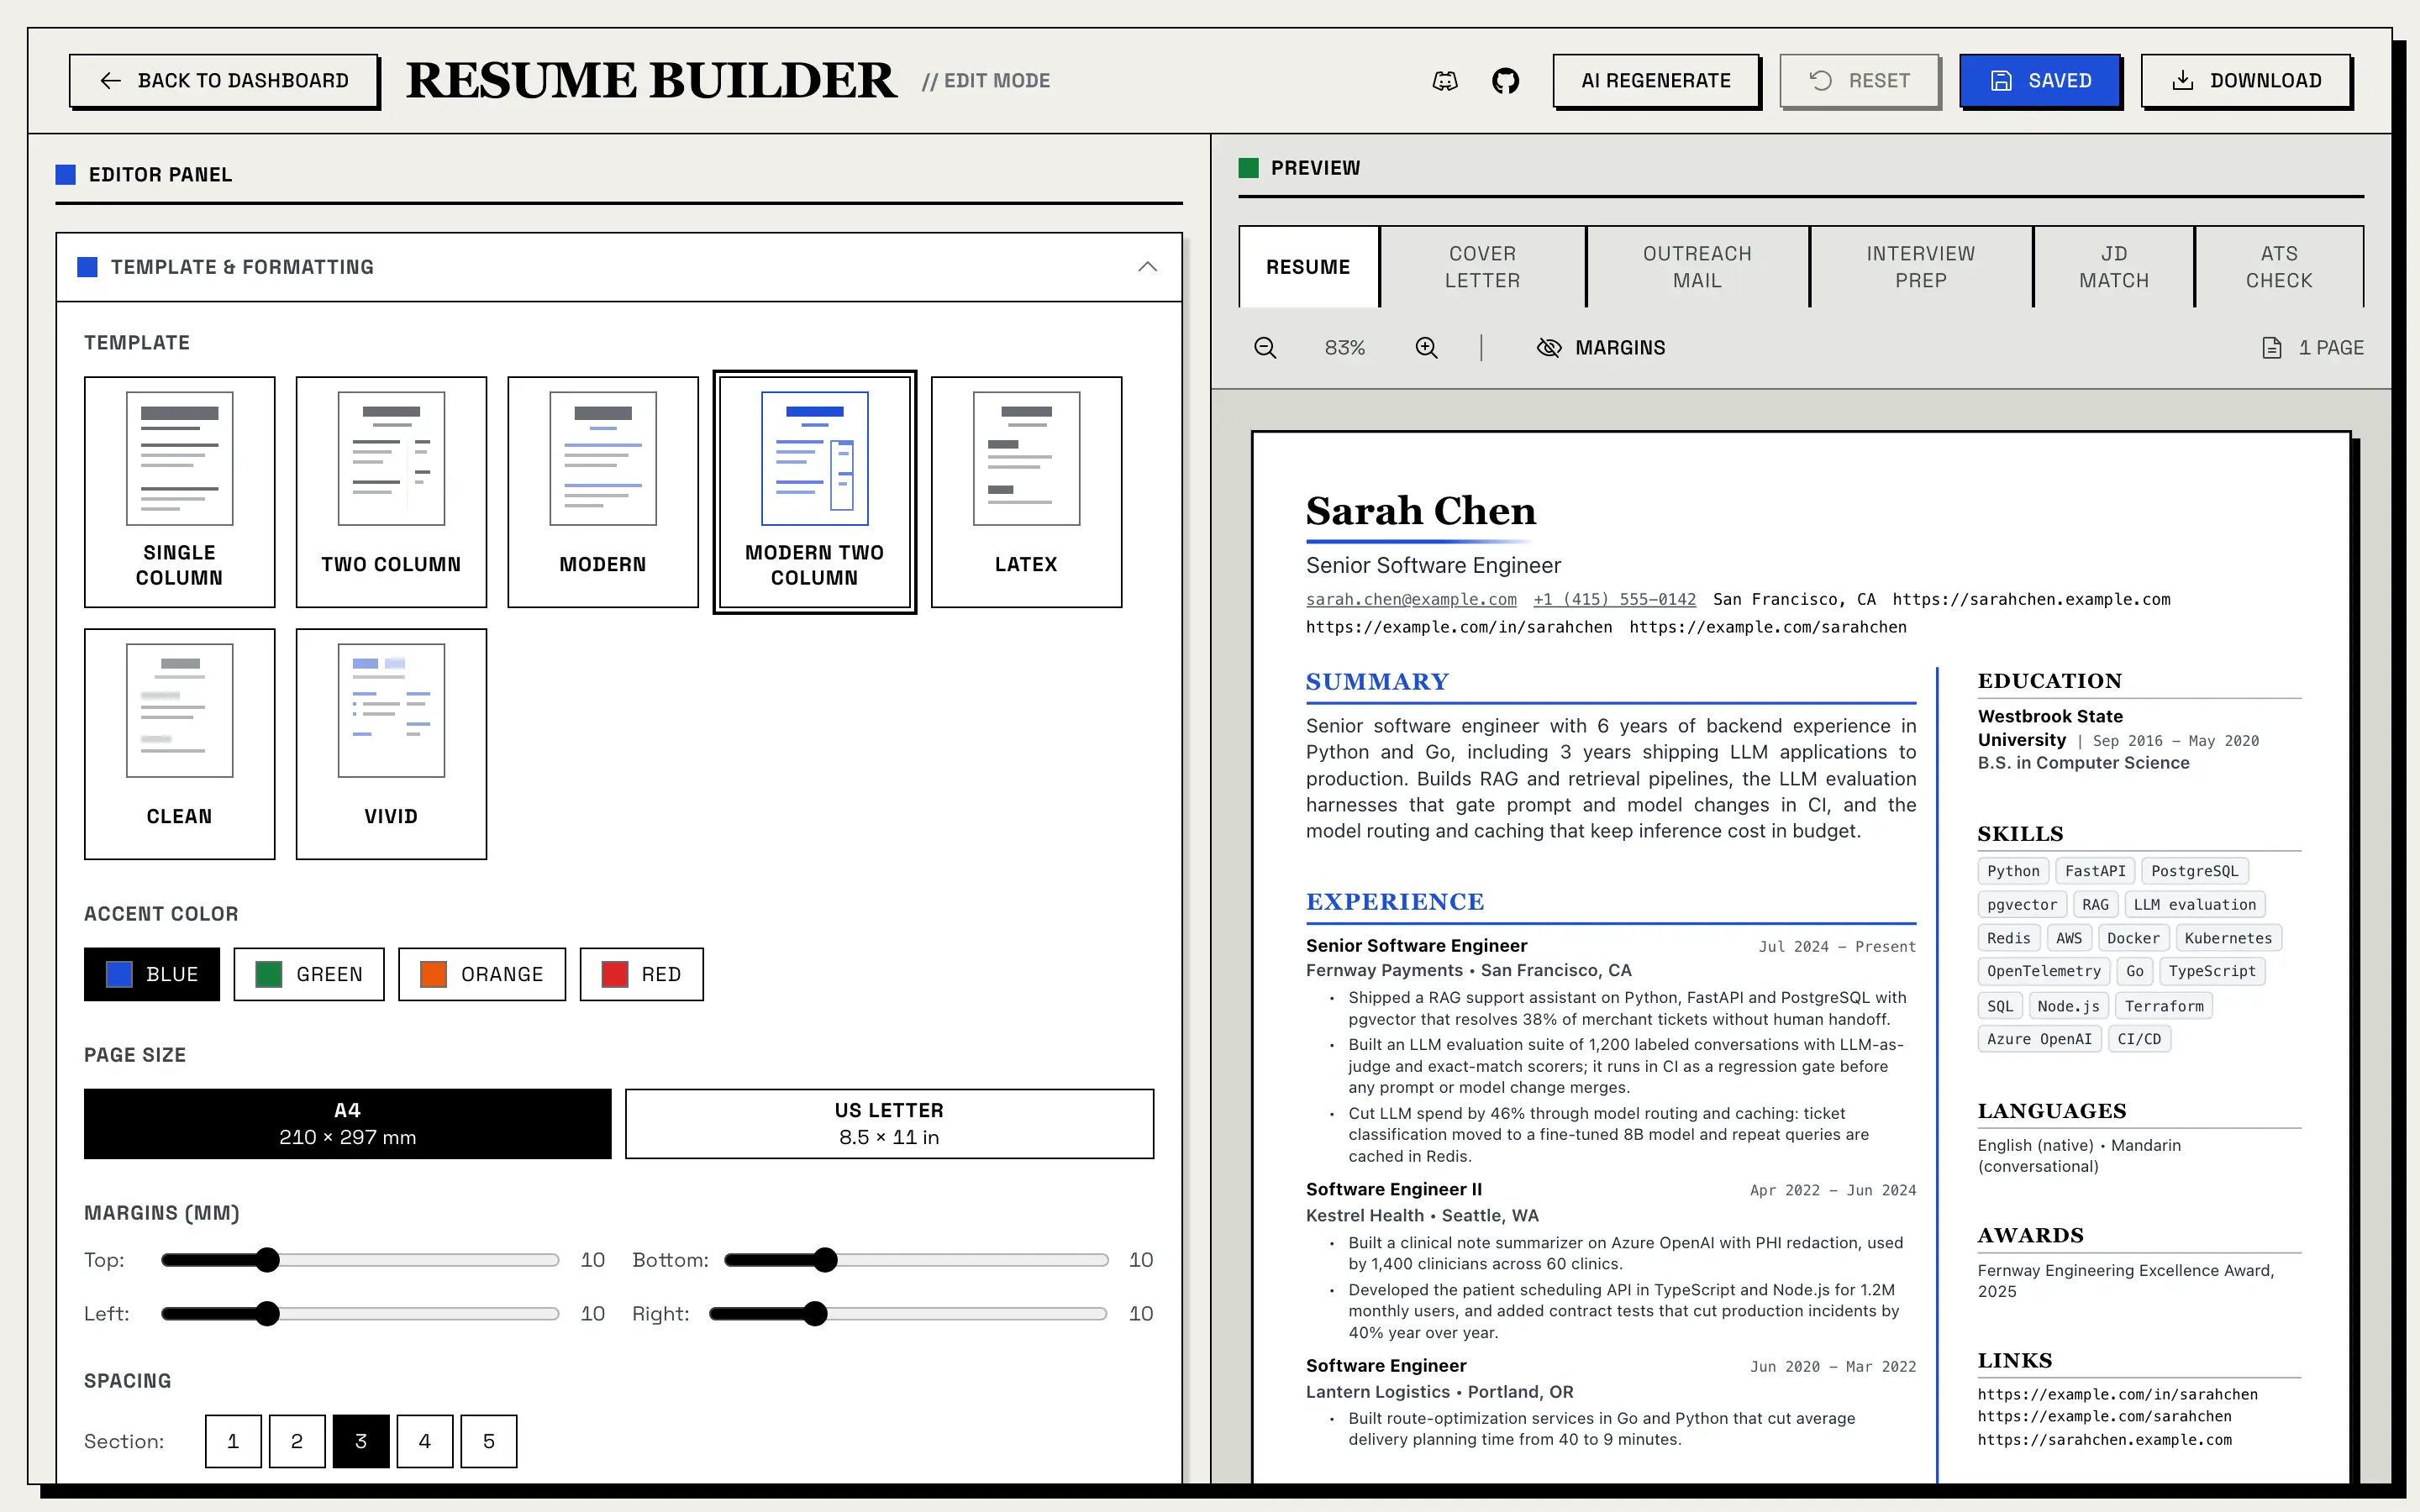
单栏
1 栏
双栏
2 栏
现代
1 栏,带强调色
现代双栏
2 栏,带强调色
LaTeX
1 栏
简洁
1 栏
鲜明
2 栏,带强调色
双栏模板在阅读顺序上把主要内容放在前面,因此文本提取工具会先读到你的工作经历,再读侧栏。
在定制简历上,「JD 匹配」标签页把职位描述和你的简历并排显示,并用黄色高亮你的简历中已经包含的每个职位描述关键词。
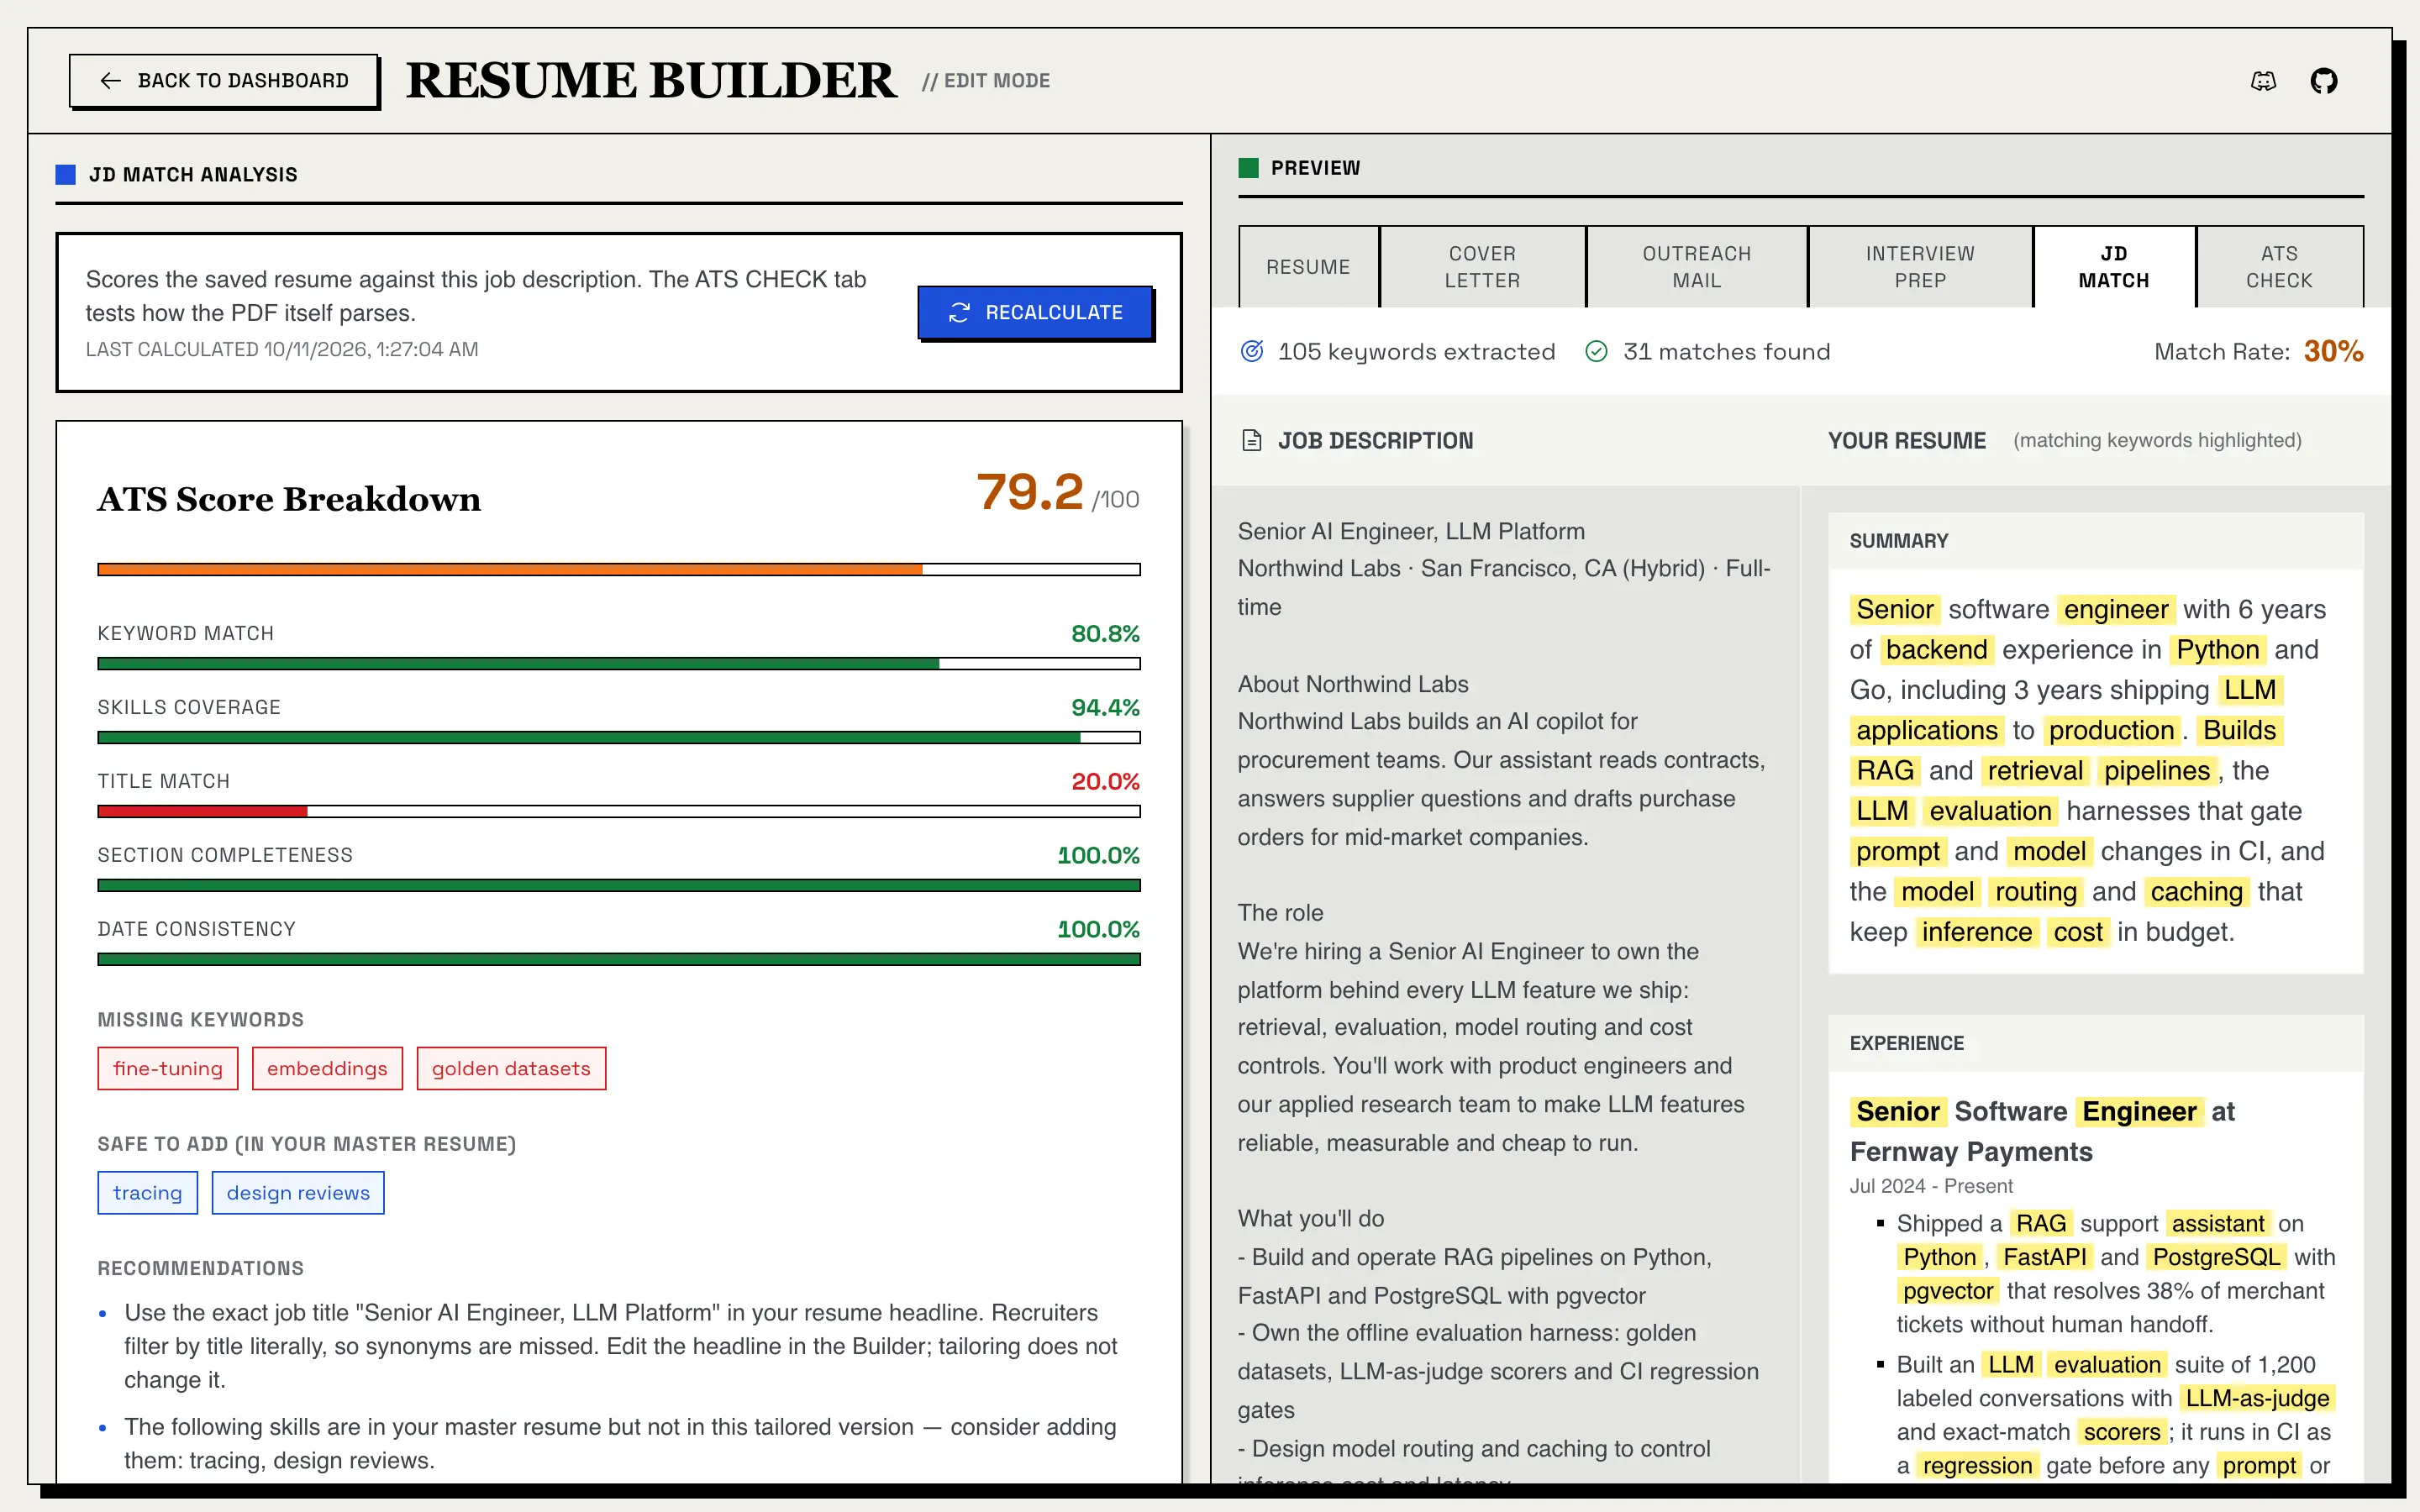
匹配率就是简单的算术,不涉及 AI:
取职位描述中的词,去掉常见英文词和招聘启事里的套话(比如「team」、「role」和「experience」),保留三个字母及以上的词。
对你的简历做同样的处理。
匹配率 = 简历中出现的职位描述关键词数 ÷ 职位描述关键词总数。
职位描述
We are hiring a backend engineer to build Python services on Kubernetes. You will run Postgres, Redis and Kafka and cut latency with the team.
你的简历
Built Python services on Kubernetes; cut latency by 40%.
10 个关键词 · 4 个匹配
匹配率: 4 ÷ 10 = 40%
50% 及以上显示绿色,30% 起显示琥珀色,低于 30% 显示红色。因为它会统计招聘启事中每个有意义的词,包括公司背景介绍,一份很强的简历也常常落在 30% 到 50% 之间。用它来找出缺失的技能和术语,不要把它当作及格线。目前它只统计纯 a–z 字母组成的词,所以带重音符号的词以及中文、日文和韩文文本都不会被计入。
两者都不模拟雇主的申请人跟踪系统。它们测试的是你能掌控的东西:软件能否读取你的 PDF,以及简历对职位的覆盖程度。
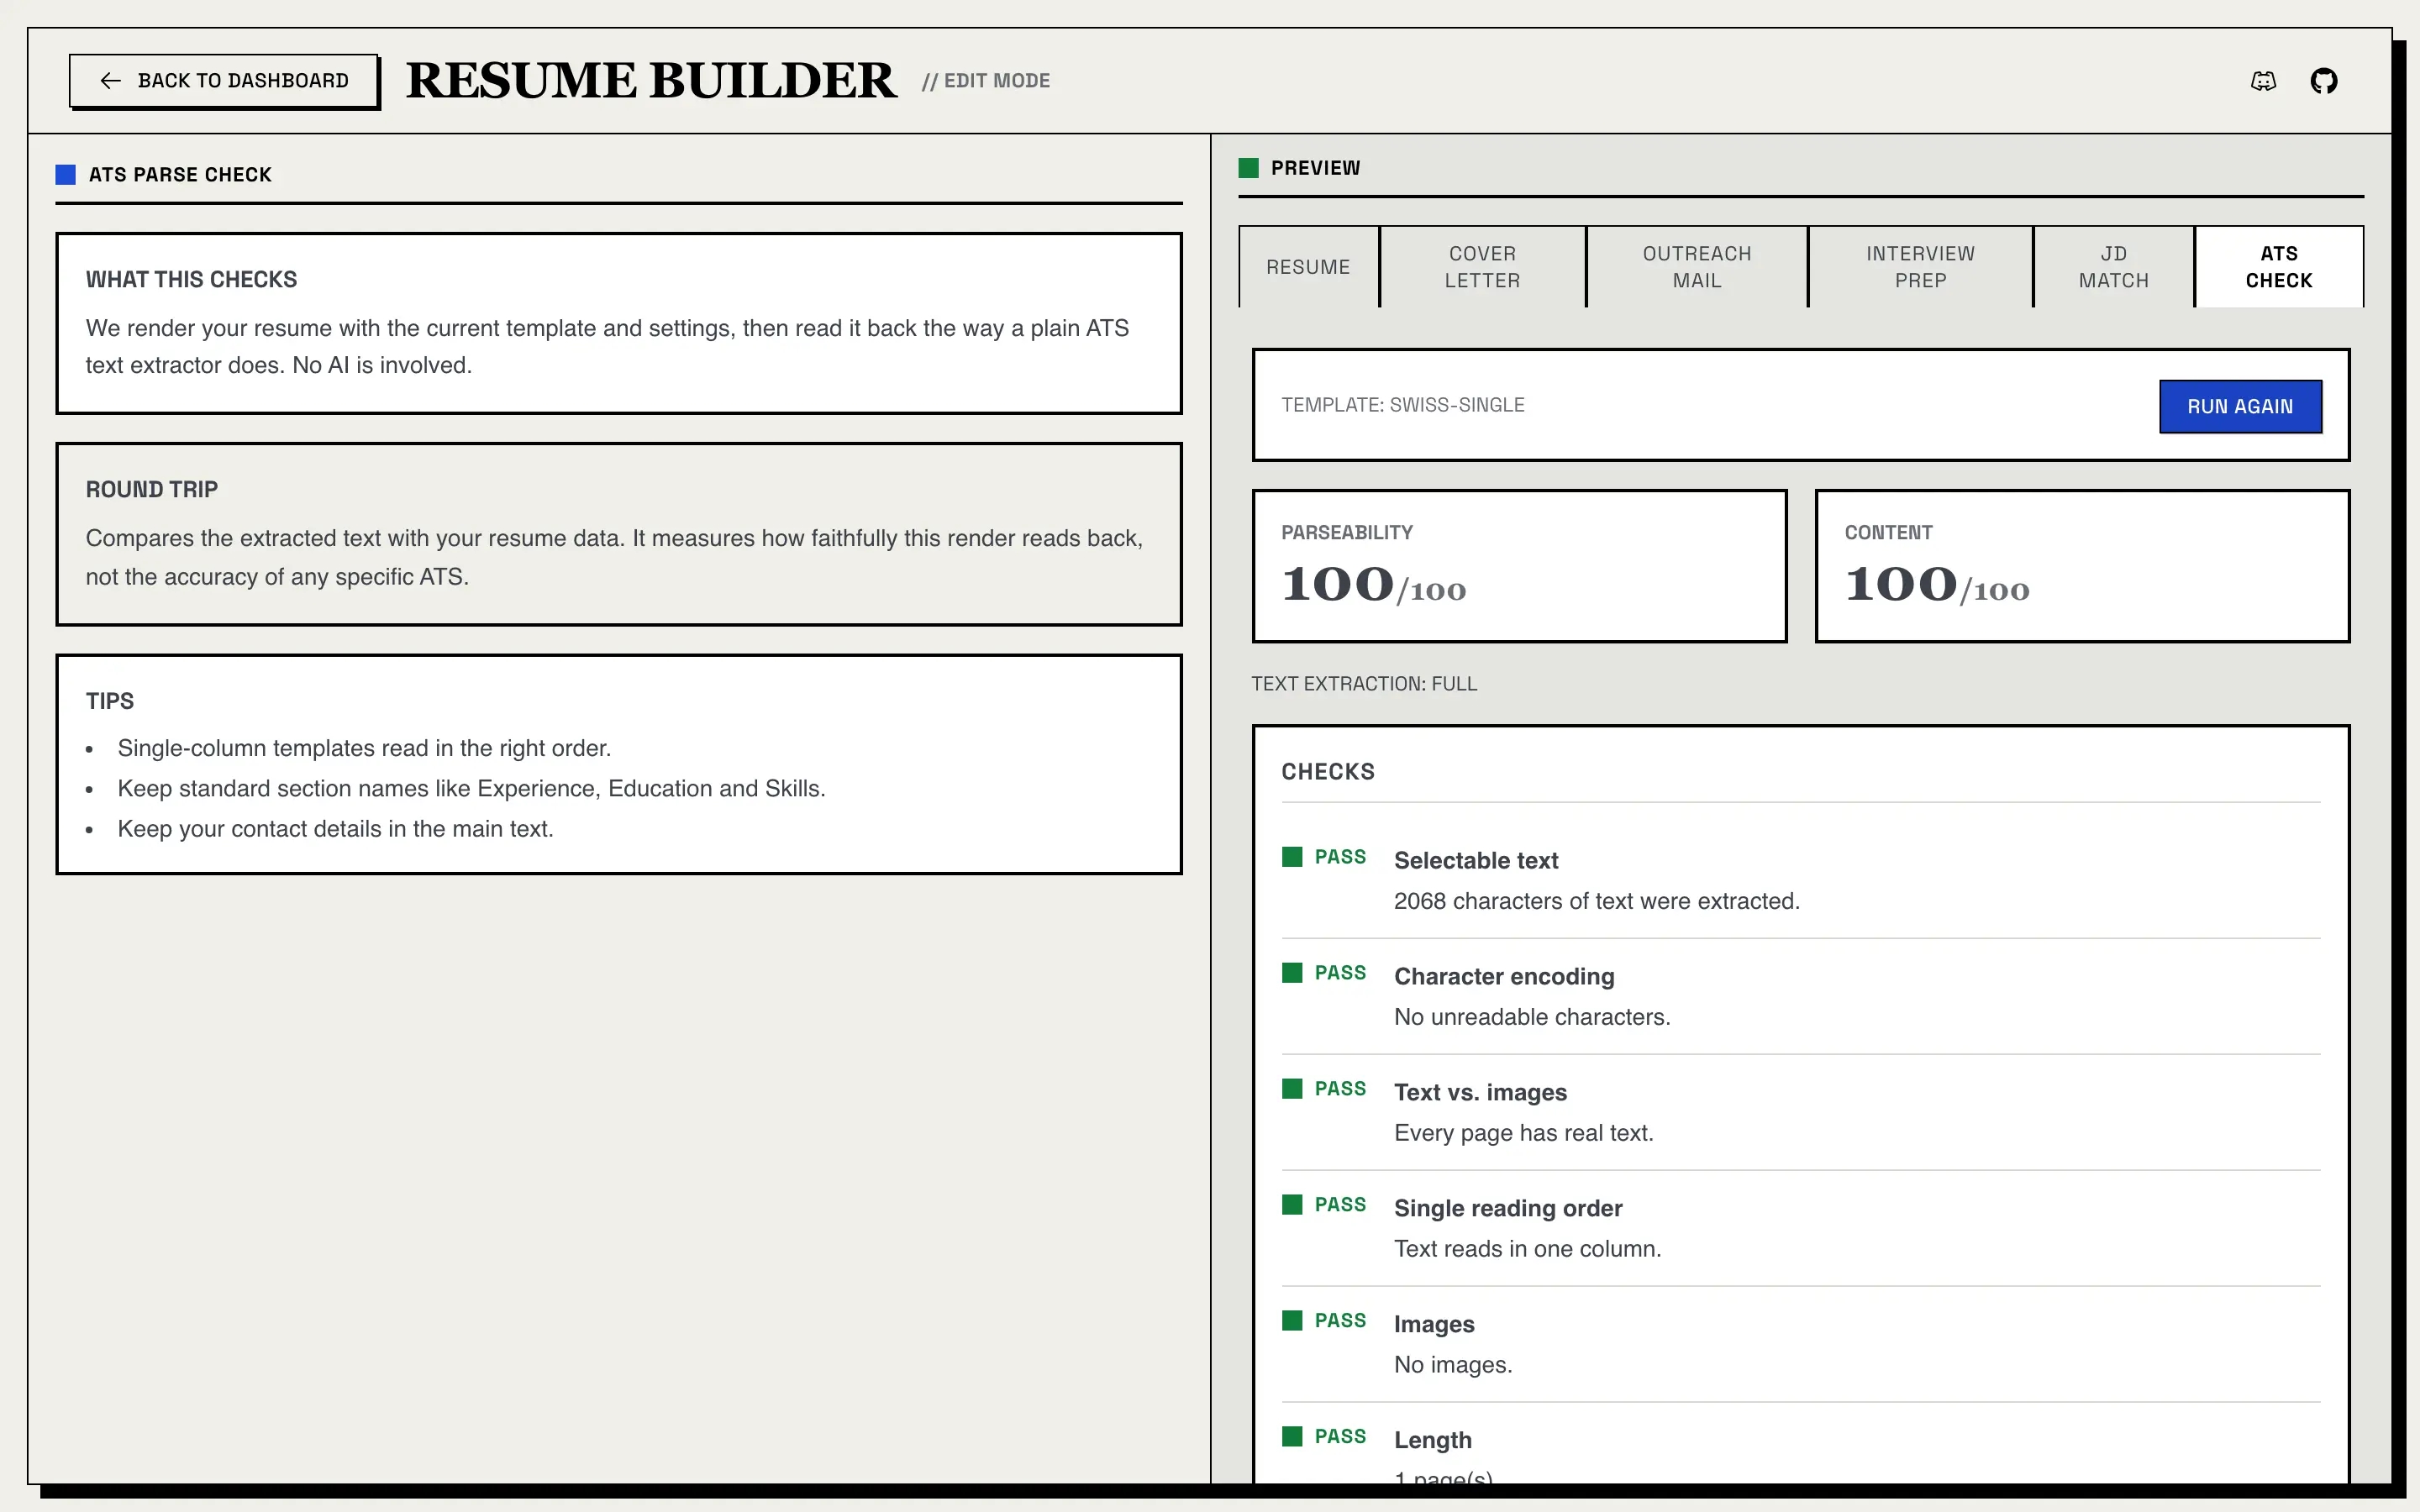
「ATS 检查」标签页用当前模板渲染你最近一次保存的简历,也就是「下载」得到的那份 PDF,再像普通 ATS 文本提取器那样把它读回来。整个过程不涉及 AI。它从可解析性和内容两方面打分,各自满分 100,并列出每一项检查:可选中文本、字符编码、文本与图片、单一阅读顺序、页眉和页脚、图片、篇幅、联系方式、板块标题和日期。往返对比会把提取出的文本和你的简历数据做比较。它适用于任何已保存的简历。
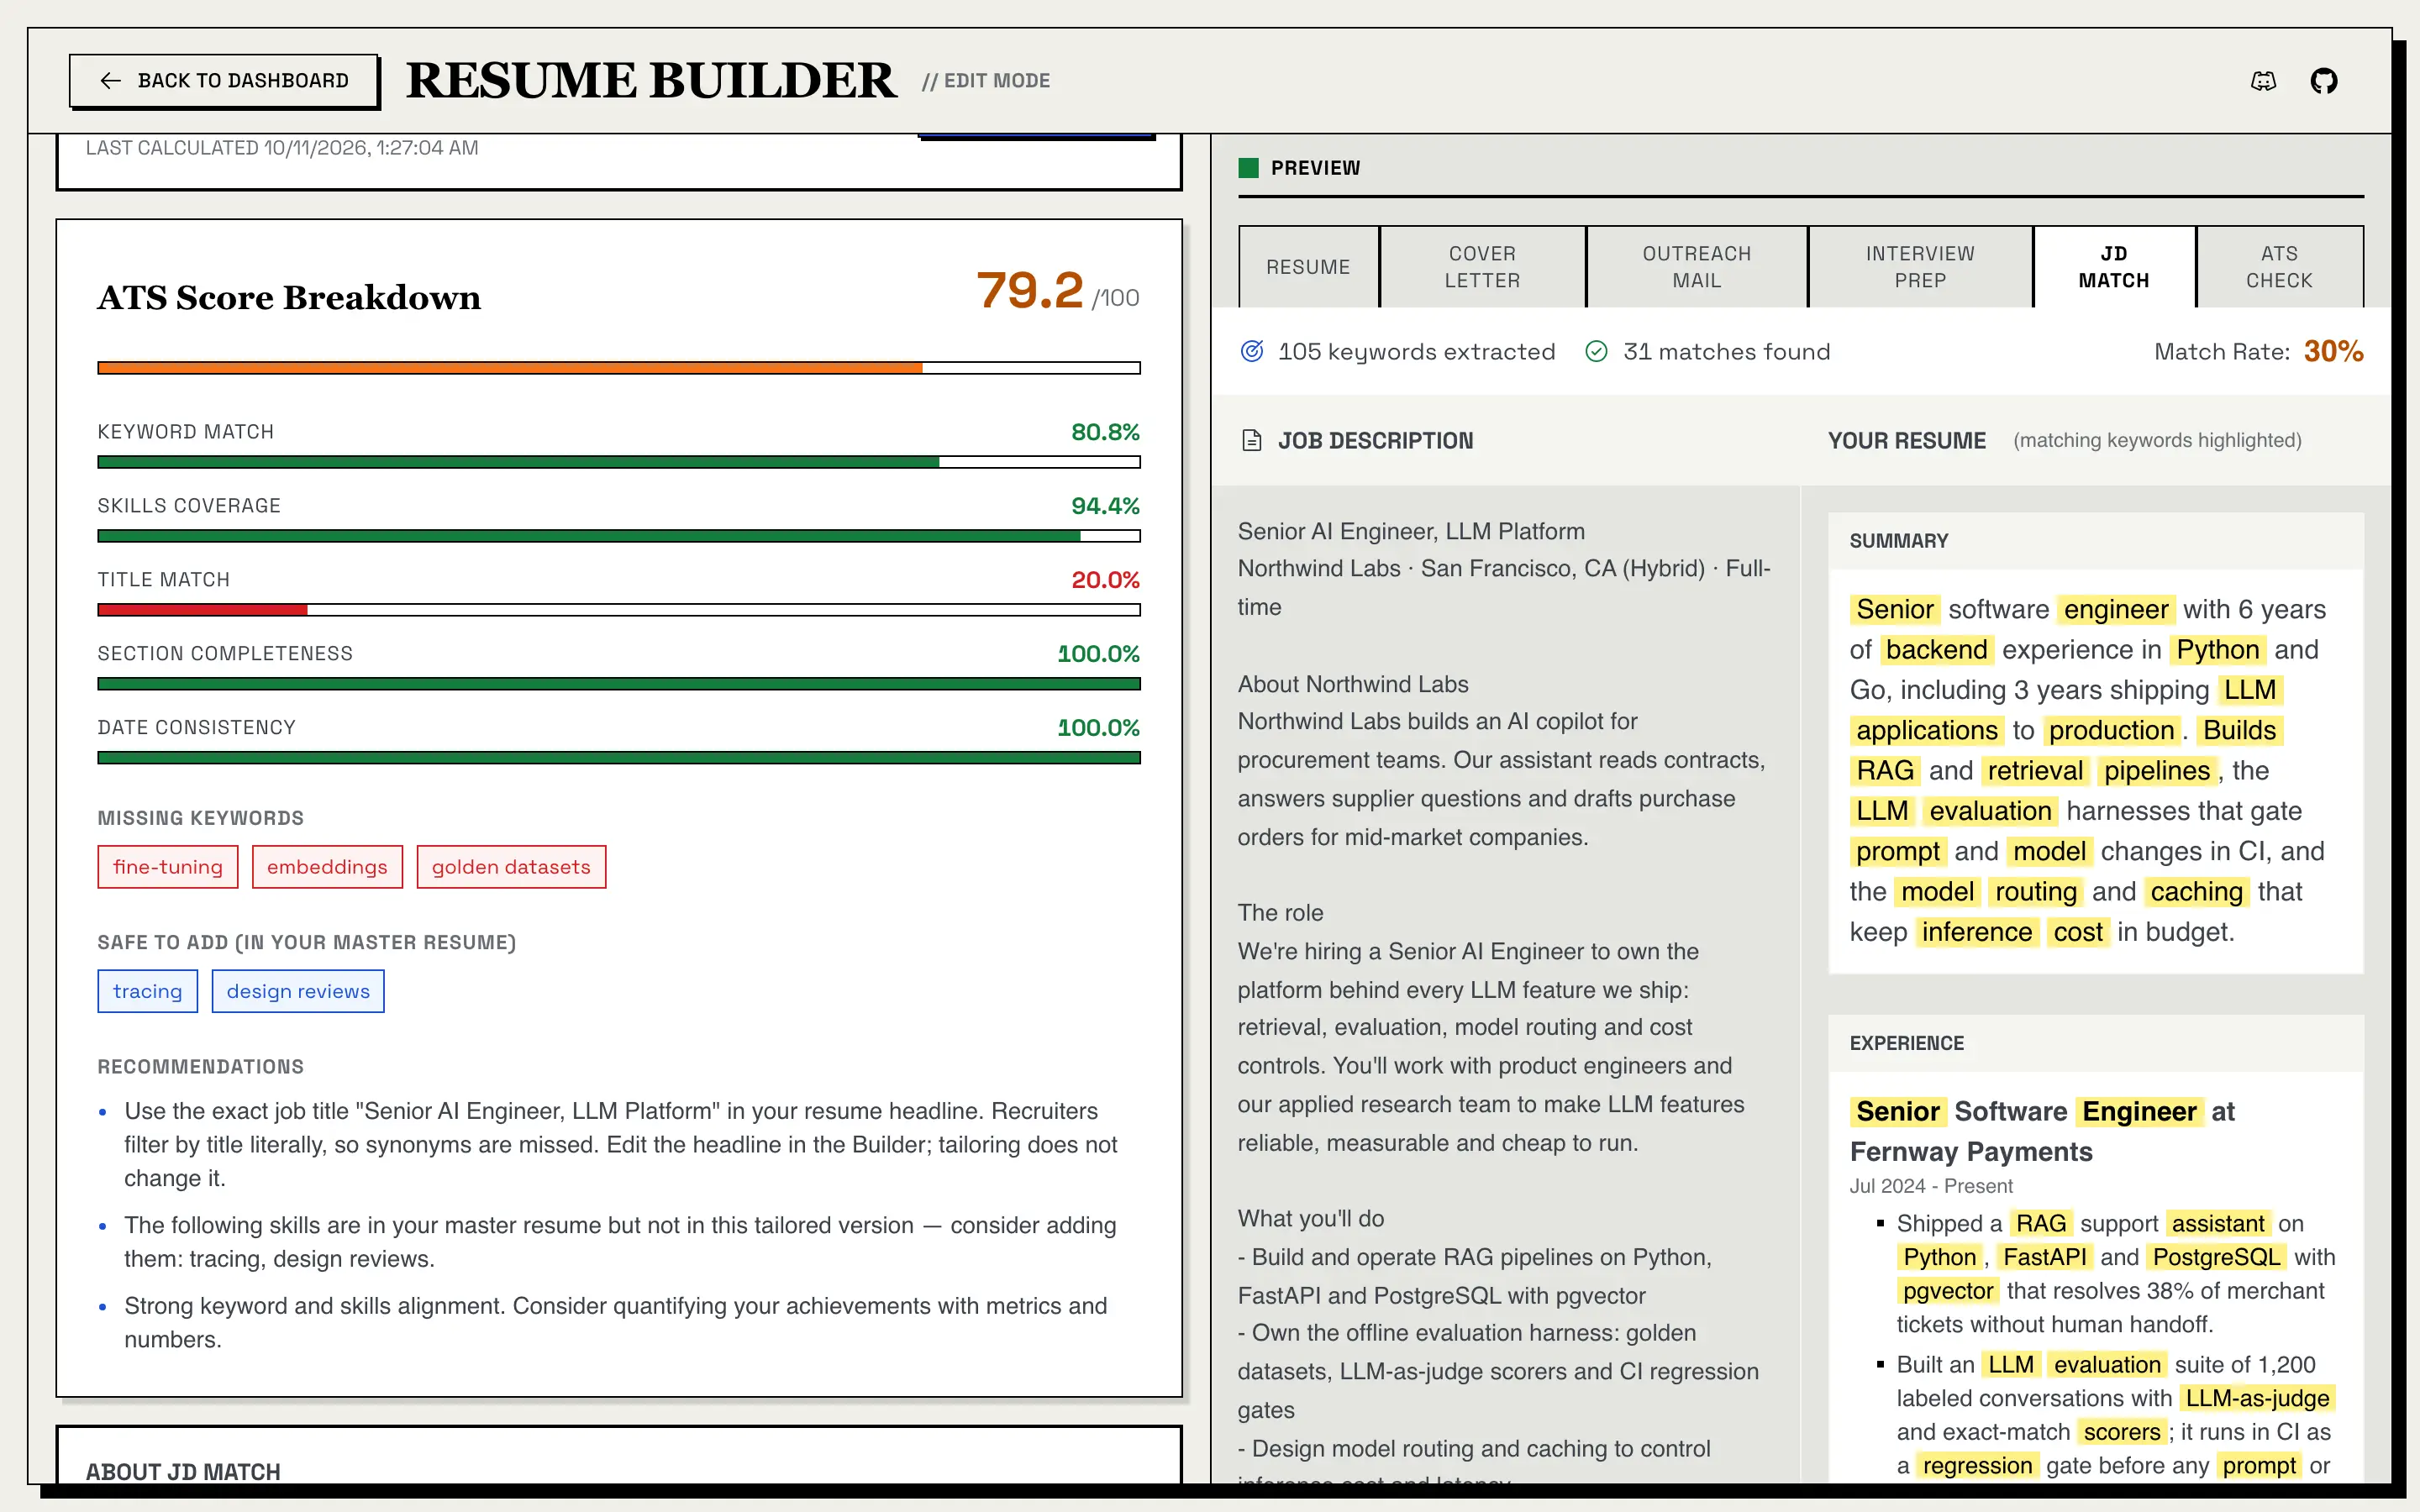
在定制简历上,ATS Score Breakdown(ATS 评分明细)会对照职位为简历打分:关键词匹配占 40%,技能覆盖占 20%,职位名称匹配占 15%,板块完整度占 15%,日期格式一致性占 10%。它列出缺失关键词、主简历里已有且可以安全添加的关键词,以及建议。评分随简历一起保存;编辑之后,先保存,再点击「重新计算」。评分完全由代码计算,不调用 AI。
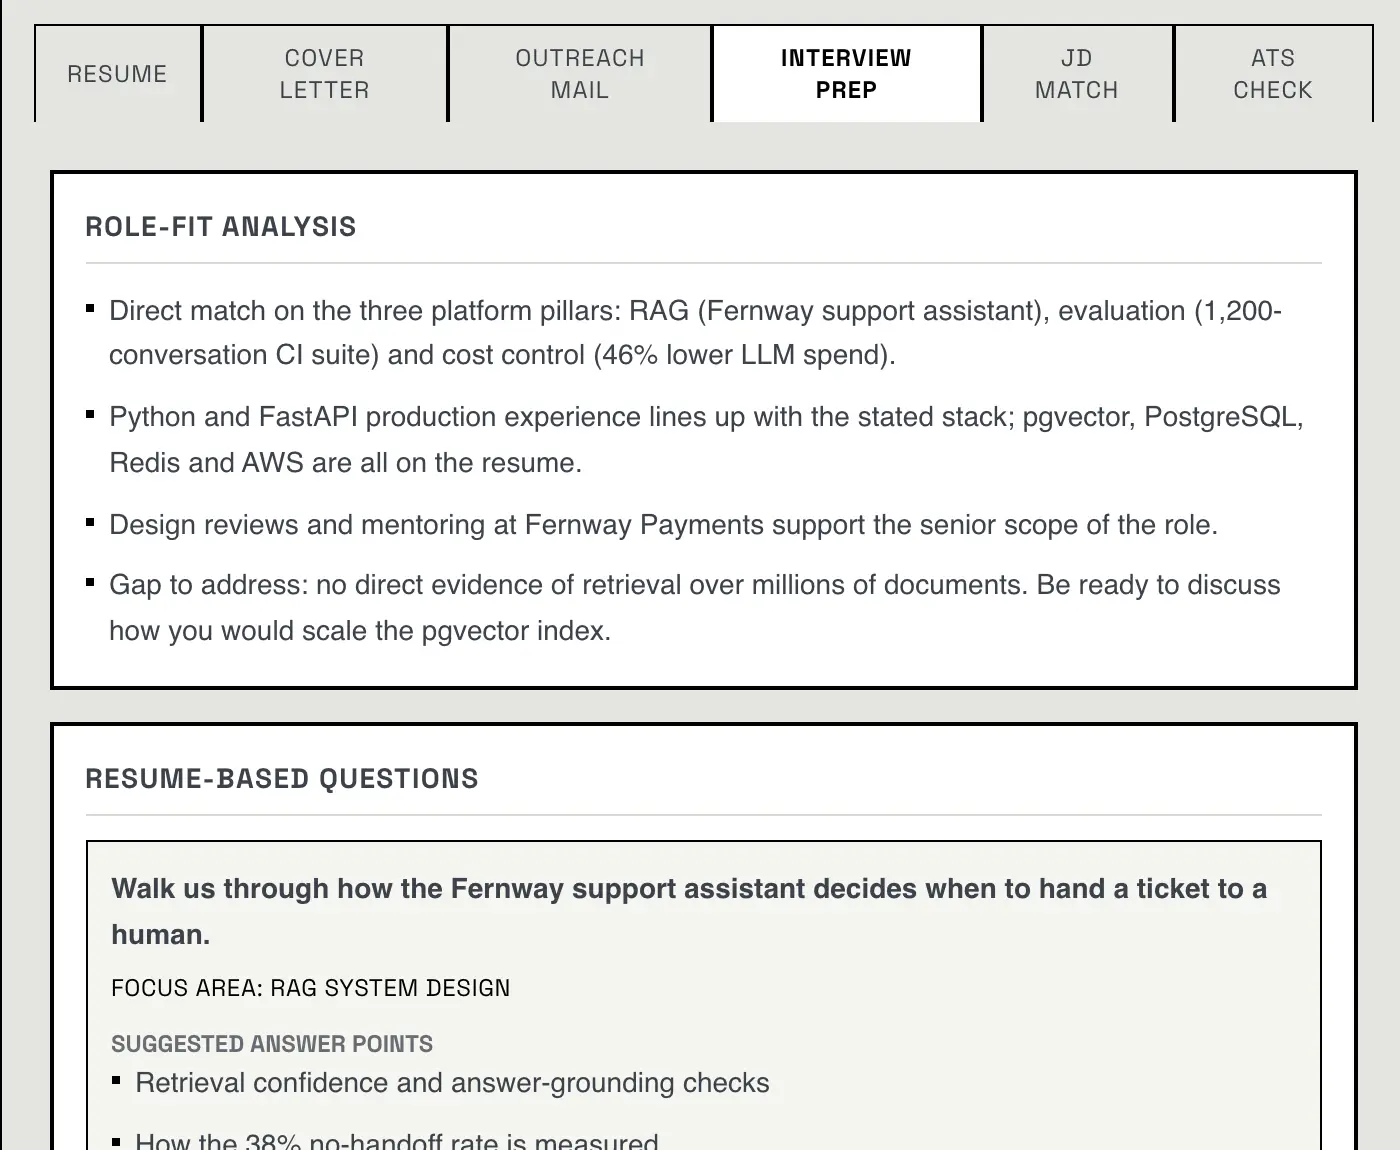
每一项都根据你的简历、针对同一个职位撰写。你可以在简历生成器的标签页里按需生成,也可以在设置里打开开关,让它们在你每次确认定制简历时自动生成。
100–150
词的求职信
70–100
词的联络消息
5
部分面试准备,从岗位匹配到谈话要点
一封 100 到 150 词的简短信件,根据你的简历针对具体职位撰写。提示词要求模型不编造简历里没有的任何内容。在打印版式旁边编辑它,然后保存、重新生成,或下载为 PDF。
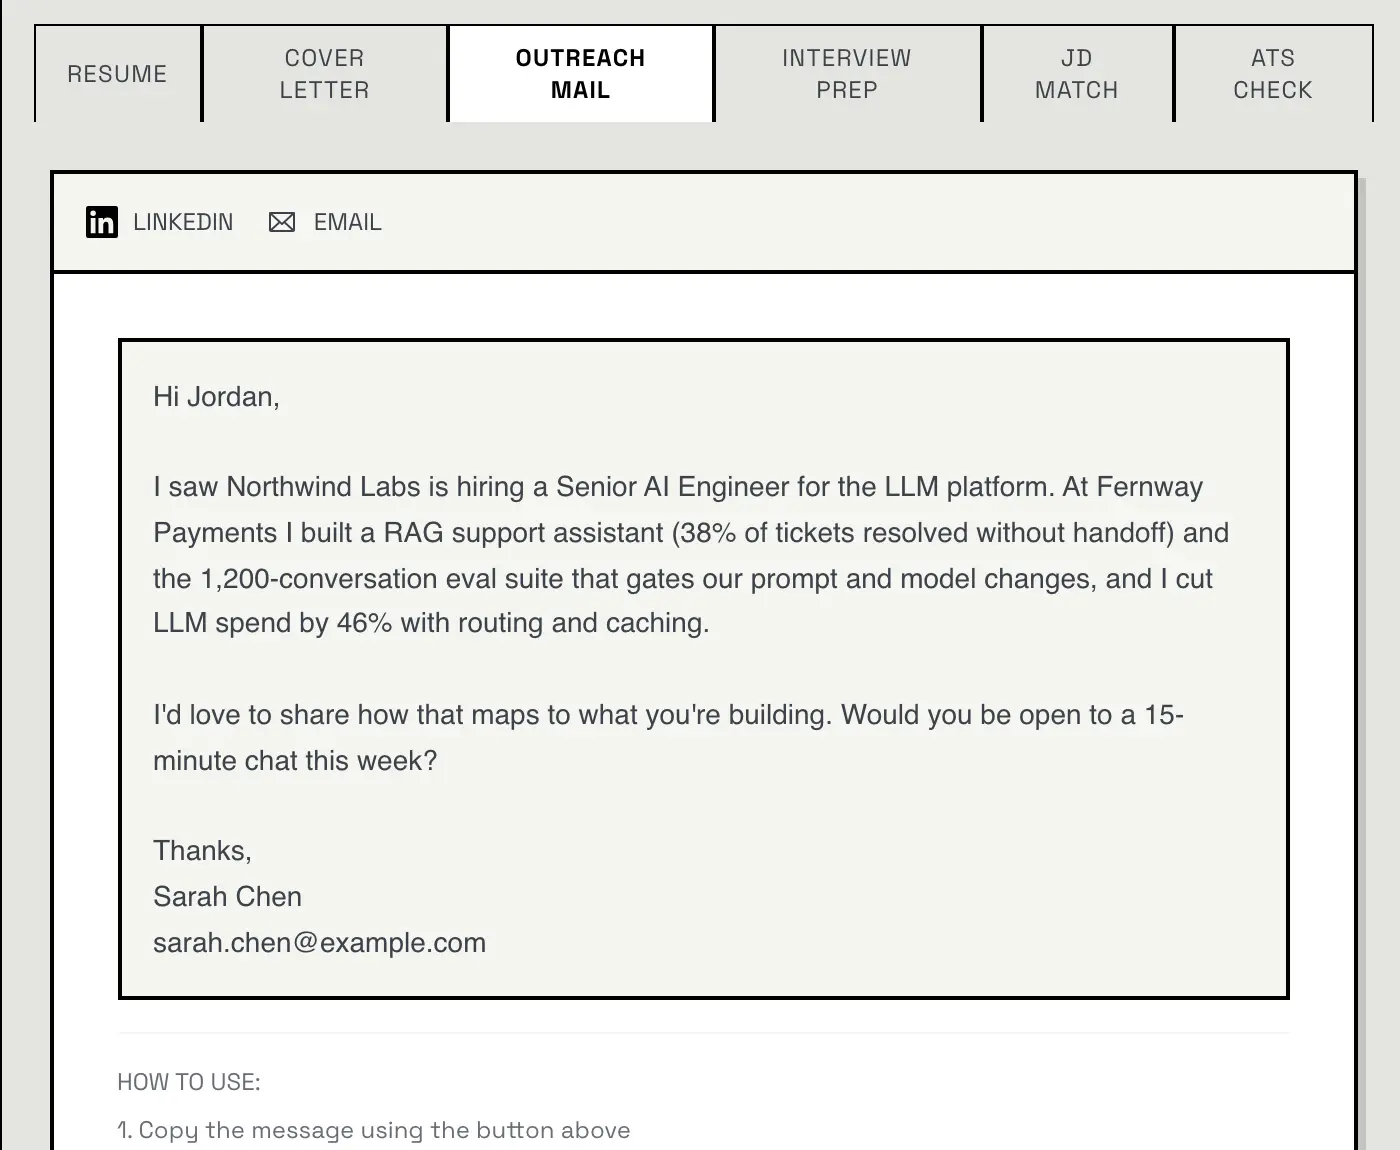
一封 70 到 100 词的冷邮件或 LinkedIn 消息,针对同一职位、根据你的简历撰写。你可以编辑、重新生成,并复制到剪贴板。和求职信一样,它的提示词也可以在设置里换成你自己的。
打开你的主简历,点击「增强简历」。AI 会找出内容单薄的工作经历和项目条目,并就这些条目问你最多六个问题。它根据你的回答为每个条目写出两到四条新要点,你审核之后再点击「添加到简历」。它只使用你提供的细节,不会编造指标。
在简历生成器里,选择要重写的工作经历、项目或技能,并写一条指令,比如「使用更有力的行动动词」或「突出领导力」。在应用任何改动之前,你会看到修改前后的预览。提示词禁止添加新的事实、指标、日期、公司、职位或成就。
申请追踪是一个用于求职的看板。你确认的每份定制简历都会自动生成一张卡片;对于还没定制简历的职位,你也可以手动添加卡片。
7
个阶段,从已保存到已录用或已拒绝
1
张卡片,每确认一份定制简历自动添加
0
个招聘网站接入:看板只是你自己的记录
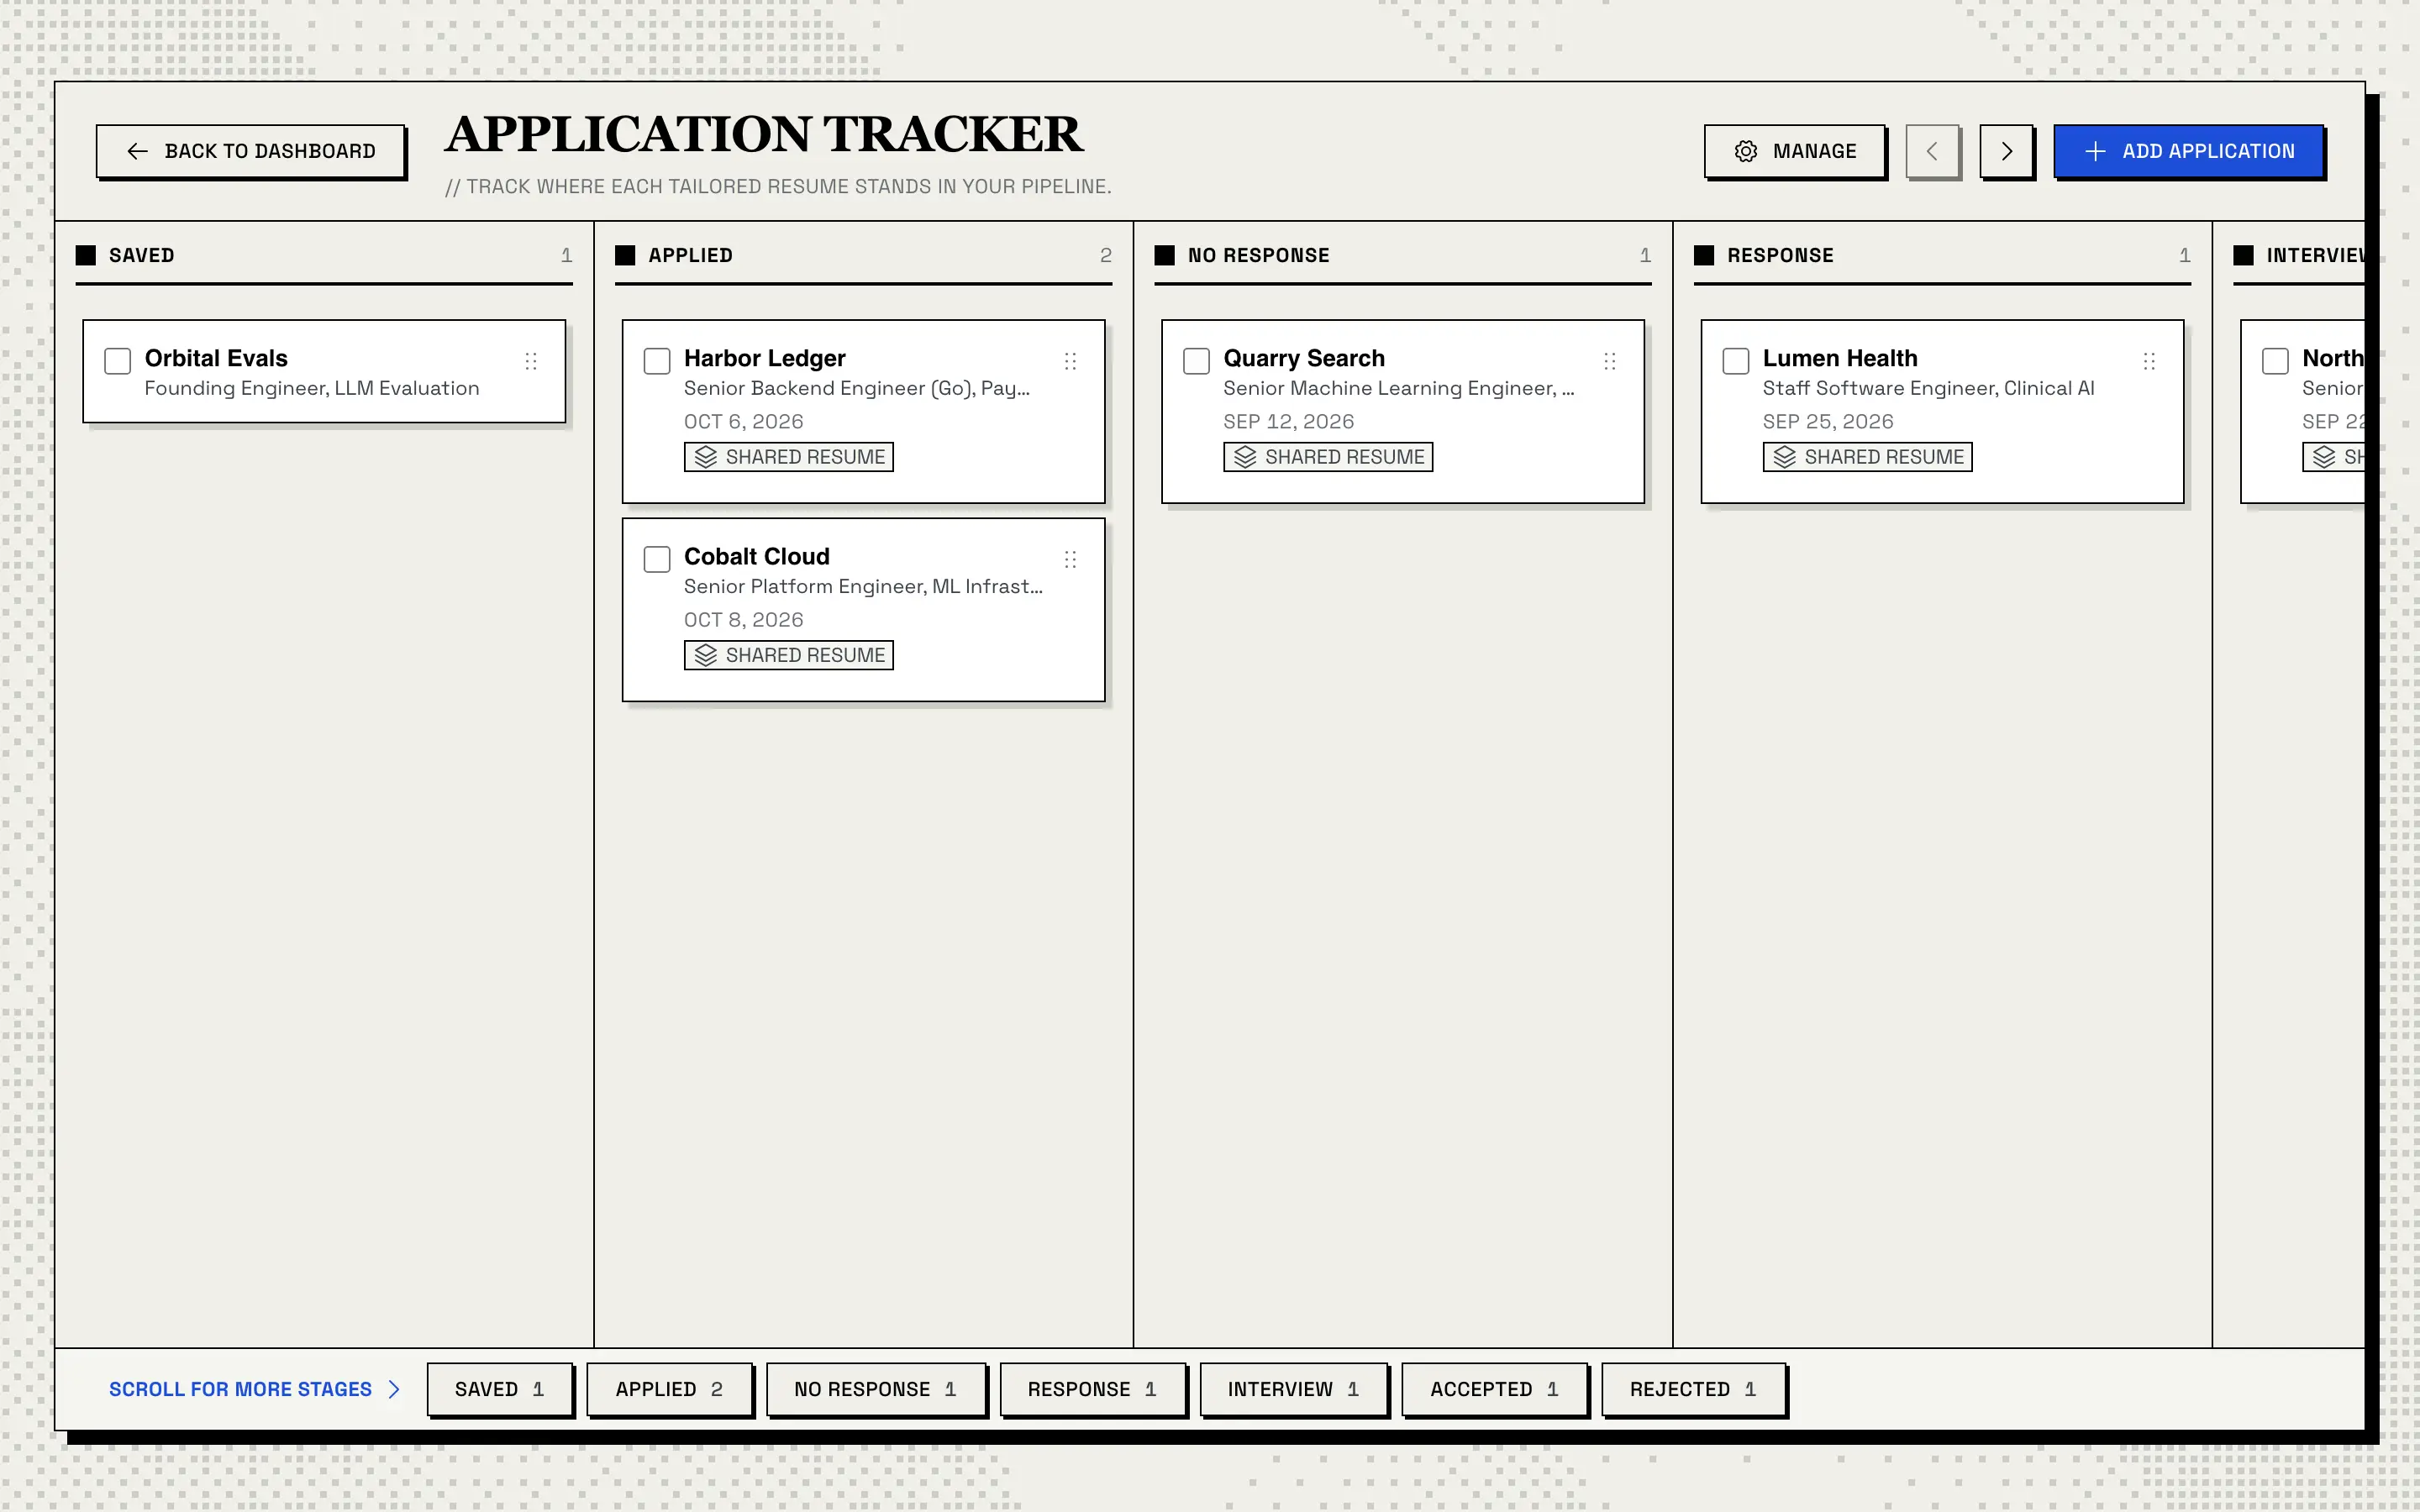
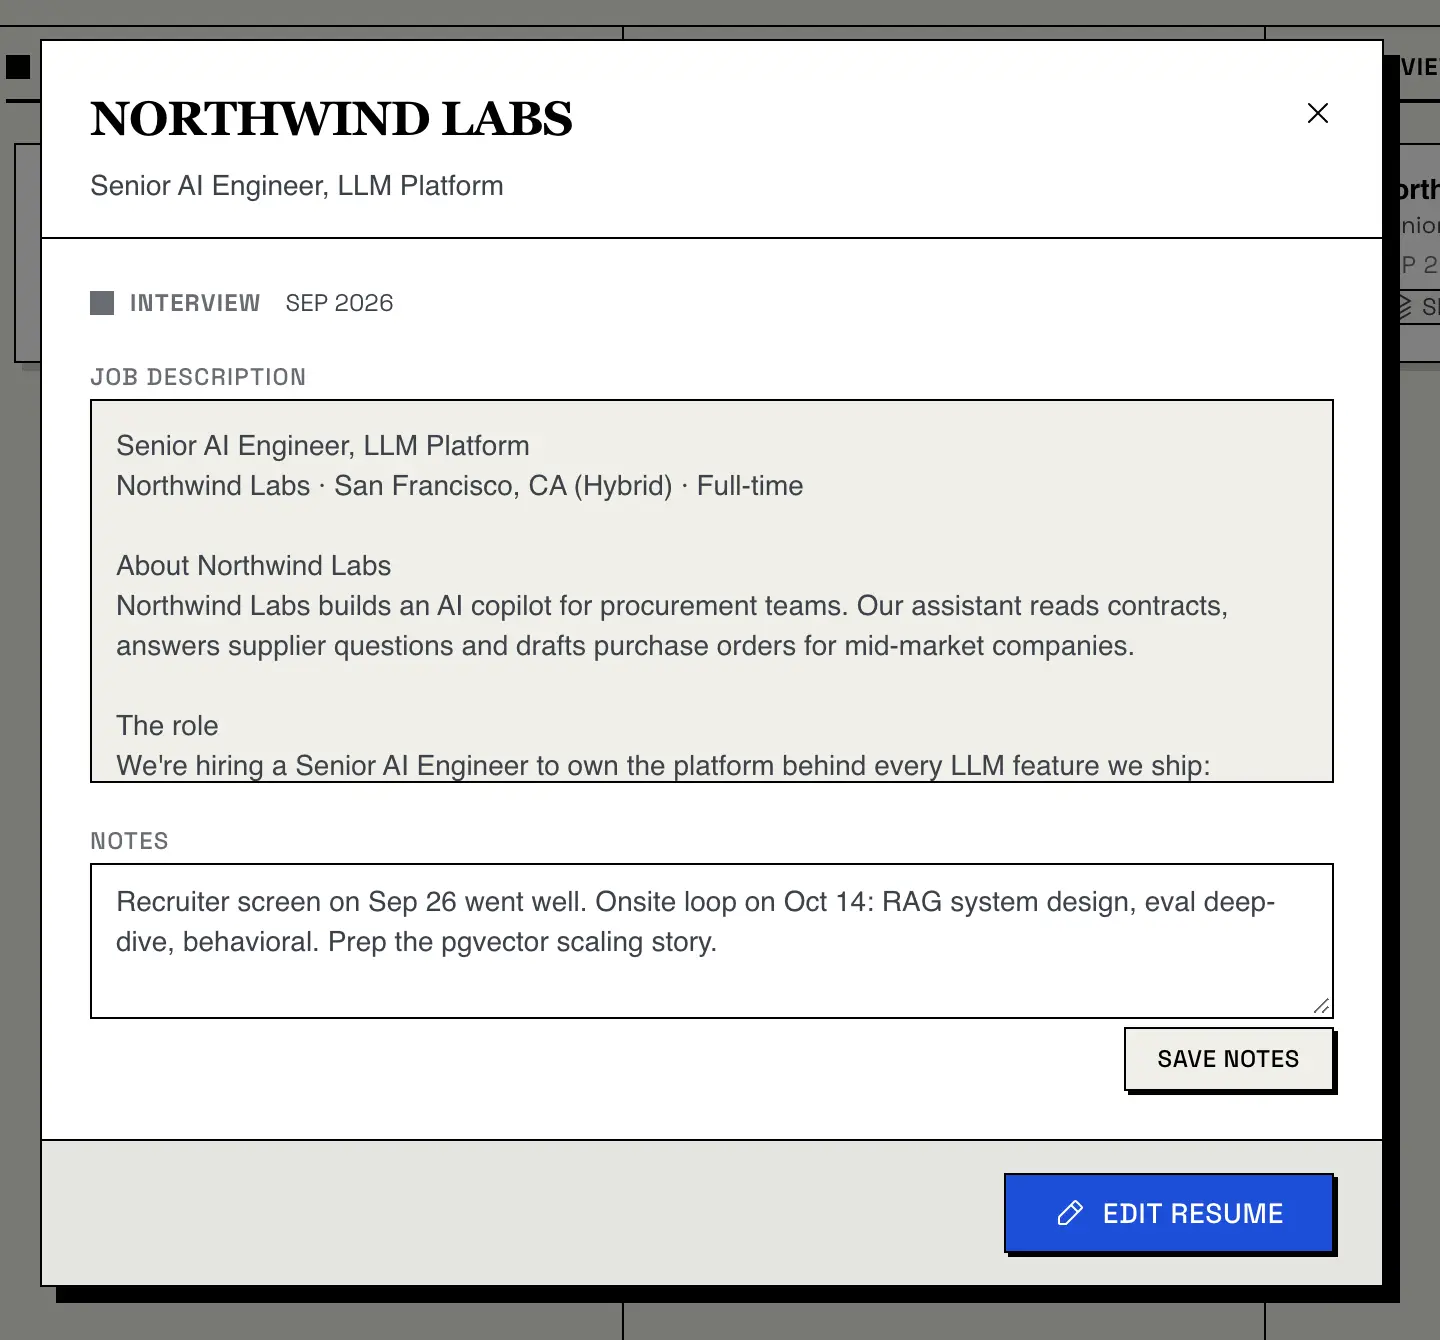
点击卡片可以阅读完整的职位描述、写备注,并打开你投递时用的那份简历:「编辑简历」会带你进入简历生成器。如果那份简历之后被删除了,卡片仍能打开,并会提示你。
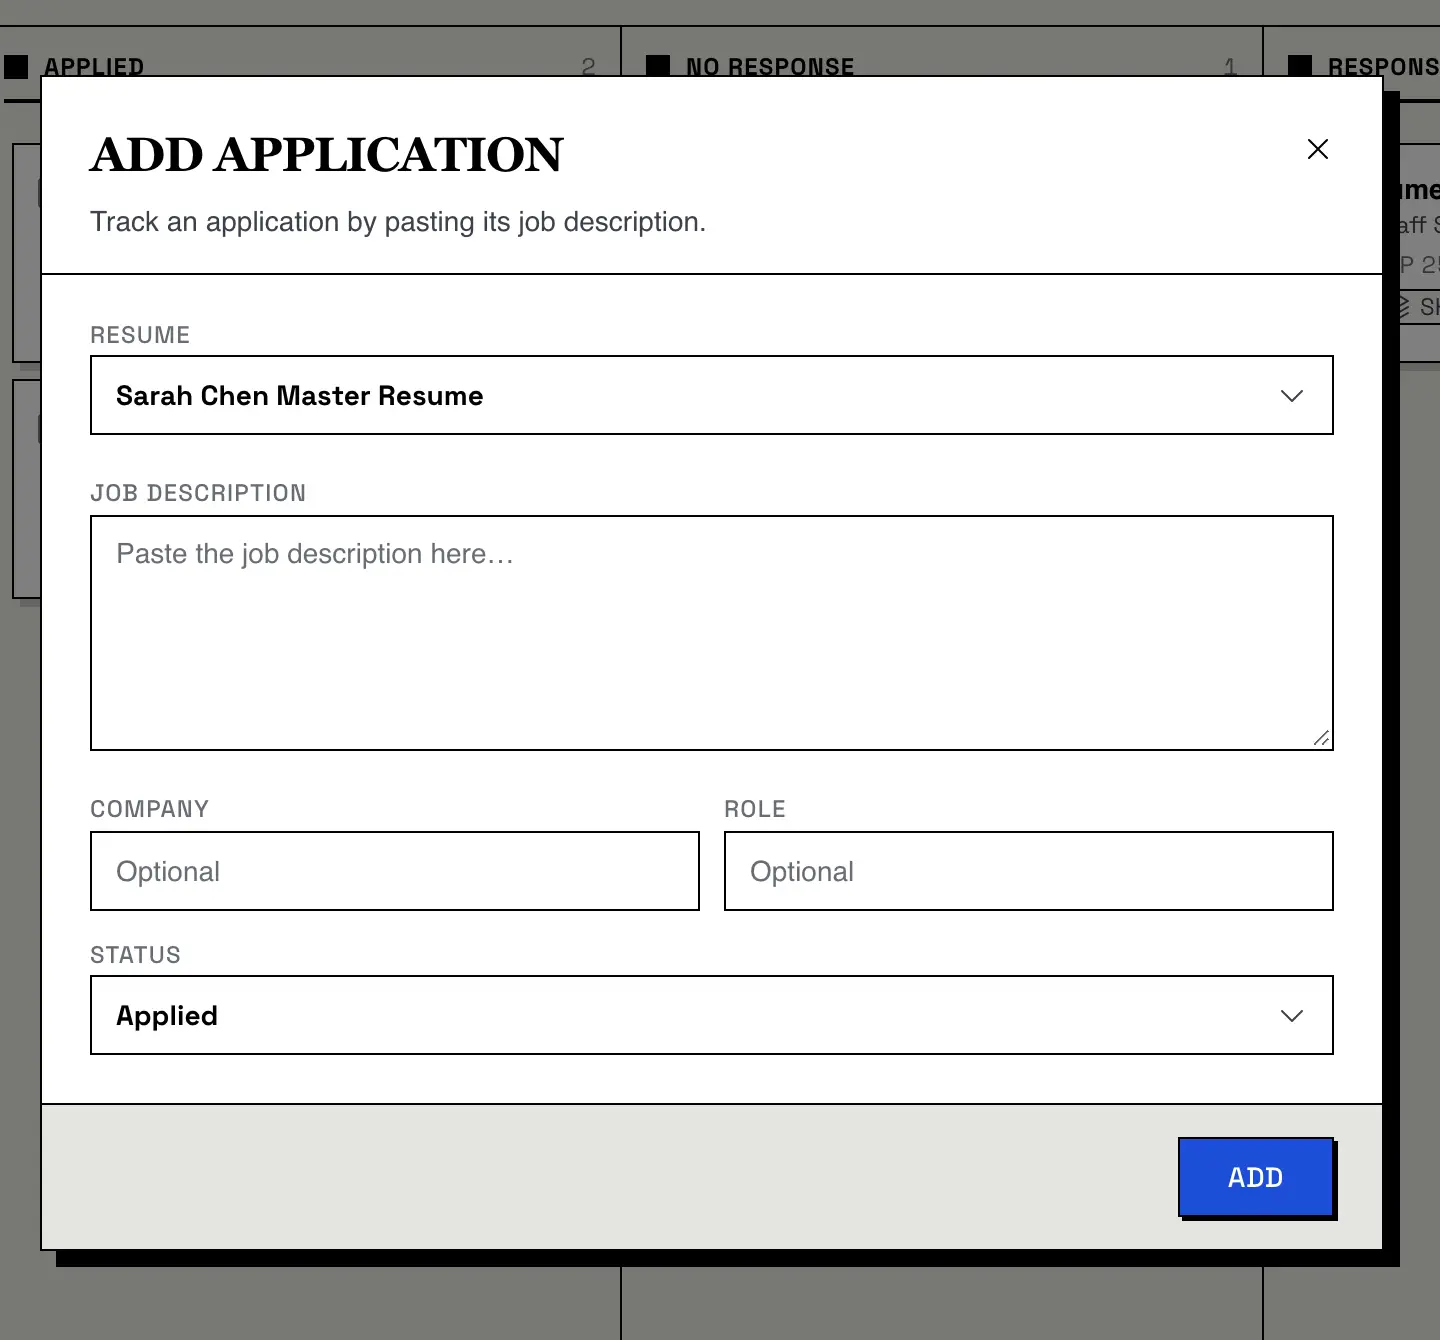
点击「添加申请」,选择一份简历,粘贴职位描述,并选择起始阶段,比如为打算以后再定制的职位选「已保存」。公司和职位是可选项:留空的话,AI 会从职位描述中提取。
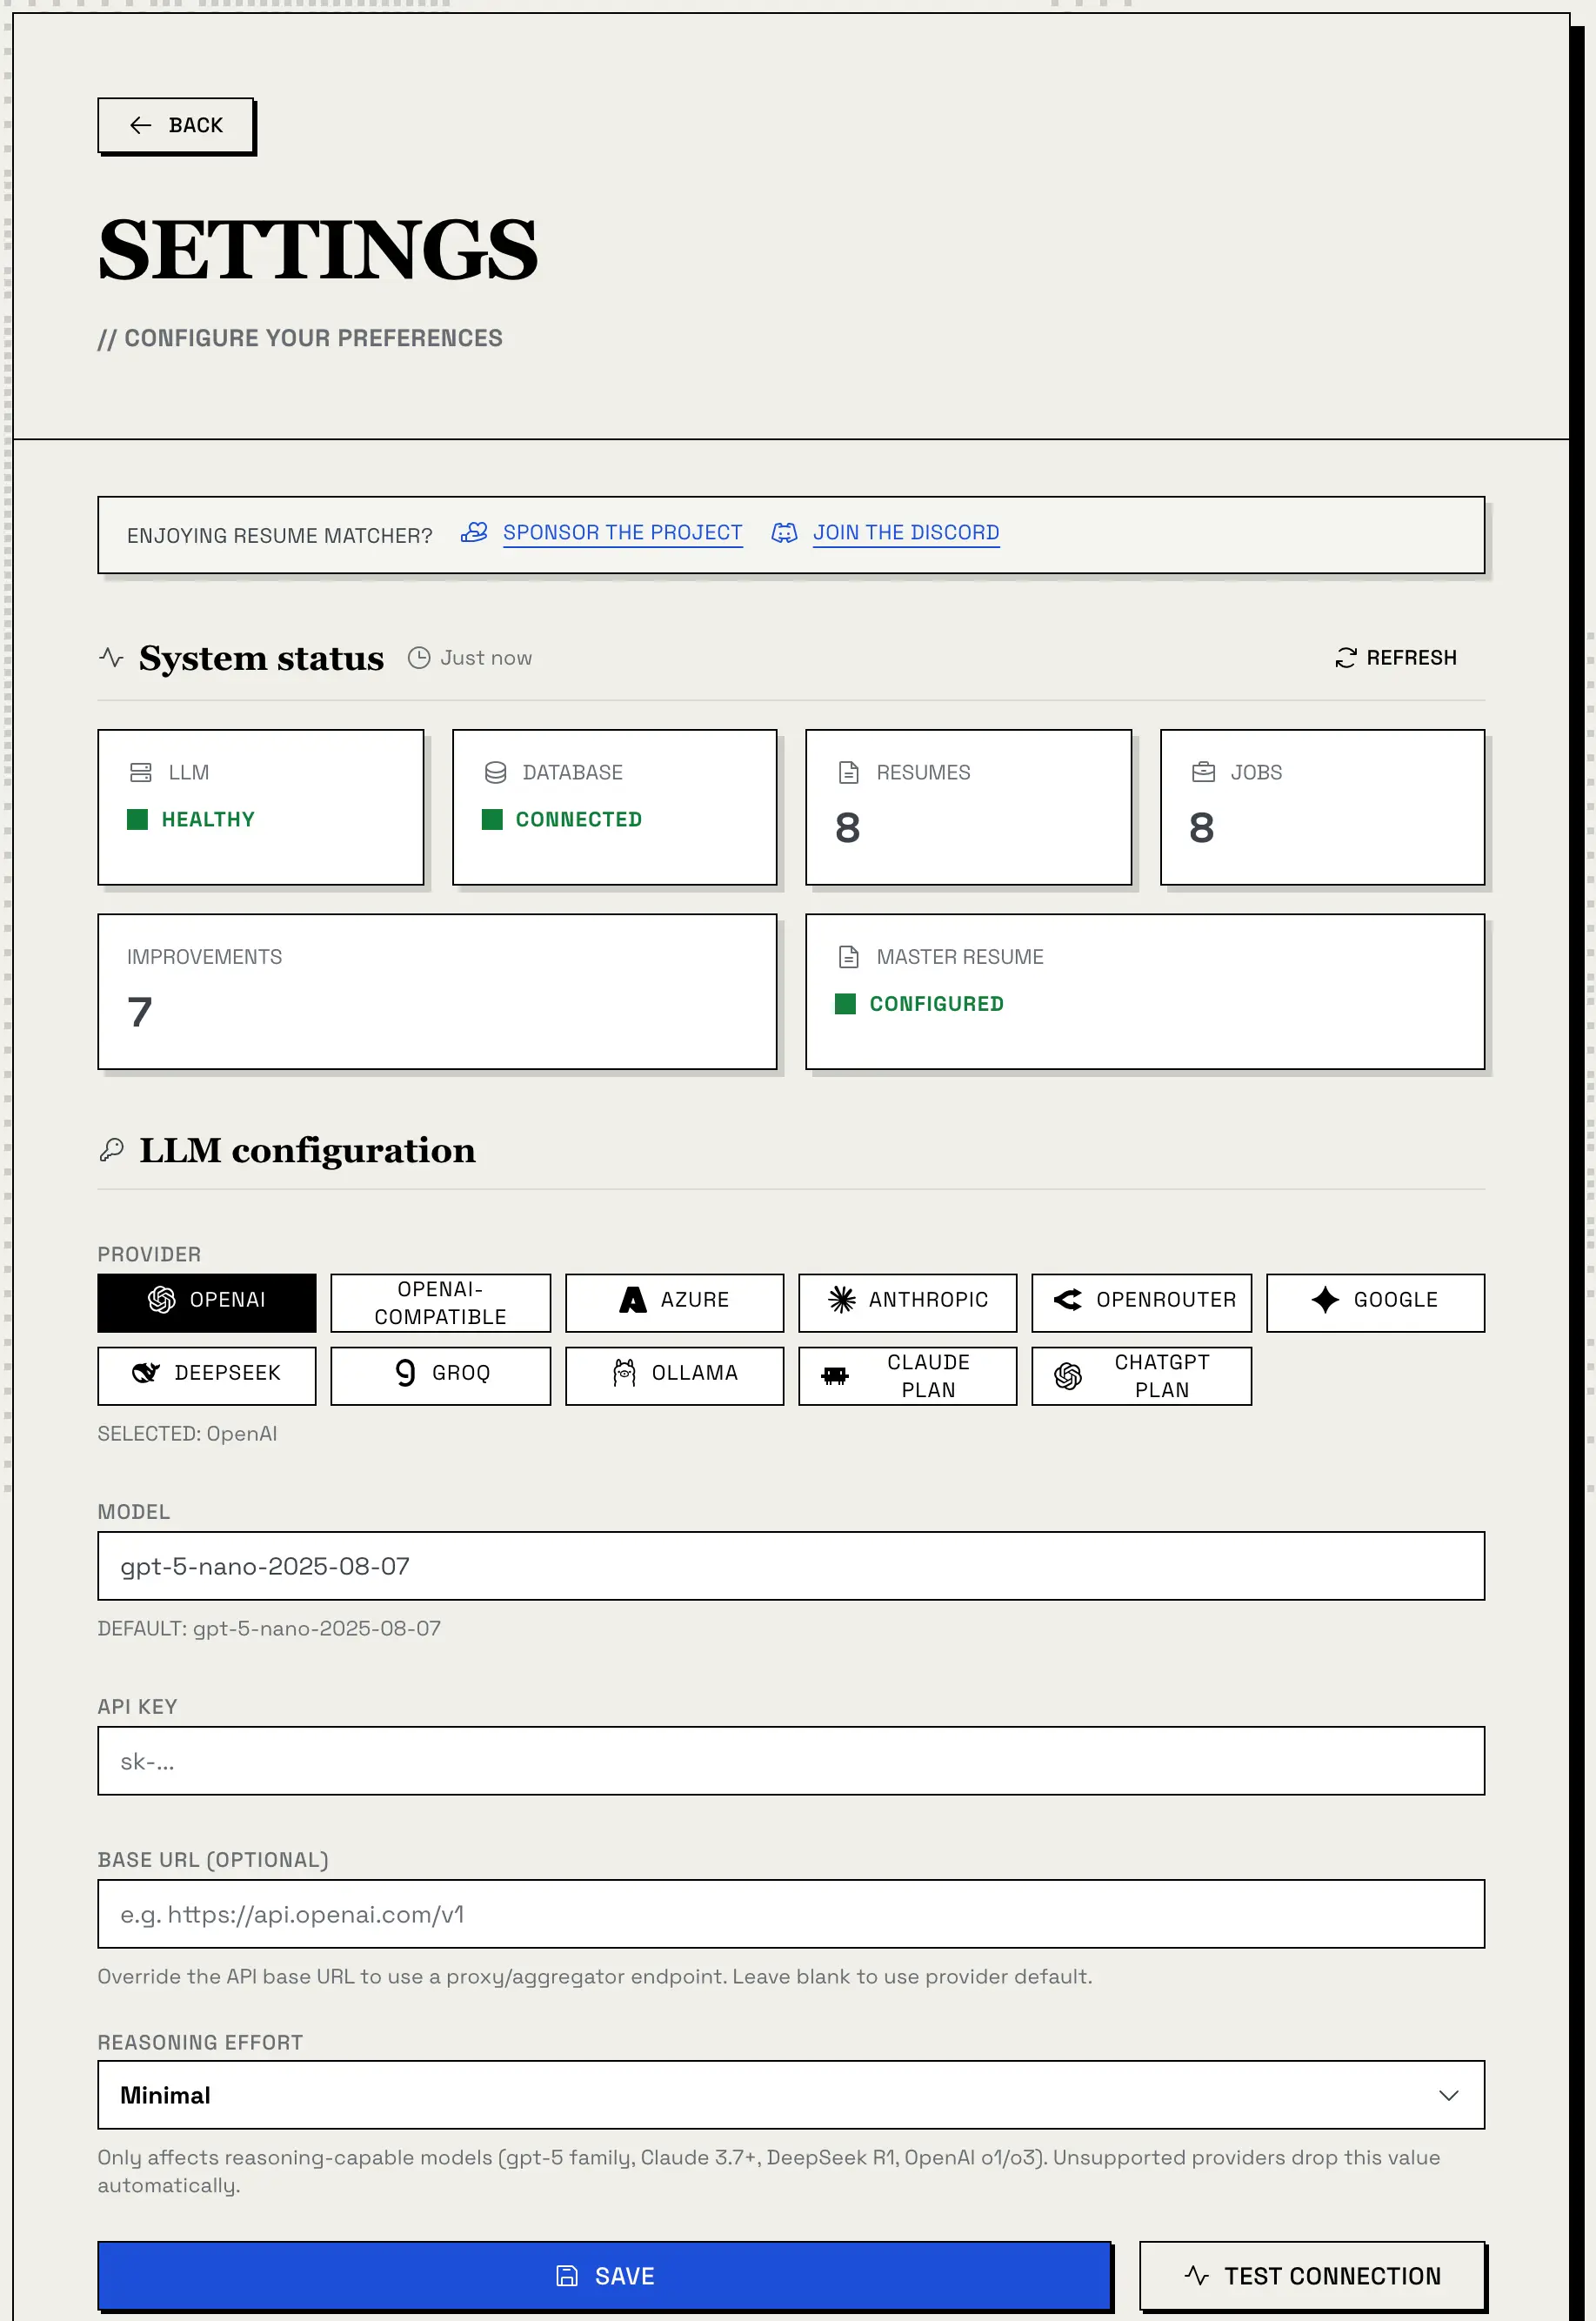
Resume Matcher 不附带 AI 模型。你自己接入一个,云端的或者本机的都行,提示词、校验和排版由应用负责。
11
种接入模型的方式:API 密钥、你自己的电脑,或你付费的订阅
7
种语言,用于界面和 AI 写作
0
行分析或追踪代码
| 服务商 | 默认模型 | 运行位置 |
|---|---|---|
| OpenAI | gpt-5-nano-2025-08-07 | 云端 |
| Anthropic(Claude) | claude-haiku-4-5-20251001 | 云端 |
| Google Gemini | gemini-3-flash-preview | 云端 |
| DeepSeek | deepseek-chat | 云端 |
| OpenRouter | deepseek/deepseek-chat | 云端 |
| Groq | llama-3.3-70b-versatile | 云端 |
| Azure AI Foundry | mistral-large-latest | 云端 |
| Ollama | gemma3:4b | 你的电脑 |
| 兼容 OpenAI 接口的服务(llama.cpp、vLLM、LM Studio) | 自行填写 | 你的电脑 |
| ChatGPT 订阅(使用 ChatGPT 登录) | 你账号里的模型 | 云端 |
| Claude 订阅(通过 Claude Code) | Claude Code 的默认模型 | 云端 |
你可以填写服务商提供的任何模型名称。没有官方规定的最低模型要求,但小模型可能处理不好定制步骤使用的结构化编辑格式。
可以在设置页面里配置(服务商、模型、API 密钥;用代理或本地服务时还要填 Base URL;先「保存」,再「测试连接」),也可以用环境变量配置,写在 apps/backend/.env 或你的 Docker 环境里:LLM_PROVIDER、LLM_MODEL、LLM_API_KEY,需要时再加 LLM_API_BASE。服务商名称用小写(anthropic、ollama)。在应用里保存的设置优先于环境变量。
{job_description}、{resume_data} 和 {output_language} 占位符即可。在设置页面里输入的 API 密钥会加密保存。每家服务商各自保存自己的密钥,所以切换服务商不会清除另一家的密钥。ChatGPT 订阅和 Claude 订阅不需要密钥;它们是社区贡献的功能,有一些注意事项,值得先读一读。
Resume Matcher 还附带一个 MCP 服务器,所以 Claude Code、Claude Desktop、Cursor 或 Codex 可以直接处理你的简历。内容由你的客户端所用的模型撰写;Resume Matcher 负责存储、校验、评分和渲染,数据存在应用自己的数据库里,它自己也不需要 AI 密钥。它需要本地安装,不支持 Docker。
英语、西班牙语、简体中文、日语、巴西葡萄牙语、法语和韩语。界面语言决定界面显示的语言;内容语言是 AI 写作所用的语言,用于定制简历、求职信、联系邮件和面试准备。两者分开设置,所以你可以用英文界面,同时写一份日文简历。PDF 内置了 Noto Sans 字体,用于中文、日文和韩文文本。
简历和求职信导出为 PDF。应用会打开一个无头 Chromium,载入简历的纯打印版本并打印出来,所以 PDF 里是真实的文本,可以被选中、复制,也能被软件读取。标题是真正的标题,双栏布局在阅读顺序上保持主要内容优先,页面与简历生成器里一致:模板、字体、间距和纸张尺寸都相同。
导出需要前端处于运行状态。本地运行时,安装 Playwright 的 Chromium(uv run playwright install chromium),或者装好 Chrome 或 Edge;Docker 镜像已包含所需的一切。
所有数据都在一个文件夹里,即 apps/backend/data/ 或 Docker 卷:resume_matcher.db 是一个 SQLite 数据库,存有你的简历、职位描述、定制版本和追踪看板(如果设置了 DATABASE_URL,则改用 PostgreSQL);config.json 存放非机密设置;还有你的 API 密钥,静态加密存储,加密用的密钥文件只有你的用户账号能读取。
只有你触发的 AI 请求会离开你的电脑,发给你选定的服务商。使用云端服务商时,发送的内容包括你的简历(连同联系方式)和职位描述。应用不含任何分析或追踪代码。启动时,AI 库(LiteLLM)会获取一份公开的模型价格表,这个请求不带你的任何数据。使用 Ollama 或其他本地模型服务,你的简历、职位描述和所有 AI 输出都留在你的电脑上。
Docker 最快。Resume Matcher 以单个容器镜像发布在 Docker Hub(它是 Docker 赞助的开源镜像,Docker-Sponsored Open Source)和 GitHub Container Registry 上,两者都为 linux/amd64 和 linux/arm64 构建。然后打开 http://localhost:3000/settings 接入模型。
想从仓库构建,就克隆仓库并用 Docker Compose 启动:先 git clone,再 docker compose up -d。
resume-data 卷保存你的数据库和设置,所以升级容器后数据仍在。要获得可重复的部署,请固定一个版本(例如 :1.3.0)。如果想从源码运行,你需要 Python 3.13+、Node.js 22+、npm 和 uv。
$ git clone https://github.com/srbhr/Resume-Matcher.git$ cd Resume-Matcher$ docker compose up -d$ docker run --name resume-matcher -p 3000:3000 \ -v resume-data:/app/backend/data \ srbhr/resume-matcher:latest# 然后打开 http://localhost:3000/settings
它不是托管网站。你自己运行它,在本地或者 Docker 里。它为单个用户设计。
它不会替你投递申请。也不连接招聘网站或雇主的系统。追踪看板只是你自己的记录。
它不能预测 ATS 会给你怎样的排名。ATS 检查测试的是文本能否从它自己生成的 PDF 中读回来,评分则是关键词和板块的启发式计算。它们都不模拟任何雇主的软件。
它不会凭空写简历。它基于你上传的简历,或你在向导里的回答。
它读不了扫描版 PDF。文件需要有文本层。
它只导出 PDF。Word 文件只能作为输入,不能作为输出。
后端、前端、SRE 还是机器学习:粘贴你想投的下一个职位,投出一份与它技术栈对口的简历。免费开源,在你自己的电脑上运行。